Habr AI
Source d'actualités IA. Les articles sont sélectionnés et adaptés par la rédaction de Hamidun News.
Dernières publications
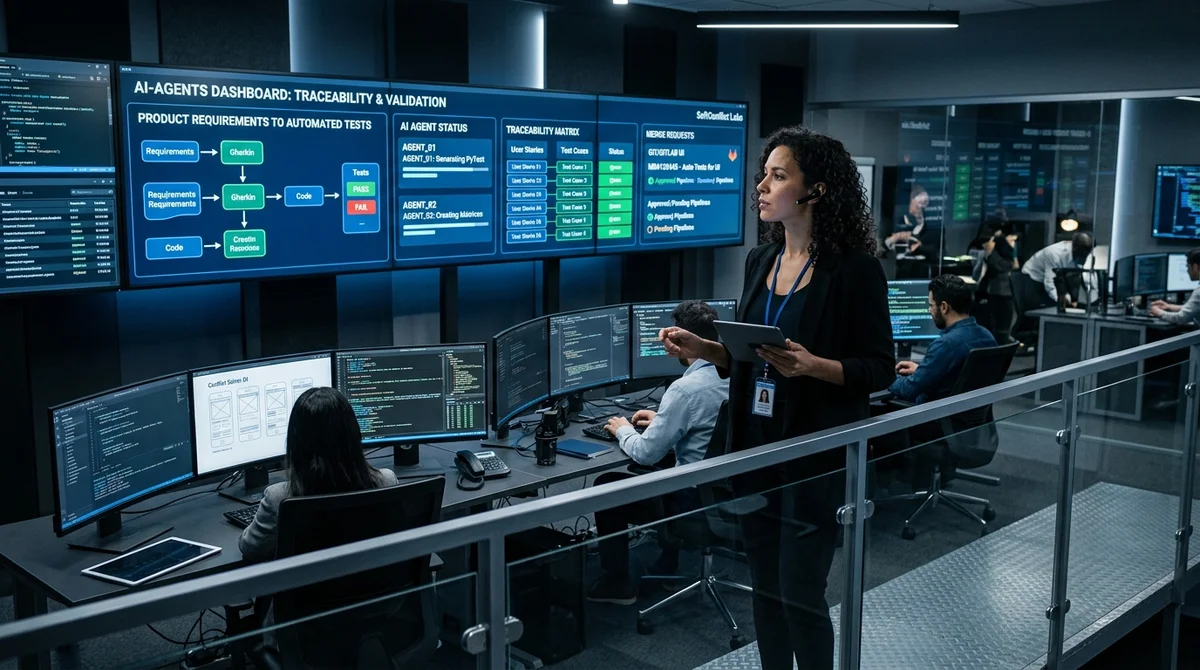
Claude Code et 11 agents : comment une équipe QA a automatisé jusqu'à 80 % de la routine de test
Une équipe QA a bâti un système de 11 agents IA sur Claude Code qui transforme une tâche Jira en cas de test, tests automatisés et Merge Request en quelques heures plutôt qu'en plusieurs jours.
Pourquoi les LLM mentent et oublient des faits : comment fonctionne la mémoire des modèles de langage
Les modèles de langage ne stockent pas des faits comme une base de données : ils génèrent du texte plausible. Quatre raisons pour lesquelles les LLM hallucinent et oublient.
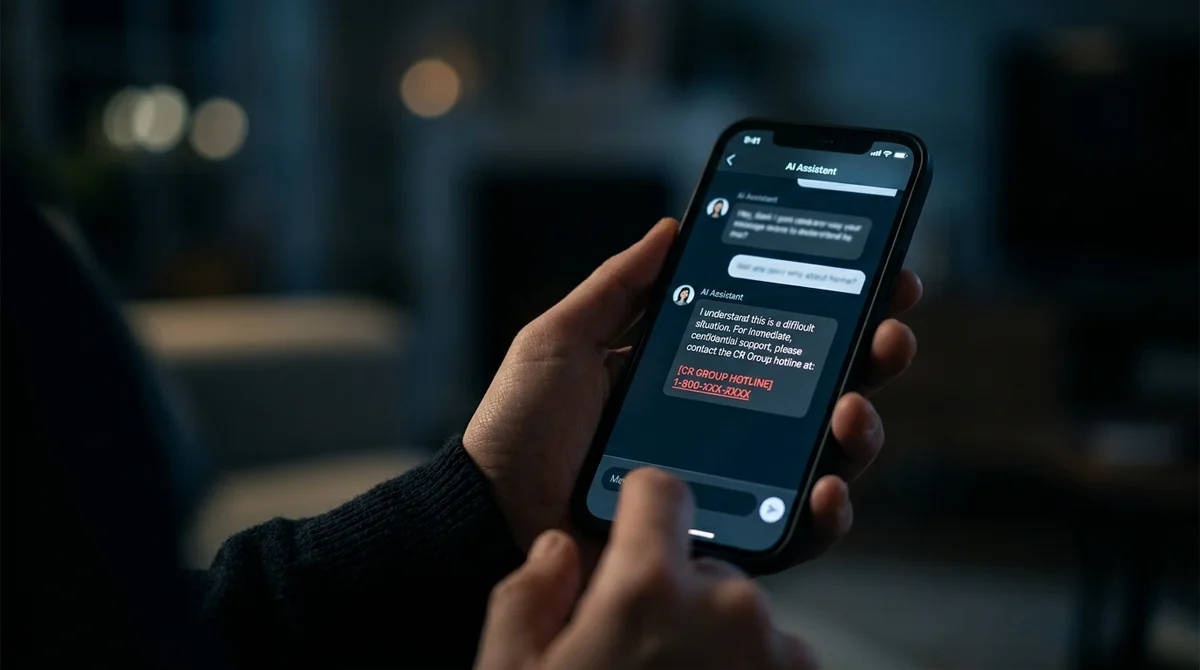
Un LLM a inventé un numéro d'écoute : pourquoi un prompt ne protège pas des hallucinations
Un modèle de langage a donné à une jeune femme en détresse le numéro d'une ligne pour enfants au lieu de celui d'un centre de crise. L'interdiction dans le prompt n'a rien changé : il faut revoir l'architecture.
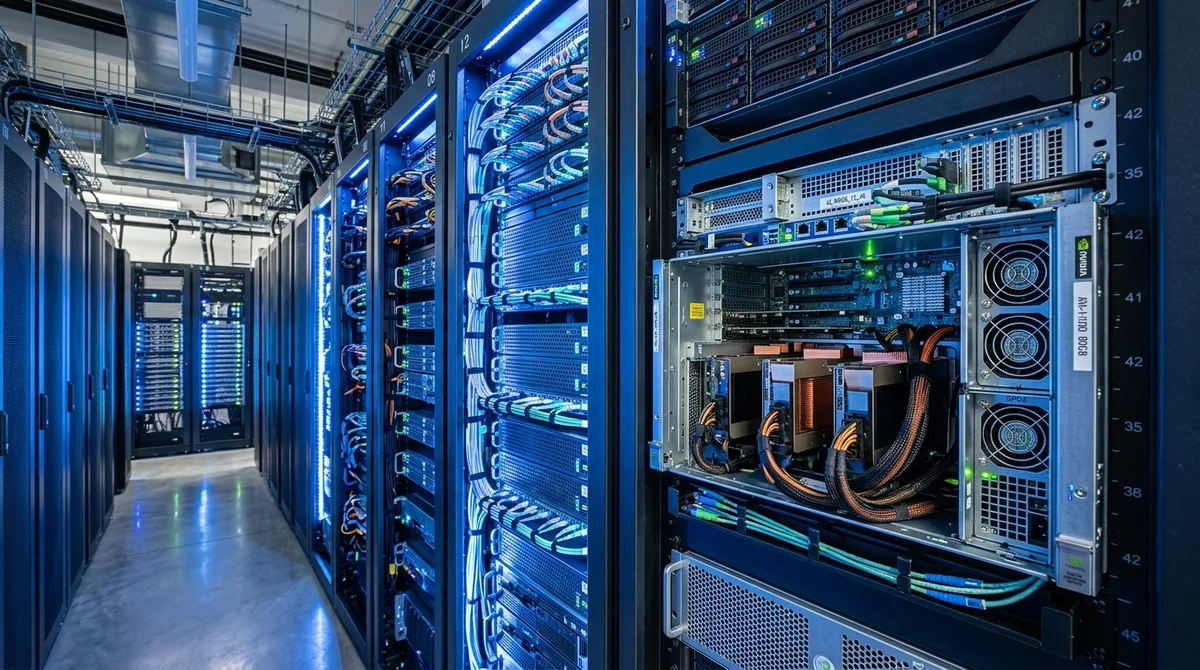
T1 Cloud : H200 et L40S, revue technique des GPU pour l'IA générative
T1 Cloud publie une revue technique de ses serveurs GPU H200 et L40S, photos du datacenter à l'appui, et explique comment choisir l'accélérateur adapté à ses besoins en IA.

NVIDIA Nemotron 3 Super 120B : test sur des tâches analytiques réelles avec un seul GPU
L'équipe de Luxms BI a testé pendant une semaine NVIDIA Nemotron 3 Super 120B sur de vraies tâches d'analyse d'entreprise : 120B de paramètres et 256K tokens de contexte sur une seule carte graphique.
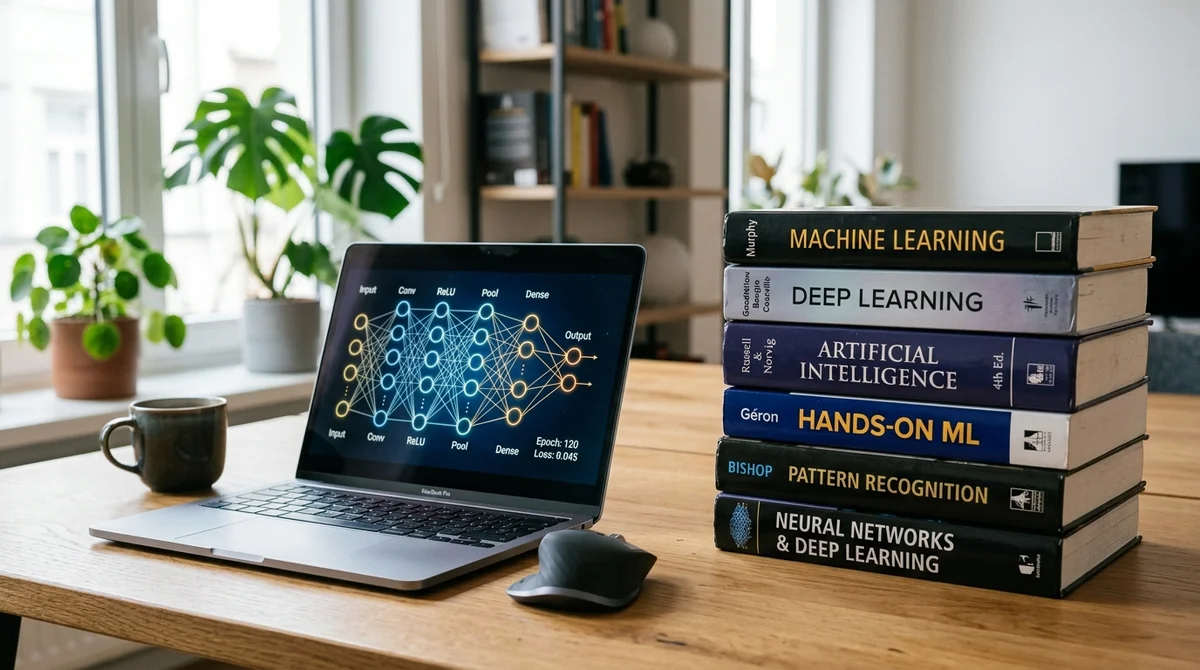
Un best-seller international sur les grands modèles de langage paraît en russe
Les éditions BHV publient la traduction d'un best-seller international sur les LLM, un guide pratique pour les développeurs qui veulent comprendre et déployer ces modèles.

PSB dévoile comment il déploie l'IA dans la banque : chatbots, RAG et services pour les entreprises
PSB détaille son usage de l'IA générative pour les PME et ses employés : l'assistant Katyusha, des consultations RAG, des paiements en messagerie et des pilotes internes pour les ventes.
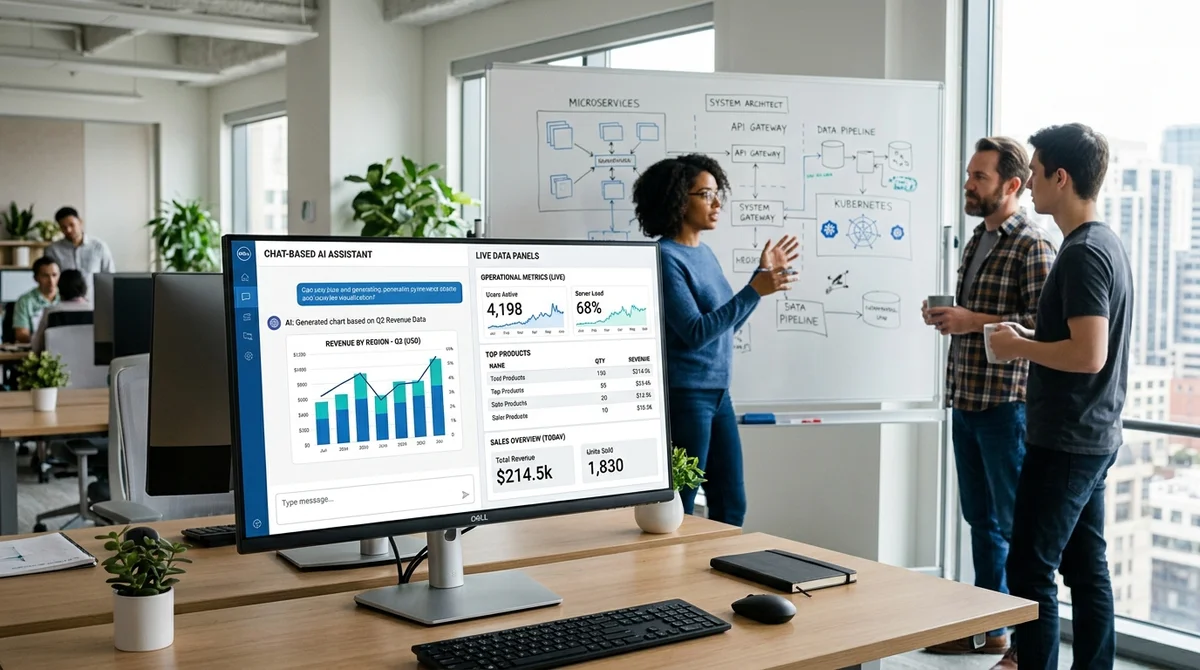
Yandex Cloud explique pourquoi le frontend pilote l'intégration des réseaux de neurones dans DataLens au démarrage
À travers DataLens, Yandex Cloud montre comment confier la première couche d'intégration de l'IA à un BFF côté frontend, pour lancer plus vite un assistant de chat et gérer le contexte au plus près de l'interface.
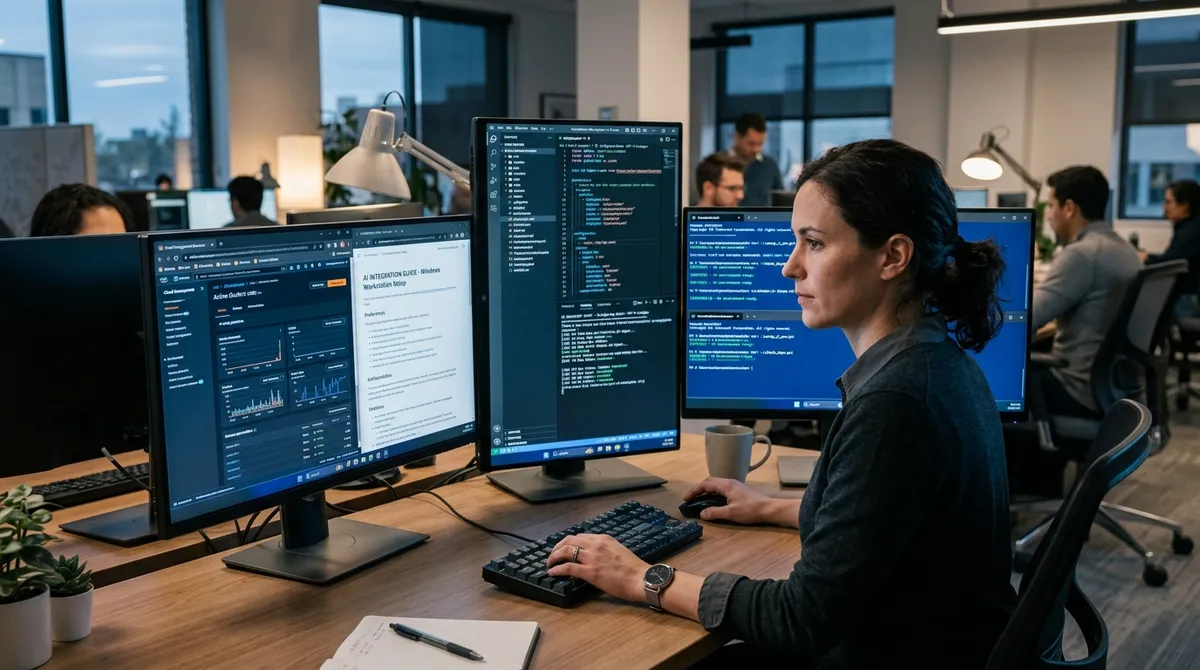
Claude Code sous Windows : comment monter un environnement de travail stable et rapide
Un ingénieur d'une équipe AWS gérant plus de 150 comptes explique comment rendre Claude Code stable et rapide sous Windows sans passer à Linux, avec les réglages d'avril 2026.
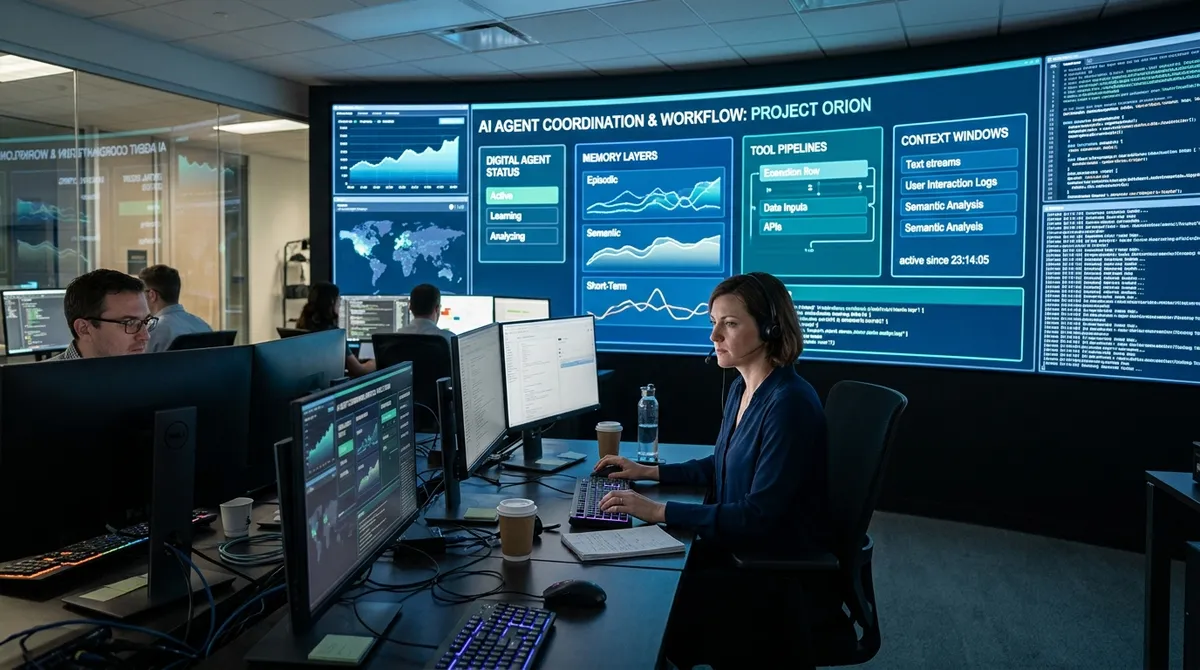
Anthropic, OpenAI et LangChain expliquent pourquoi les agents d'IA ont besoin d'un harness
Anthropic, OpenAI et LangChain déplacent l'attention des modèles vers l'agent harness : la couche d'orchestration, de mémoire et d'outils qui stabilise les agents d'IA en production.
Anthropic et d'autres modèles de langage peuvent appeler des outils cachés sans autorisation
Un chercheur décrit une faille : Anthropic, Gemini et Grok peuvent appeler un outil non autorisé s'il existe dans l'environnement et que le contrôle du nom côté API ou client est laxiste.
Le groupe fintech Svoi explique comment rendre les agents LLM moins chers et plus précis pour coder
Le groupe fintech Svoi a publié un guide pratique pour passer d'un LLM utilisé comme "moteur de recherche amélioré" à un agent maîtrisé, réduire les coûts en tokens et gagner en précision.
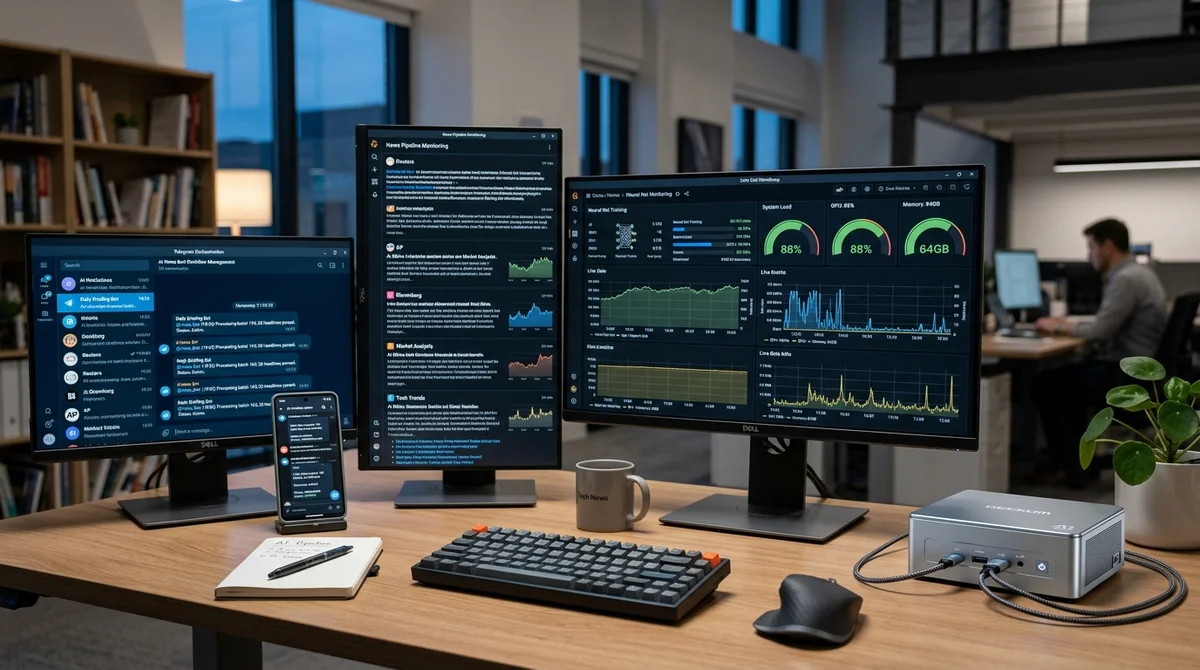
Comment un auteur de Habr a transformé sept scénarios n8n en système autonome d'actualités IA
En un mois et demi, l'auteur a transformé un fragile ensemble de sept scénarios n8n en un unique pipeline Python avec 11 workers, 5 agents IA, un LLM local et un pilotage via Telegram.
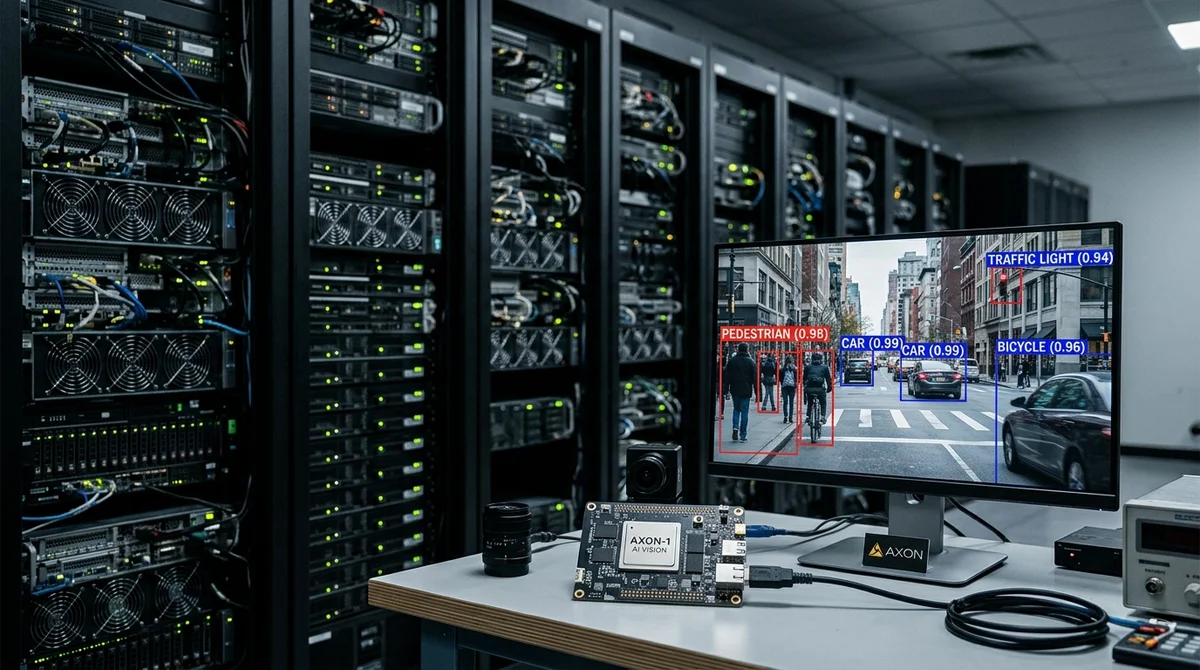
TAPe égale RF-DETR et YOLO en détection sur COCO avec un modèle de moins de 100 000 paramètres
Les auteurs de TAPe affirment que leur détecteur atteint le niveau de RF-DETR et YOLO sur COCO avec moins de 100 000 paramètres et 7–8 ms par image, en allégeant données et matériel.
Pourquoi OpenCode et les modèles performants écrivent des tests verts mais inutiles, et comment y remédier
Un modèle récent et un agent puissant comme OpenCode ne suffisent pas si la base de code regorge de any et que l'équipe demande simplement à l'IA d'écrire des tests, sans spécification, contraintes ni vérification.
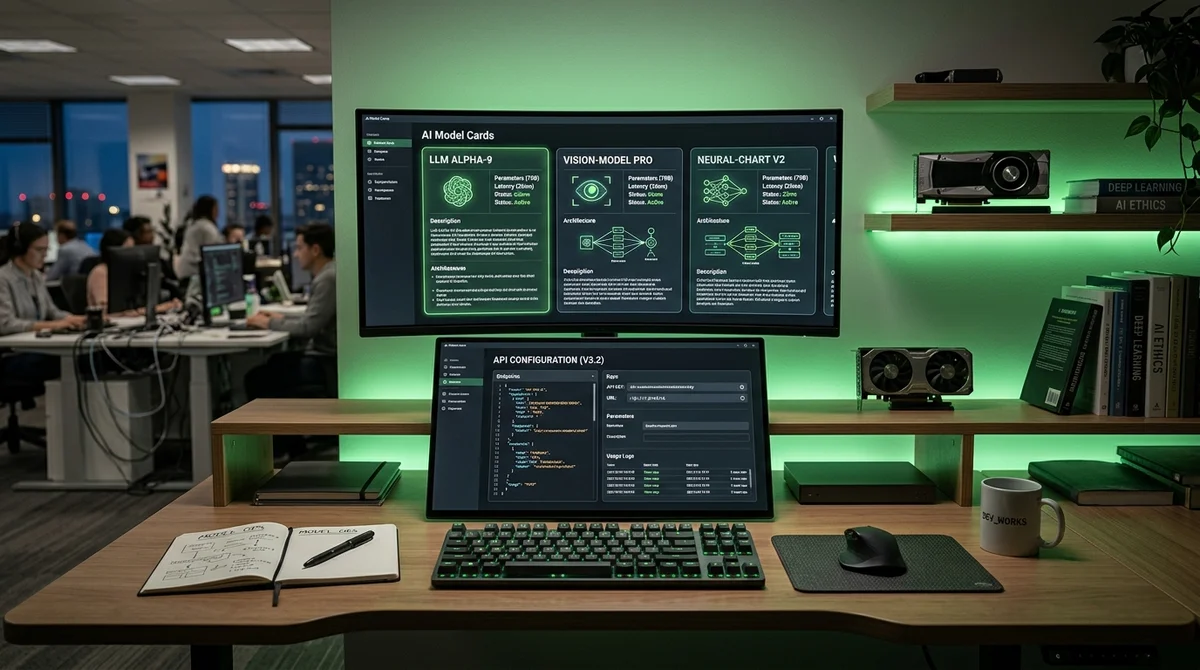
NVIDIA ouvre une API gratuite à plus de 100 modèles d'IA, compatible avec OpenAI
NVIDIA distribue des clés gratuites pour plus de 100 modèles d'IA : les développeurs obtiennent une API compatible OpenAI, une limite de 40 requêtes par minute et un accès sans carte bancaire.
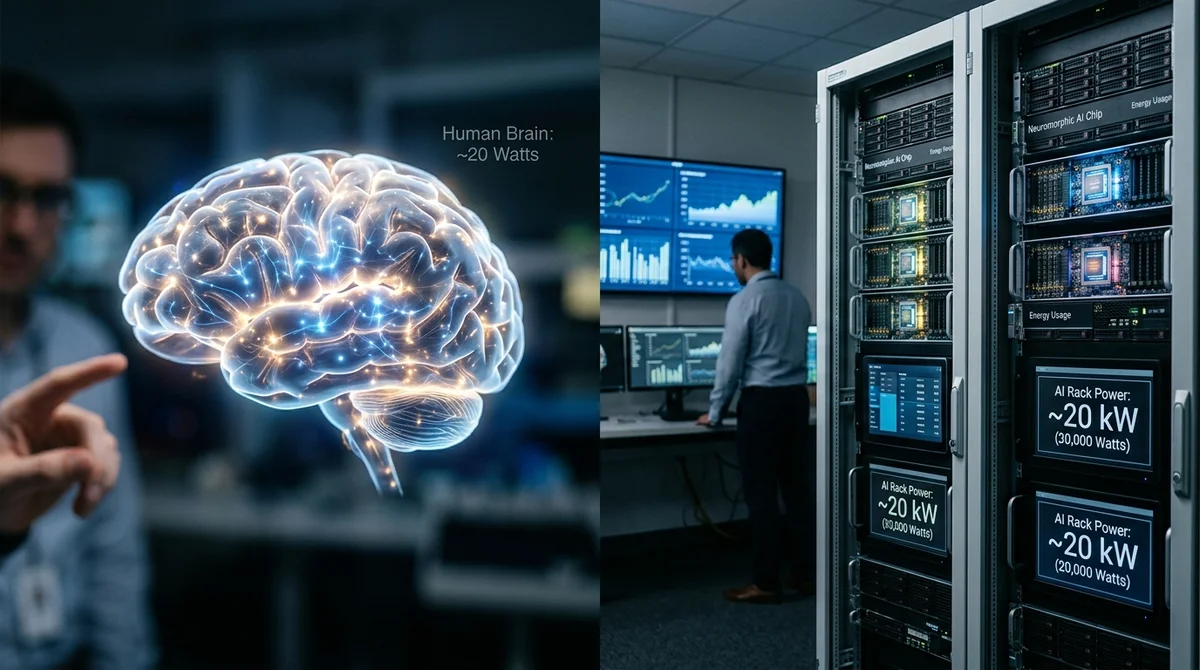
Pourquoi le cerveau est des centaines de millions de fois plus efficace que GPT-4, et où vont les puces neuromorphiques
L'auteur explique pourquoi le cerveau humain dépense des ordres de grandeur d'énergie en moins que GPT-4 pour des tâches cognitives, et comment les puces neuromorphiques tentent de réduire cet écart.
Étude sur ChatGPT : la forme féminine d'un prompt influe-t-elle sur la qualité des réponses ?
Une expérience menée sur LiveCodeBench montre qu'avec GPT-5.4 mini, une présentation au féminin dans un prompt en russe fait légèrement baisser le pass@1, surtout sur les tâches difficiles.
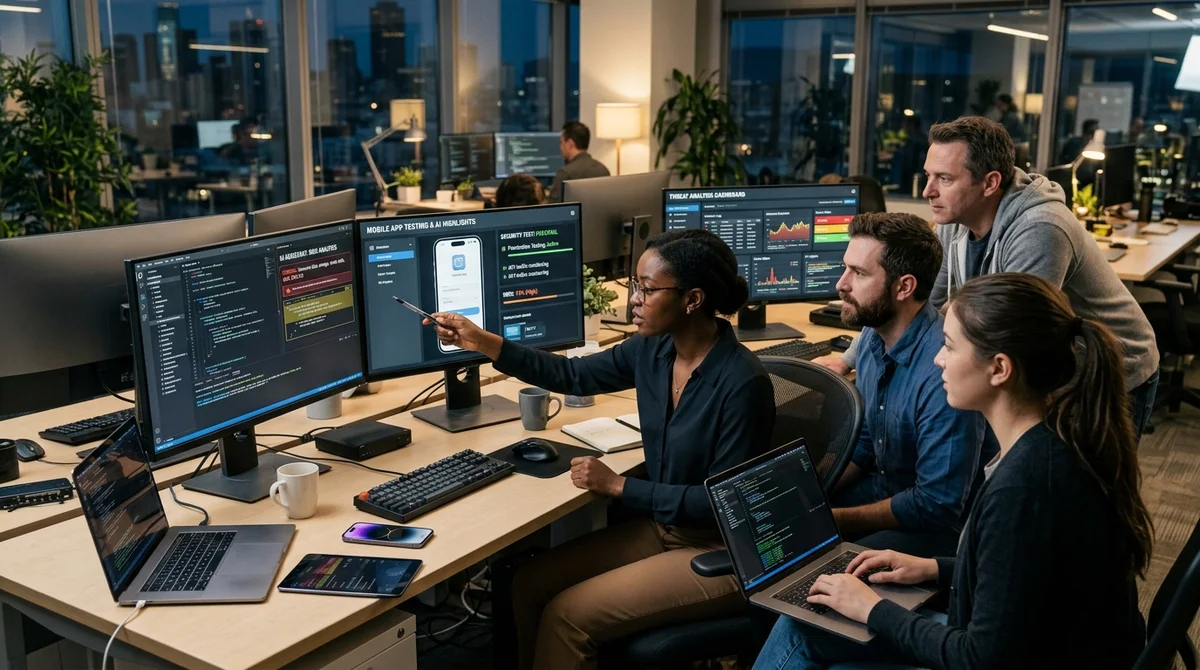
RuStore intègre l'IA à la sécurité informatique : comment VK automatise la revue des tâches, du code et les contrôles DAST
L'équipe sécurité de RuStore utilise l'IA pour le premier tri des tâches de sécurité, le contrôle des merge requests et les tests dynamiques, afin de décharger les ingénieurs et d'accélérer le cycle de livraison.
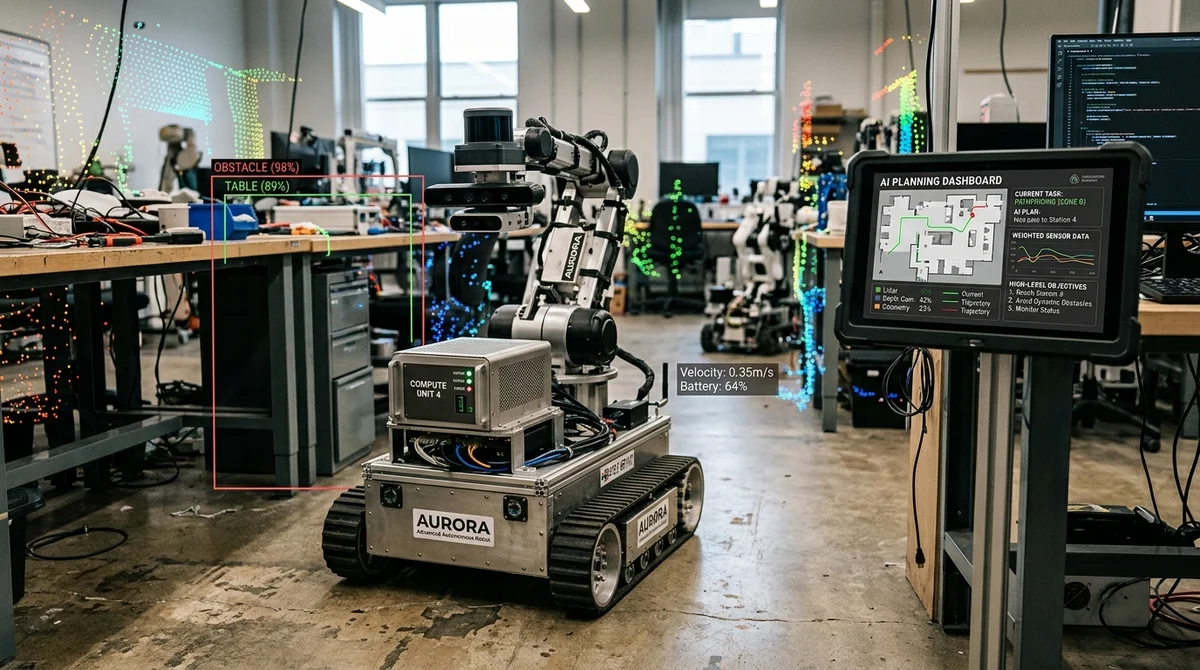
OpenGrall dévoile une architecture pour robots dotés d'IA où le modèle de langage gère la stratégie
Le framework OpenGrall sépare réflexion et contrôle : le LLM s'occupe de la stratégie, TinyML de l'exécution et de la sécurité, ce qui réduit la latence même sur du matériel modeste.
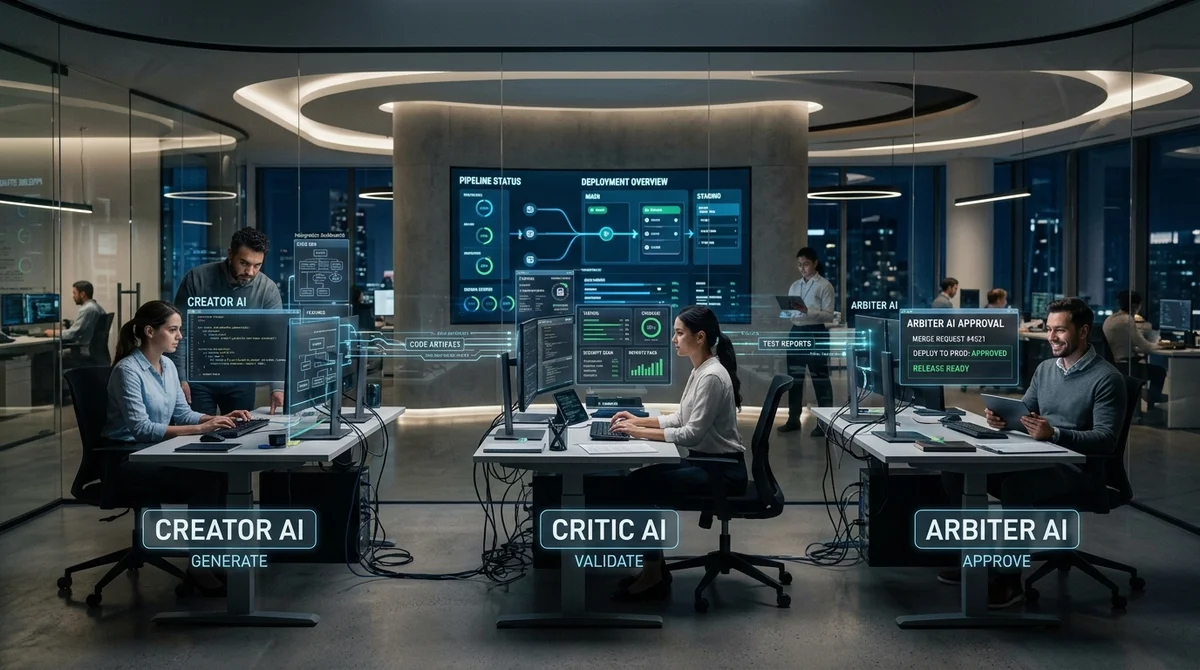
Habr AI : comment Pipeline Triad monte un pipeline d'agents IA à la place d'une équipe de développement
Habr AI décortique Pipeline Triad, un modèle où les étapes du développement passent par des trios d'agents IA et où l'humain n'intervient qu'à quatre points de contrôle.
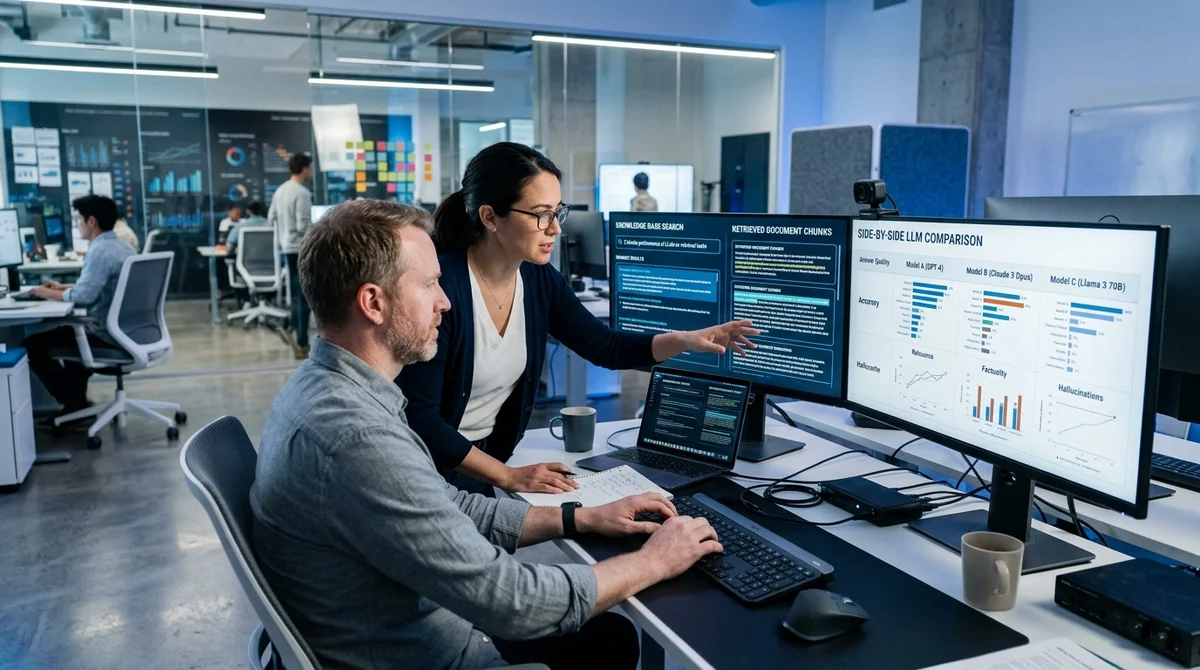
Gramax montre comment comparer la qualité des réponses d'un RAG sans les juger « à l'œil »
Gramax explique pourquoi les métriques de retrieval ne suffisent pas pour un RAG et propose d'évaluer la réponse finale de l'utilisateur, non les chunks trouvés, sur sa complétude, sa précision et sa stabilité.
Guardrails pour LLM en Java : comment bloquer les injections de prompt et les réponses toxiques
Un system prompt ne suffit pas à protéger un LLM : en Java, des guardrails interceptent les entrées dangereuses et filtrent les sorties toxiques ou indésirables du modèle.
Anthropic et le modèle Mythos : comment le danger pour les banques est vite devenu un risque pour tous
Anthropic a présenté Mythos comme trop dangereux pour un accès ouvert, mais le risque principal n'est pas dans les banques : les petites entreprises ne corrigent pas leurs failles avant les attaques.
Anthropic et Claude Mythos : pourquoi les critiques voient dans le lancement du modèle un coûteux spectacle de communication
Selon une tribune critique, Anthropic ne vend pas seulement un modèle d'IA avec Claude Mythos, mais aussi le mythe de sa nature quasi humaine, qui attise la rareté et la demande des entreprises.
Assistants IA en 2026 : comment un développeur solo est devenu plus rapide qu'une équipe de trois
Selon l'auteur, en 2026, un développeur seul équipé d'outils IA open source peut écrire, tester et commiter du code plus vite qu'une petite équipe deux ans plus tôt.
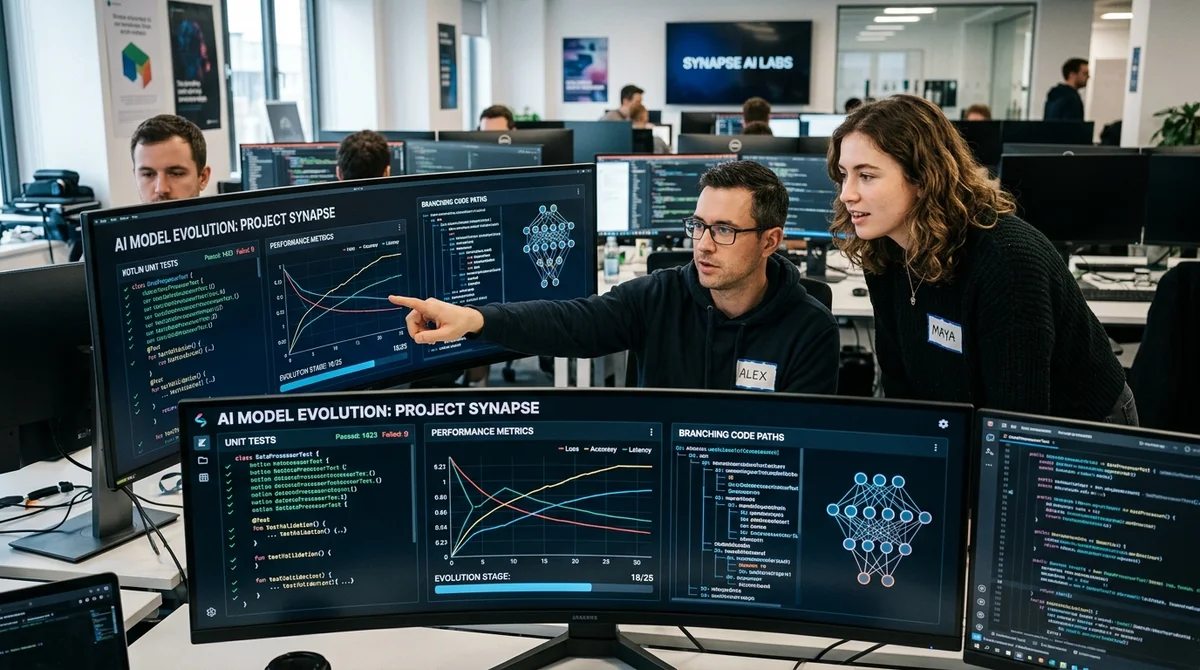
ecom.tech compare le fine-tuning évolutif de Qwen3-4B au SFT et au GRPO pour des tests Kotlin
ecom.tech a affiné Qwen3-4B-Instruct pour générer des tests unitaires en Kotlin et montre qu'un algorithme évolutif bat le SFT et le GRPO sur les métriques de qualité, mais dégrade les capacités générales du modèle.
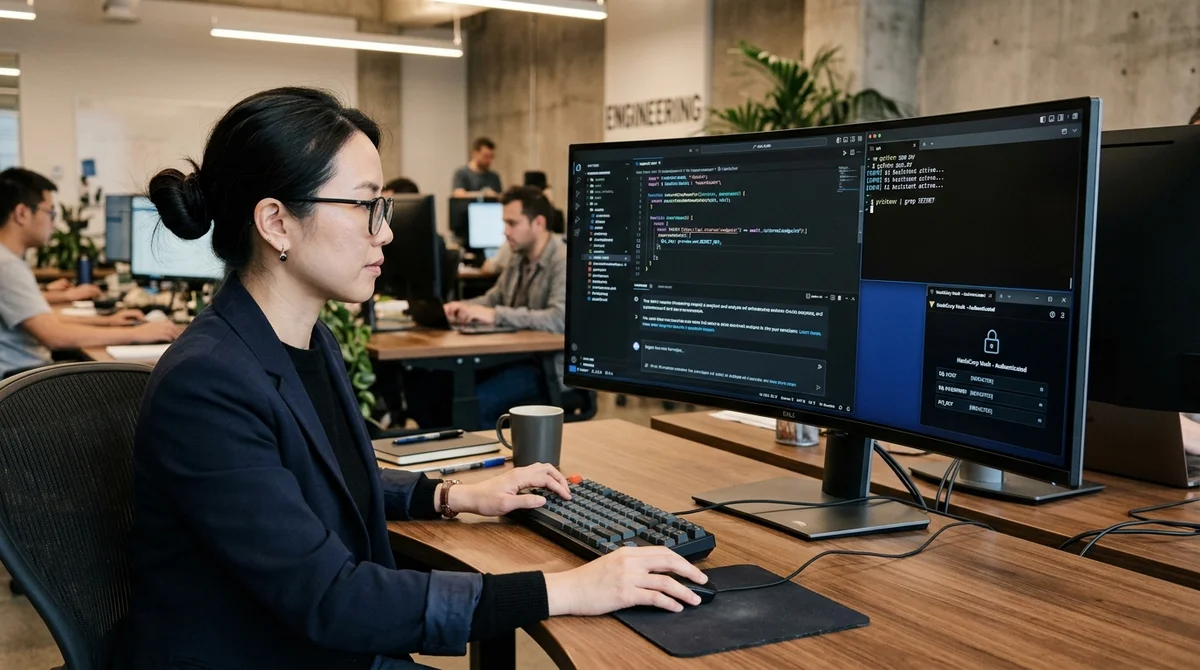
Yandex Code Assistant testé sur une tâche de gestion des secrets et comparé à Cursor
Un ingénieur d'Infosystems Jet a testé Yandex Code Assistant sur le stockage de secrets : l'agent se rapproche de Cursor, mais exige encore le contrôle du développeur.
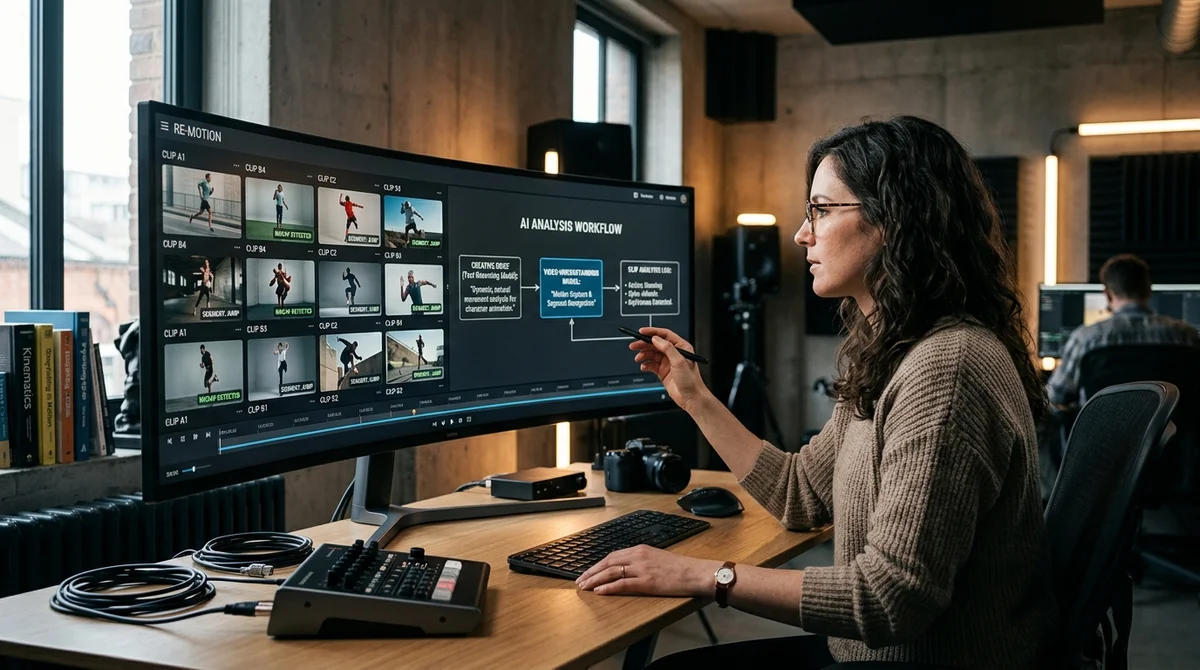
Claude et Qwen Omni : comment un développeur a branché l'analyse vidéo sur un pipeline de travail
Un auteur de Habr a associé Claude à Qwen Omni pour contourner l'absence de prise en charge directe de la vidéo et classer automatiquement 29 références d'animation par mouvement et par catégorie.
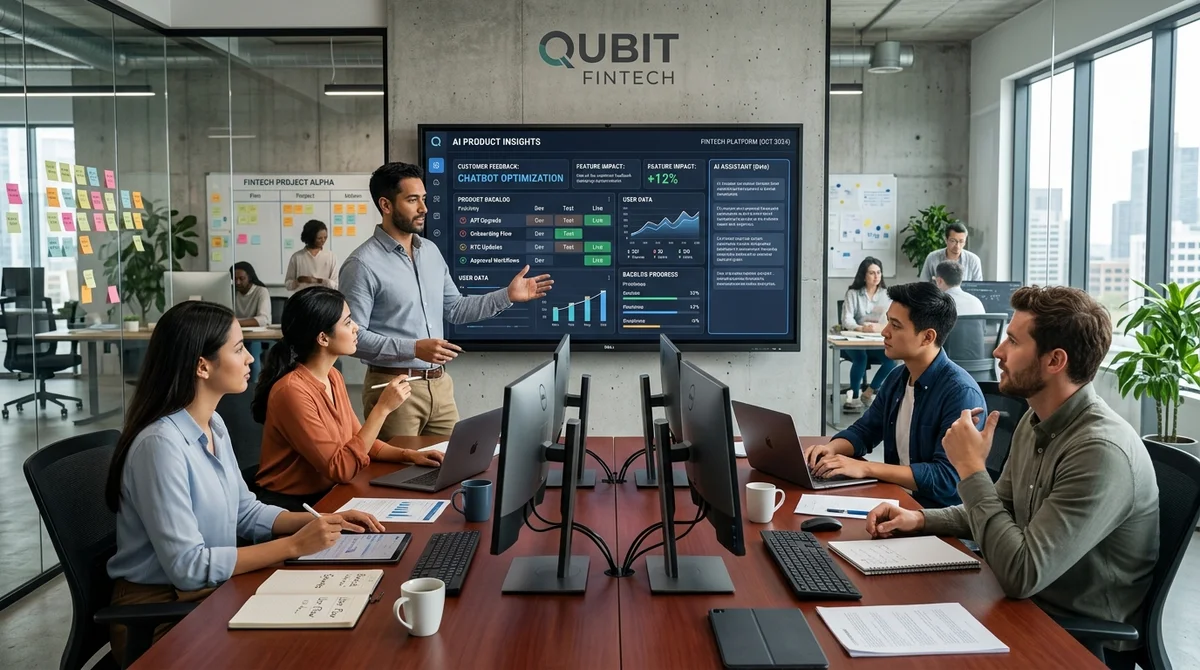
Comment Sovcombank a réduit de 50 % la routine de son équipe produit grâce à un assistant IA
Sovcombank a construit un assistant IA fondé sur un LLM et un prompt unique pour décharger les product managers de la documentation, des validations et d'une partie de l'analyse, libérant jusqu'à la moitié de leur temps.