Claude et Qwen Omni : comment un développeur a branché l'analyse vidéo sur un pipeline de travail
Un développeur a montré comment faire de Claude un outil pratique d'analyse vidéo en le connectant à Qwen Omni. Plutôt que de découper la vidéo en images, ce qui fait perdre le mouvement, ce duo de modèles a décrit et classé automatiquement 29 références d'animation d'un personnage. L'intérêt concret est simple : la solide logique de Claude peut être complétée par une couche multimodale externe, ce qui épargne une heure à une heure et demie de routine manuelle.
Traité par IA depuis Habr AI ; édité par Hamidun News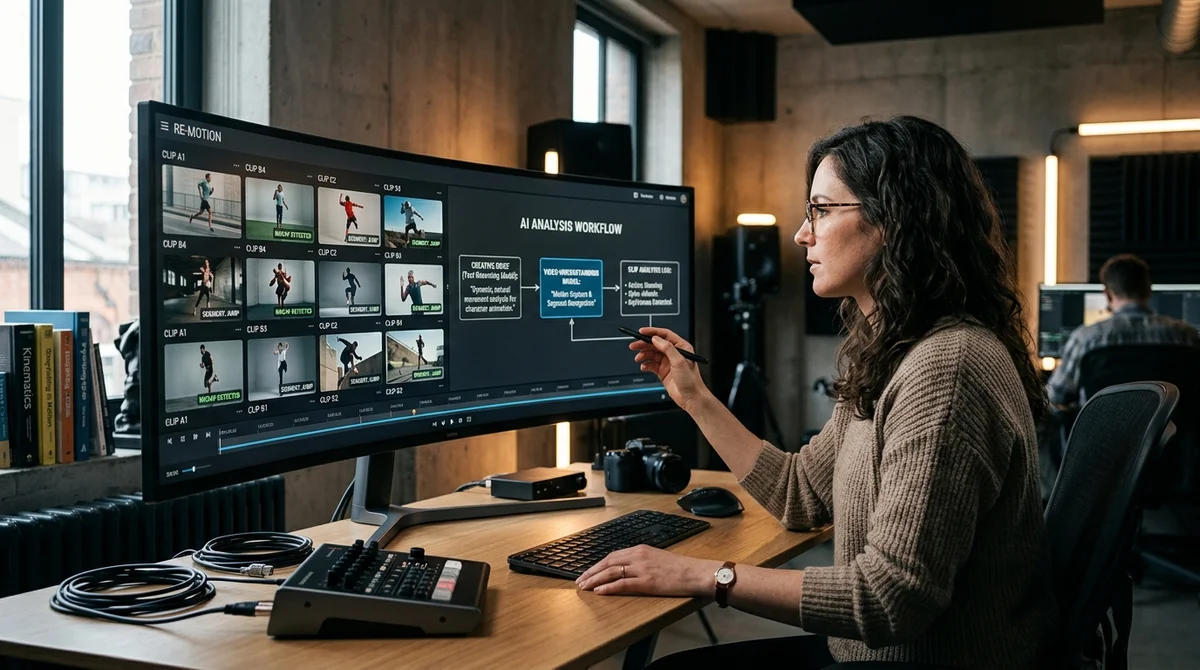
Dans une nouvelle publication sur Habr, un développeur présente une méthode simple mais utile pour étendre les capacités de Claude sur des tâches qui exigent d'analyser de la vidéo plutôt que des images isolées. Au lieu d'attendre qu'Anthropic prenne en charge nativement les vidéos, il a monté une chaîne de deux modèles : Qwen Omni assure la perception multimodale, tandis que Claude s'occupe de l'analyse, de la structuration et de la rédaction du résultat. Dans la pratique, cela a transformé une corvée manuelle en pipeline automatisé, qui fait gagner du temps et conserve mieux le contexte du mouvement.
Le problème qu'il a rencontré est bien connu de ceux qui travaillent sur l'animation, le motion design et les références visuelles. Si l'on découpe une vidéo en images et qu'on les envoie une à une au modèle, on perd l'essentiel : le lien entre les états, le rythme, la trajectoire de la caméra, les transitions entre les poses et le dessin d'ensemble de l'action. Pour des scènes statiques, ce contournement reste tolérable, mais pour l'analyse du mouvement, il atteint vite ses limites.
Pour des tâches comme décortiquer des techniques de cadrage, synchroniser des gestes, suivre les changements de plan et évaluer le design final d'un personnage, ce compromis est presque inutile. Le modèle voit un ensemble d'images, pas un événement cohérent, et l'humain doit quand même reconstituer le sens à la main.
La tâche concrète était très pratique : le dossier du projet contenait 29 vidéos de référence générées, montrant l'animation d'un personnage, qu'il fallait répartir par catégories et décrire brièvement du point de vue du mouvement. Le faire à la main aurait pris à l'auteur environ une heure à une heure et demie, pour un travail à faible valeur ajoutée : ouvrir le fichier, le regarder, identifier le type de mouvement, noter la description, passer au suivant. Pour les créatifs, cette routine est particulièrement pénible, car elle consomme du temps non pas pour créer, mais pour inventorier un matériau déjà créé.
La solution est venue de Qwen Omni, que l'auteur utilisait déjà dans un autre projet : un assistant numérique incarné par un personnage, fonctionnant en temps réel. L'idée s'est avérée logique : si un modèle comprend bien les entrées multimodales et qu'un autre excelle dans l'interprétation et la production d'un texte soigné, on peut les relier dans un même flux de travail. Dans ce schéma, Qwen Omni reçoit d'abord la vidéo, en extrait des caractéristiques pertinentes et une description de ce qui se passe ; Claude utilise ensuite ce matériau comme base pour une catégorisation plus pratique, des comparaisons et des conclusions rédigées.
On obtient alors non pas un simple résumé brut, mais des descriptions homogènes, des listes, des étiquettes et de courtes conclusions pour chaque clip du dossier. Il ne s'agit pas d'une transformation « magique » de Claude en véritable modèle vidéo, mais d'une composition pratique d'outils spécialisés.
Du point de vue de l'ingénierie, c'est l'approche qui compte. Plutôt que de chercher un modèle universel pour toutes les tâches, l'auteur assemble une pile de composants aux spécialités différentes. Pour les utilisateurs, c'est une voie plus réaliste vers la multimodalité : au lieu d'attendre que leur LLM préféré apprenne tout d'un coup, on lui ajoute des capteurs externes et des couches intermédiaires.
Ce schéma est particulièrement utile là où l'on valorise non seulement la reconnaissance, mais aussi le raisonnement qui suit : analyse de scènes, description du comportement d'un personnage, repérage de motifs de mouvement récurrents, préparation de notes pour la production ou pour la communication au sein de l'équipe. Le même schéma permet d'analyser des storyboards, des vidéos pédagogiques, des enregistrements d'interfaces et des générations de test avant le montage.
L'histoire de Claude et de Qwen Omni montre que la limite d'un modèle n'est pas toujours une impasse pour l'ensemble du processus. Si l'on découpe la tâche en étapes (perception, description, classification et conclusion), on voit clairement quelle part un outil tiers peut déjà couvrir. Pour les créateurs de contenu visuel, les animateurs et les artistes IA, c'est un bon signal : la valeur naît de plus en plus non d'un seul modèle « le plus intelligent », mais d'une chaîne bien assemblée où chaque système fait ce dans quoi il excelle vraiment.
- 2 nov. 2026Karpathy bâtit en deux heures un clone de YouTube avec 6454 vidéos issues des conseils de Hacker News
- 2 nov. 2026Avec Claude, Andrej Karpathy a assemblé HackerTube : 6454 vidéos recommandées sur Hacker News
- 2 nov. 2026Arca confie à des agents IA des tâches financières pouvant durer jusqu'à 10 jours, mais laisse les transactions aux humains
- 2 nov. 2026Anthropic doit augmenter son chiffre d'affaires de 32 % par an pour couvrir 850 milliards de dollars de contrats
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
L'essentiel de l'IA — une fois par semaine
Sept actus qui ont vraiment compté, choisies à la main. Sans bruit ni communiqués.
C'est fait ! Vérifiez votre boîte mail pour la confirmation.