T1 Cloud : H200 et L40S, revue technique des GPU pour l'IA générative
Toutes les tâches d'IA n'exigent pas un H200 haut de gamme. T1 Cloud a publié une revue technique de ses serveurs équipés de NVIDIA H200 et L40S, illustrée de photos prises dans son datacenter. Le H200 et ses 141 Go de mémoire HBM3e visent l'entraînement de grands modèles et la génération vidéo. Le L40S, basé sur l'architecture Ada Lovelace, cible l'inférence, les systèmes RAG et les chatbots d'entreprise. Le fournisseur a élargi sa gamme de GPU pour éviter à ses clients de payer une puissance superflue.
Traité par IA depuis Habr AI ; édité par Hamidun News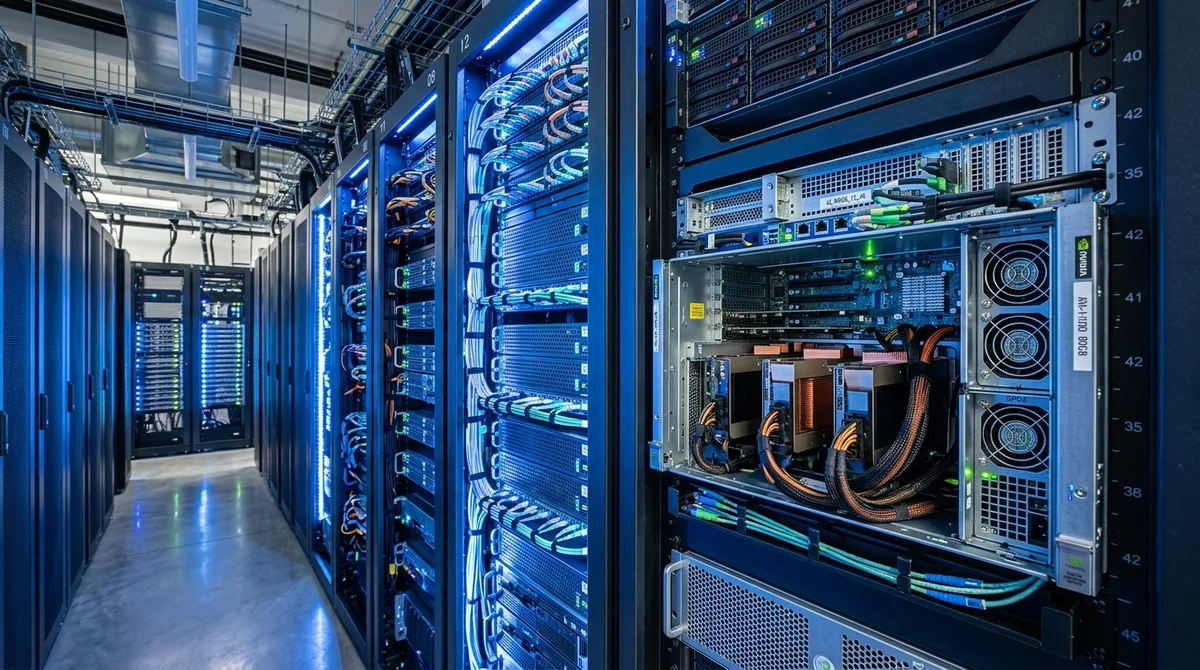
Choisir un GPU pour l'IA ne se résume pas à une question de budget. Il s'agit d'adapter précisément l'outil à la tâche : prendre exactement la puissance de calcul nécessaire à un cas d'usage donné, sans payer pour des caractéristiques qui ne serviront jamais. C'est sur ce principe que T1 Cloud a élargi sa gamme de GPU.
L'entreprise a publié une revue technique détaillée de ses serveurs équipés d'accélérateurs NVIDIA H200 et L40S, avec des photos prises directement dans son datacenter. La publication intervient alors que la demande en calcul GPU continue de croître : à mesure que les LLM passent du statut d'outil expérimental à celui d'infrastructure standard en entreprise, les sociétés se heurtent de plus en plus souvent à une question pratique : quel accélérateur convient à quelle tâche ?
Le H200 occupe le segment haut de gamme du marché des GPU. Successeur du H100, il embarque une mémoire de nouvelle génération HBM3e offrant une bande passante de 4,8 To/s, et une capacité étendue : 141 Go contre 80 Go pour son prédécesseur. C'est la carte des tâches qui exigent de garder en mémoire des modèles gigantesques : grands réseaux multimodaux générant texte, images et vidéo, entraînement from scratch sur des centaines de milliards de paramètres, traitement de vidéos en haute résolution.
Le H200 prend en charge NVLink pour relier plusieurs GPU au sein d'un serveur, ainsi que l'interconnexion haut débit entre nœuds Infiniband. Un point critique pour les entraînements à grande échelle, où les données doivent circuler rapidement entre des dizaines de nœuds.
Le L40S répond à une autre logique. Cet accélérateur d'architecture Ada Lovelace dispose de 48 Go de mémoire GDDR6 et de cœurs Tensor de quatrième génération optimisés pour les opérations FP8 et BF16. Son point fort n'est pas une bande passante mémoire record, mais sa polyvalence. Le L40S s'en sort aussi bien en inférence de modèles de langage de taille moyenne qu'en rendu, traitement vidéo, vision par ordinateur et design génératif. Pour déployer un chatbot d'entreprise sur des documents internes, bâtir un système RAG pour une base de connaissances ou automatiser le traitement d'images, le L40S fera l'affaire sans faire payer les caractéristiques haut de gamme du H200.
T1 Cloud a délibérément élargi sa gamme de GPU pour ne pas imposer à ses clients un outil excessivement coûteux là où il n'est pas nécessaire. Son datacenter propose désormais des serveurs adaptés à différentes classes de tâches : de l'inférence légère et des systèmes RAG jusqu'à l'entraînement distribué intensif. Une étape importante pour un marché où de nombreux fournisseurs n'ont historiquement proposé que des configurations haut de gamme, conduisant les entreprises à surpayer des capacités de calcul dont elles n'avaient tout simplement pas besoin.
L'intérêt pratique de cette approche est évident. Une entreprise qui a besoin d'une base de connaissances interne couvrant des milliers de documents avec recherche sémantique n'a pas à louer un cluster de H200. Un ou deux L40S lui suffiront largement. En revanche, si cette même entreprise entraîne son propre modèle multimodal spécialisé ou travaille sur des vidéos en 8K, seul le H200 lui apportera un gain réel, et économiser sur le matériel se traduirait alors par une perte de temps et de qualité.
Le format de la publication mérite aussi l'attention : des photos détaillées de datacenter restent une rareté sur le marché russe du cloud. La plupart des fournisseurs se contentent de fiches techniques en PDF et de slides marketing. Montrer le matériel réel, accompagné d'une description technique, apporte de la transparence et aide ingénieurs et acheteurs à mieux comprendre l'infrastructure, un point particulièrement important lorsqu'il s'agit de choisir un partenaire technologique sur le long terme.
Le constat est clair : la croissance du marché des accélérateurs d'IA pousse les fournisseurs cloud à penser non seulement à la puissance haut de gamme, mais aussi à une segmentation intelligente. Le H200 et le L40S ne sont pas concurrents : ce sont des outils pour des tâches fondamentalement différentes. Les entreprises qui l'ont compris et proposent les deux options avec des recommandations d'usage claires disposent d'un véritable avantage concurrentiel : le client paie exactement ce dont il a réellement besoin, ni plus ni moins.
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
L'essentiel de l'IA — une fois par semaine
Sept actus qui ont vraiment compté, choisies à la main. Sans bruit ni communiqués.
C'est fait ! Vérifiez votre boîte mail pour la confirmation.