Yandex Cloud explique pourquoi le frontend pilote l'intégration des réseaux de neurones dans DataLens au démarrage
Yandex Cloud a décrit comment DataLens a confié la première couche d'intégration de l'IA à l'équipe frontend. Plutôt que de dépendre entièrement du backend, elle s'appuie sur un BFF qui gère le modèle, le contexte et le streaming. L'idée clé est simple : si les données et l'état vivent à côté de l'interface, lancer Neuroanalyste depuis celle-ci va plus vite. Cette approche permet de tester une hypothèse produit sans grande refonte côté serveur.
Traité par IA depuis Habr AI ; édité par Hamidun News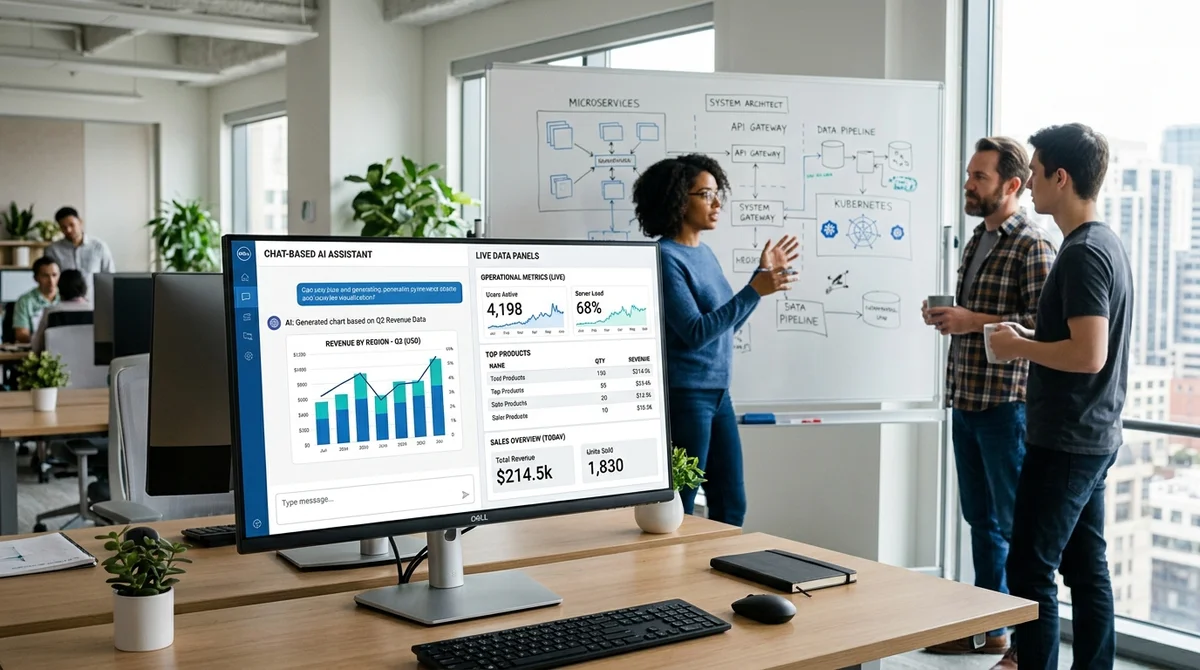
Yandex Cloud invite à ne pas voir l'intégration des réseaux de neurones dans un produit comme une tâche réservée au backend. Dans DataLens, l'équipe frontend a pris en charge la première couche opérationnelle de Neuroanalyste : elle a assemblé l'interface de chat, une couche BFF et la logique de dialogue avec le modèle, sans attendre une grosse refonte côté serveur. L'idée : pour lancer tôt des fonctions d'IA, une architecture parfaite pensée pour des années compte moins qu'une arrivée rapide en production, avec un partage clair des responsabilités.
Le cas en question est DataLens, le système de BI de Yandex Cloud pour visualiser de grands volumes de données. Le service intègre désormais Neuroanalyste, un assistant qui aide à construire des graphiques, écrire des formules et résoudre des tâches analytiques sous forme de dialogue. Au lieu du schéma classique, où le backend assume entièrement l'intégration du LLM, l'équipe a proposé un autre ordre : une couche BFF s'intercale entre le client et le modèle, et c'est le frontend qui en est responsable. Cette couche peut tourner sur Node.js, Bun ou une autre stack familière et servir de serveur distinct, orienté vers les besoins de l'interface.
L'auteur illustre l'approche avec un projet de démonstration : un monorepo avec Express et React, où un tableau de bord BI fonctionne à côté d'un assistant de chat. Dans ce schéma, le backend existant n'a pas besoin d'être réécrit en urgence. Le BFF conserve les clés d'accès au modèle, gère le rate limiting, le CORS, la journalisation et la supervision, et pilote le streaming des réponses.
Pour les développeurs frontend, ce n'est pas un terrain inconnu : dans de nombreuses équipes produit, ils travaillent depuis longtemps comme ingénieurs full stack, en maintenant du code serveur, le CI/CD et l'infrastructure autour de l'application cliente. La première étape de l'intégration peut donc se faire plus près de l'interface, là où l'effet pour l'utilisateur se voit le plus vite. Si l'hypothèse ne tient pas, le coût de l'erreur est inférieur à celui d'une refonte profonde du backend principal.
Les auteurs de l'approche distinguent quatre composants de base. Premièrement, un UI kit pour l'interface de chat et ses éléments : champs de saisie, cartes, listes d'actions, streaming des messages. Deuxièmement, un SDK pour travailler avec le modèle via API ; ce qui compte ici n'est pas le fournisseur précis mais la compatibilité, car de nombreux services reprennent le format de l'API d'OpenAI.
Troisièmement, le tooling, c'est-à-dire le function calling et l'accès du modèle à des fonctions applicatives, par exemple pour récupérer les données d'un graphique ou sélectionner les 5 meilleurs produits. Quatrièmement, le contexte : historique du dialogue, état de l'application, code de l'utilisateur, résultats de calculs et erreurs dont le modèle a besoin pour répondre de façon pertinente. À ce niveau de base, ces quatre couches suffisent pour lancer une fonction d'IA opérationnelle dans l'interface.
L'auteur voit dans le contexte le principal argument en faveur du frontend. Un LLM n'a pas de mémoire propre : à chaque requête, il faut retransmettre l'historique de la conversation et tout ce qui est nécessaire pour répondre. Dans les produits de BI, une part importante des données vit côté client : onglets ouverts, paramètres actuels du tableau de bord, fragments de requêtes, messages d'erreur, résultats intermédiaires et parfois des morceaux de code de l'utilisateur.
Envoyer tout cela au backend pour chaque réponse du modèle coûte cher et n'est pas toujours raisonnable. Par ailleurs, même si la fenêtre de contexte des modèles s'élargit, elle reste généralement limitée à des dizaines ou des centaines de milliers de tokens, parfois à un million, et on ne peut pas l'utiliser sans tri. Les modèles gèrent en outre toujours mal les calculs exacts : il leur faut non seulement beaucoup de données, mais des données bien conditionnées et l'accès à des outils qui calculent et extraient les faits nécessaires.
Pour le marché, c'est un signal important : l'intégration de l'IA dans un produit cesse d'être le monopole du backend et devient une tâche d'ingénierie partagée, où le frontend peut prendre en charge l'étape de départ et amener plus vite une idée jusqu'aux utilisateurs. Quand la charge augmente, que des opérations en arrière-plan apparaissent et que le lien avec les systèmes internes se resserre, le rôle du backend se renforce de nouveau, bien sûr. Mais à un stade précoce, cette approche par BFF permet de tester plus vite des scénarios, de recueillir des enseignements produit et de ne pas freiner le lancement à cause d'une grande refonte d'architecture.
Pour les équipes qui cherchent encore où placer leur première fonction LLM, c'est une manière pragmatique de démarrer sans lourdeur organisationnelle superflue.
- 1 nov. 2026Les modèles locaux battus par Opus et Codex : 0,21 sur MacBook contre 1,00 pour Codex
- 1 nov. 2026Kimi obtient 96,2 % à un test d'analytique sur une base 1C et s'impose comme solution de repli en cas de blocage de Claude
- 1 nov. 2026OpenAI réécrit les règles de comportement de GPT : cinq valeurs et une chaîne de priorités
- 1 nov. 2026Google reconnaît que l'AI Mode réduit les revenus de la recherche, l'action chute de 15%
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
L'essentiel de l'IA — une fois par semaine
Sept actus qui ont vraiment compté, choisies à la main. Sans bruit ni communiqués.
C'est fait ! Vérifiez votre boîte mail pour la confirmation.