Pourquoi le cerveau est des centaines de millions de fois plus efficace que GPT-4, et où vont les puces neuromorphiques
Le cerveau humain dépense des millions de fois moins d'énergie par acte de pensée que les LLM actuels, et l'écart ne tient pas seulement au matériel. Les différences clés sont le calcul analogique, l'activation parcimonieuse, la récurrence et l'apprentissage local. Les puces neuromorphiques sortent déjà des laboratoires : SpiNNaker2, Akida et Xylo montrent où le matériel d'IA pourrait aller dans les prochaines années.
Traité par IA depuis Habr AI ; édité par Hamidun News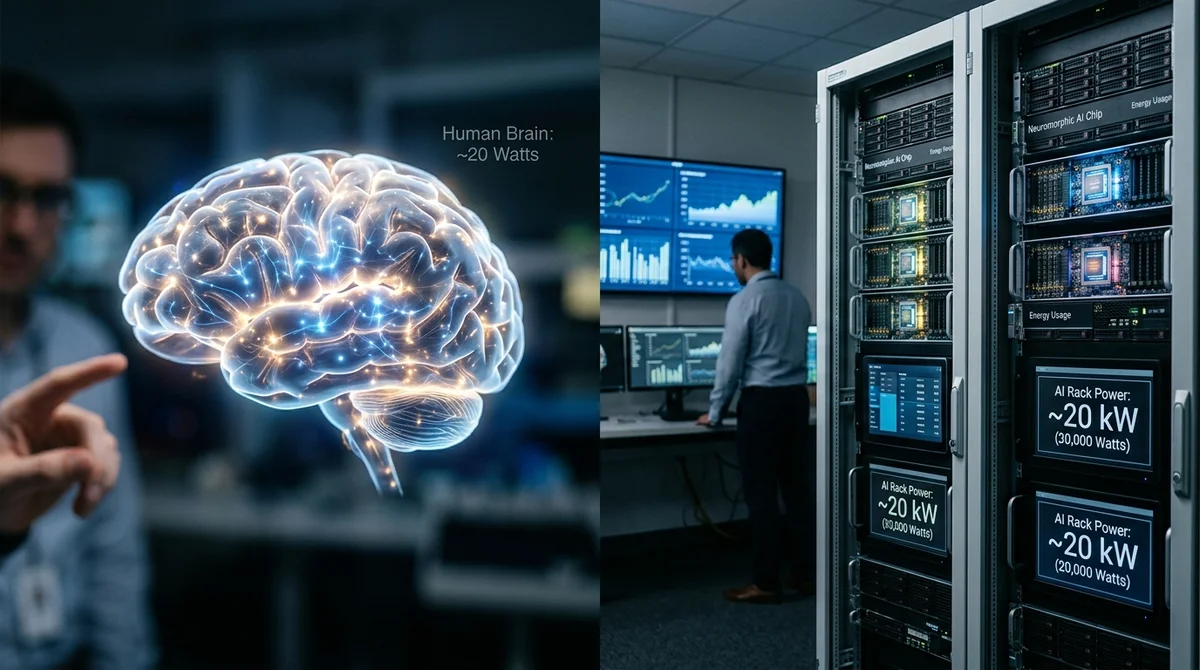
Comparer le cerveau humain aux LLM actuels met en lumière un fait gênant pour l'industrie de l'IA : même les modèles les plus puissants restent extrêmement gourmands en énergie. Le cerveau fonctionne avec environ 20 watts, alors que les grands modèles de langage peuvent exiger des kilowatts pendant l'inférence et des mégawatts de puissance à l'entraînement. Si l'on ignore les benchmarks marketing pour regarder le coût d'un seul acte de pensée, l'écart est colossal : la biologie accomplit toujours le même travail pour des ordres de grandeur de moins que le silicium.
L'article commence la comparaison par des chiffres de base. On estime que le cerveau effectue environ 10^16 opérations synaptiques par seconde pour une consommation d'environ 20 watts. Les LLM actuels atteignent une échelle de calcul comparable grâce aux GPU et aux TPU, mais chaque opération coûte bien plus cher. En énergie par action, le cerveau se situe dans les attojoules, contre des picojoules et plus pour les accélérateurs numériques.
L'auteur donne aussi un exemple plus parlant. Pour répondre à une question simple, comme la différence entre le méthane et l'éthane, le cerveau n'active qu'une petite fraction de ses neurones et dépense environ quelques dixièmes de joule, alors que GPT-4 doit charger un énorme ensemble de paramètres et exécuter un volume gigantesque d'opérations matricielles. Posé ainsi, l'écart peut atteindre des centaines de millions de fois.
La cause n'est pas que les ingénieurs conçoivent simplement du mauvais matériel, mais les principes mêmes du calcul. Le cerveau fonctionne en analogique : neurones et synapses opèrent sur des gradients continus, des potentiels de membrane et des courants ioniques. Un seul élément biologique stocke l'état et participe au calcul en même temps. Chez les LLM, tout est différent : les données sont représentées en bits, le calcul est séparé de la mémoire, et chaque opération matricielle se décompose en une longue chaîne de commutations numériques.
Second avantage du cerveau : la récurrence et la dynamique temporelle. Un même neurone intervient plusieurs fois dans le traitement d'un signal, et le temps devient une partie du calcul. Le transformer, lui, fait passer chaque token par un ensemble fixe de couches et le paie par un nombre énorme d'opérations parallèles.
Troisième différence : la parcimonie. Dans le cerveau, seule une petite fraction des neurones est active à un instant donné, si bien que le système ne gaspille pas d'énergie à allumer tout le réseau. Dans un LLM, chaque étape mobilise d'énormes ensembles de poids, même quand la tâche est relativement simple.
Quatrième facteur : l'apprentissage local. Le système biologique modifie des synapses précises là où une nouvelle expérience a eu lieu, au lieu de lancer une rétropropagation globale de l'erreur à travers un réseau géant. Cinquième facteur : la physique du substrat lui-même. Les canaux ioniques et les processus biochimiques fonctionnent presque à la limite du minimum thermodynamique, alors que même les transistors les plus avancés commutent avec des pertes bien supérieures.
Enfin, le cerveau reçoit une partie de sa structure gratuitement : le cortex visuel, l'hippocampe, le cervelet et d'autres blocs spécialisés lui sont venus de l'évolution, tandis que les LLM doivent réapprendre la structure du monde à partir de masses de données et d'un entraînement très coûteux.
Cela ne signifie pas que les grands modèles n'ont pas d'avenir. La conclusion est plutôt que l'architecture actuelle des transformers a buté sur le prix énergétique de sa propre commodité. L'industrie cherche déjà des contournements : quantification à 4–8 bits, transformers parcimonieux, mélanges d'experts, réseaux liquides et réseaux à impulsions (spiking). Certaines approches offrent déjà un gain de 5 à 10 fois, mais cela ne suffit pas pour s'approcher du niveau biologique. L'attention se tourne donc de plus en plus vers le matériel neuromorphique.
Ces systèmes existent déjà : SpiNNaker2 est déployé comme supercalculateur spécialisé et peut même être loué via le cloud, BrainChip Akida cible l'edge AI, et SynSense Xylo et Innatera Pulsar visent les scénarios de microwatts et de capteurs. Pourtant, même les meilleures de ces solutions restent environ trois ordres de grandeur en dessous du cerveau en efficacité énergétique et exigent une pile logicielle totalement différente.
L'horizon pratique reste lui aussi sobre. Entre 2026 et 2028, les puces neuromorphiques devraient surtout progresser dans la robotique, les automates industriels, les capteurs et les systèmes autonomes, où la latence et la consommation sont critiques. L'électronique grand public, comme les smartphones et les montres, ne recevra de tels coprocesseurs, si elle en reçoit, que plus près de 2030 ou après. Le principal frein n'est pas seulement la fabrication des puces, mais aussi le logiciel : des outils familiers comme PyTorch et TensorFlow ne fonctionnent pas avec les réseaux à impulsions sans adaptation sérieuse, et il n'existe pas encore de standard d'entraînement universel pour ces systèmes.
La conclusion principale est simple : aujourd'hui, le cerveau n'est pas seulement plus intelligent sur certaines tâches, il est radicalement plus économe en tant que machine de calcul. Le prochain grand bond de l'IA viendra donc probablement non pas d'un LLM encore plus gros sur un cluster de GPU encore plus vaste, mais d'un changement du paradigme de calcul de base. Pour l'instant, GPT-4 et ses successeurs restent un moyen très puissant, mais énergétiquement coûteux, d'obtenir un comportement qui ressemble à de l'intelligence.
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
L'essentiel de l'IA — une fois par semaine
Sept actus qui ont vraiment compté, choisies à la main. Sans bruit ni communiqués.
C'est fait ! Vérifiez votre boîte mail pour la confirmation.