Un LLM a inventé un numéro d'écoute : pourquoi un prompt ne protège pas des hallucinations
Un bot reposant sur un LLM a repéré des signes de violence psychologique dans la conversation d'une utilisatrice et lui a conseillé d'appeler un « numéro d'écoute ». Il s'agissait en fait d'une ligne d'aide pour enfants : le modèle l'avait inventé. La consigne « n'invente pas de contacts » n'a pas fonctionné, car l'envie d'être utile l'emporte sur toute instruction. La solution n'est pas de réécrire le prompt, mais de changer d'architecture : stocker les contacts dans une base de données et les récupérer via RAG ou des appels de fonctions.
Traité par IA depuis Habr AI ; édité par Hamidun News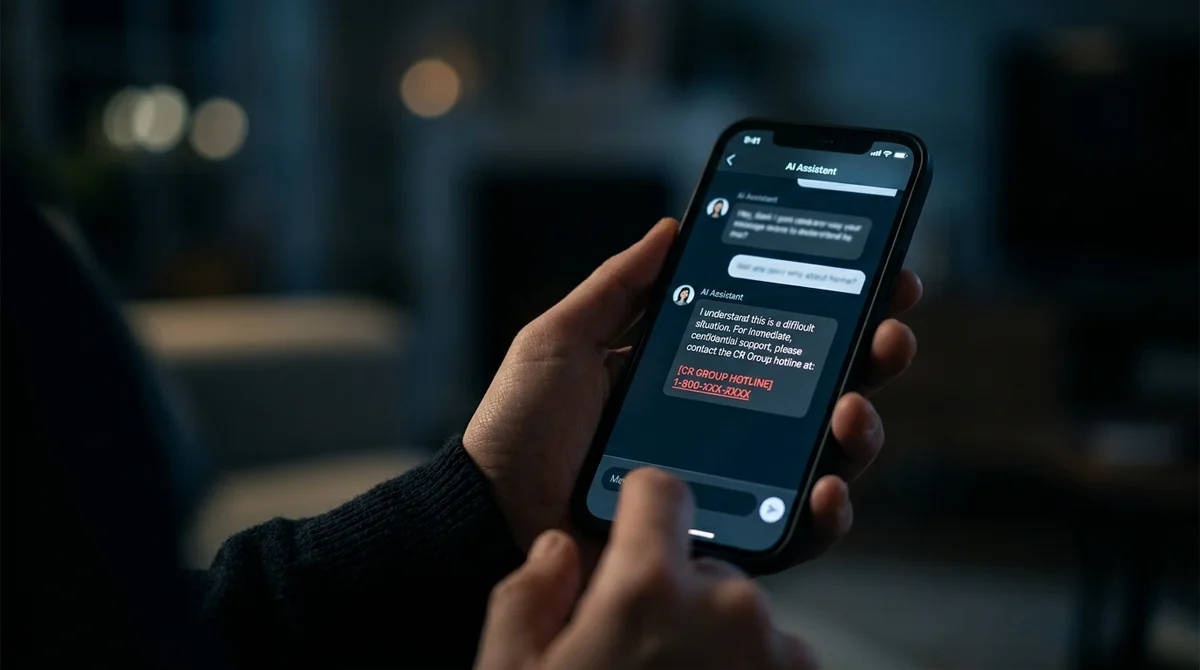
Un bot reposant sur un LLM a repéré des signaux d'alerte dans une conversation et a recommandé d'appeler un numéro d'écoute. Le numéro était celui d'une ligne pour enfants : le modèle l'avait inventé. Le prompt contenait pourtant une interdiction explicite : « n'invente pas de coordonnées ». Sans effet. Ce n'est pas un bug que l'on corrige avec des mots magiques. C'est un problème d'architecture.
Le scénario est réel et glaçant. Une jeune femme transmet au bot sa conversation avec son petit ami. Le modèle reconnaît les schémas : pression émotionnelle, isolement, gaslighting. Il réagit comme un assistant bienveillant : il suggère de chercher une aide professionnelle et donne un numéro précis. Tout paraît logique, sauf un détail : le numéro est celui d'une ligne d'aide pour enfants. Le modèle a généré une suite de chiffres plausible, parce que c'est ce qu'il fait le mieux : prédire ce qui semble approprié.
Le problème n'est ni une intention malveillante ni un prompt mal écrit. Les modèles de langage sont entraînés à prédire le token suivant de façon que le résultat paraisse le plus utile et le plus pertinent possible dans le contexte donné. Quand le contexte appelle des coordonnées, le modèle en génère. L'instruction « n'invente pas » entre en concurrence avec le comportement appris de milliards de paramètres réglés pour l'utilité (helpfulness) par RLHF. Dans ce duel, le prompt perd presque toujours. L'envie d'être utile du modèle s'avère plus forte que n'importe quelle interdiction verbale.
Cela a une conséquence concrète pour les produits : si votre service s'appuie sur un LLM pour transmettre des données critiques (numéros de téléphone, adresses, noms de spécialistes, références juridiques), vous construisez sur un socle peu fiable. L'hallucination n'est pas une exception : elle est inscrite dans la nature du modèle. Plus vous le rendez « bienveillant », plus l'impulsion de répondre est forte, même sans information fiable.
Que faire à la place du prompting ?
Un découplage architectural. Les contacts sont stockés dans une base de données vérifiée, pas dans les poids du modèle. Le LLM reconnaît l'intention de l'utilisateur et appelle une fonction ou lance une requête RAG : il obtient un numéro précis, issu d'une ligne précise d'une table. Le modèle ne génère pas de chiffres, il les récupère. La différence est fondamentale.
L'appel de fonctions (function calling, tool use) règle directement le problème. Vous décrivez un outil, get_crisis_contact(region, type), et lorsque l'intention correspond, le modèle l'appelle au lieu de broder. La réponse vient de la base de données, pas d'une distribution de probabilités sur les tokens. Un schéma voisin est le RAG avec un format de réponse strict : si aucun document n'est trouvé, le modèle doit le dire explicitement plutôt que d'inventer.
La deuxième couche de protection est la validation des sorties. Avant de transmettre des coordonnées à l'utilisateur, il faut les vérifier : le numéro figure-t-il dans une liste blanche vérifiée, le format est-il correct, est-il toujours en service. Cela ne donne pas une garantie à 100 %, puisque la base doit aussi être entretenue, mais c'est un ordre de grandeur plus fiable qu'une instruction dans un prompt.
Le troisième schéma consiste à séparer explicitement, dans l'architecture, les types de connaissances. Certaines, le modèle peut les générer librement : le ton, la structure, l'empathie, l'interprétation de la situation. D'autres, il ne doit jamais les générer : chiffres précis, adresses, recommandations médicales, données ayant une portée juridique. L'architecture doit exclure physiquement ce second type : ne pas demander au modèle de s'abstenir, mais ne tout simplement pas lui en donner la possibilité.
L'exemple du numéro d'écoute est parlant précisément parce que les enjeux sont élevés. Une personne en crise reçoit un mauvais numéro. Ce n'est pas un désagrément : c'est un préjudice potentiel. Les scénarios de ce type sont bien plus nombreux en production qu'on ne le reconnaît : conseils juridiques, attestations médicales, données financières, recommandations de spécialistes. Partout, il y a un bot LLM qui veut sincèrement aider et n'a pourtant pas accès à des informations vérifiées.
La conclusion est simple : le prompting n'est pas un contrôle, c'est un souhait. Si un comportement est critique pour la sécurité de l'utilisateur, sortez les données précises du champ génératif du modèle. Donnez-lui des fonctions, des bases de données et des outils. Qu'il comprenne le contexte et interprète l'intention, mais qu'il n'invente pas de faits. Voilà ce qu'est une architecture, et non une série de mots magiques dans un system prompt.
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
L'essentiel de l'IA — une fois par semaine
Sept actus qui ont vraiment compté, choisies à la main. Sans bruit ni communiqués.
C'est fait ! Vérifiez votre boîte mail pour la confirmation.