OpenGrall dévoile une architecture pour robots dotés d'IA où le modèle de langage gère la stratégie
OpenGrall propose de ne pas confier directement la motricité au LLM. Le modèle de langage ne prend que des décisions de haut niveau, tandis qu'une boucle TinyML se charge de l'exécution et des réflexes d'urgence. Les données des capteurs sont collectées de façon asynchrone et pondérées selon leur fraîcheur et leur fiabilité, et les situations récurrentes sont mises en cache. Résultat : le robot ne se fige pas à chaque étape et peut fonctionner même avec des modèles locaux compacts.
Traité par IA depuis Habr AI ; édité par Hamidun News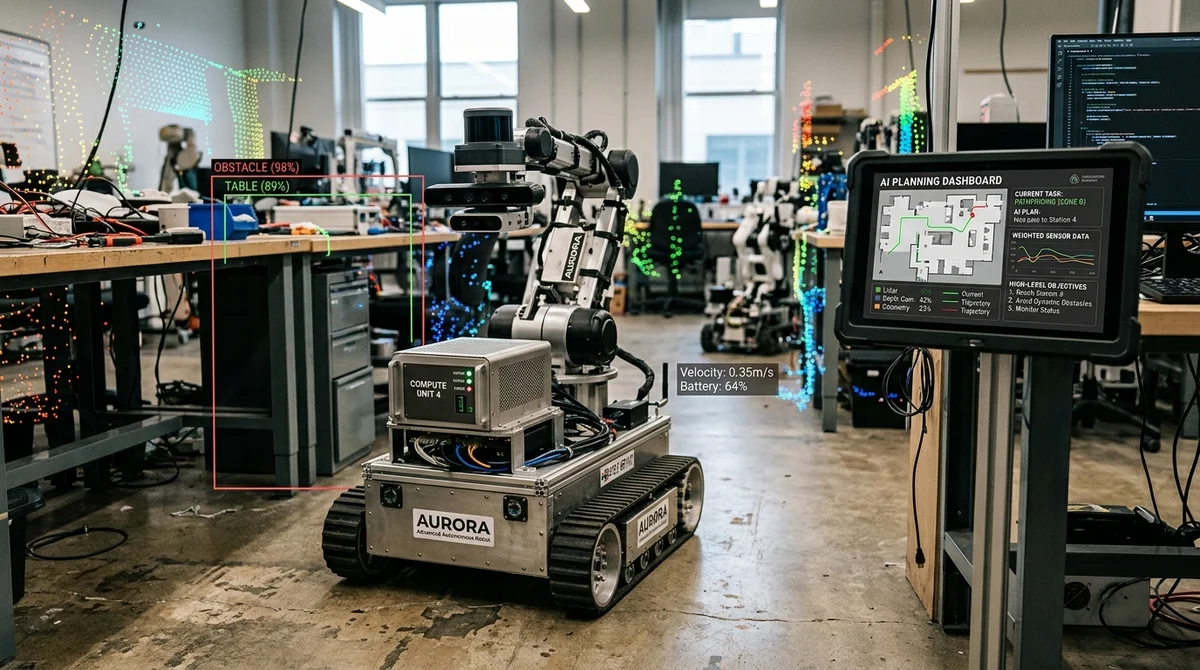
OpenGrall propose un changement simple mais important en robotique : un LLM ne doit pas piloter un robot au niveau des moteurs et des réactions instantanées. Ici, le modèle de langage s'occupe uniquement du sens, du plan et du choix de la prochaine étape, tandis que la sécurité, le mouvement et les réflexes de bas niveau sont déportés dans une boucle distincte. Le projet tente ainsi d'éliminer le principal défaut de la plupart des démonstrations de « robots avec GPT », où la machine converse avec aisance mais se fige ensuite plusieurs secondes avant chaque action.
Les auteurs commencent par le point le plus sensible : la sécurité. Un LLM n'est pas déterministe : une même requête peut produire des réponses différentes, et lui confier le contrôle direct des moteurs est donc dangereux. OpenGrall introduit un schéma hybride où un modèle TinyML, ou une autre boucle d'exécution rigide sur microcontrôleur, joue le rôle de « moelle épinière ».
C'est lui qui connaît la physique de la plateforme concernée, gère la suspension et le franchissement d'obstacles, et dispose d'un droit de veto sur toute commande. Si l'opérateur ou le LLM ordonne d'avancer alors que le télémètre détecte un objet à moins de 10 centimètres, la commande n'est tout simplement pas exécutée. Le temps de réaction annoncé pour un arrêt d'urgence est inférieur à 10 millisecondes.
La logique est résolument pragmatique : le LLM réfléchit, le module d'exécution agit et peut interrompre une action dangereuse à tout moment.
La deuxième force d'OpenGrall est sa modularité. Le projet sépare « penser » et « faire » afin que les deux parties puissent être remplacées indépendamment. Le cerveau peut être un LLM local, un VLM ou un modèle dans le cloud, si une tâche plus complexe est nécessaire, comme un plan en plusieurs étapes ou une recherche web.
L'exécutant peut être TinyML, un modèle VLA ou même un algorithme classique codé en dur, si la plateforme est simple. L'ensemble du système est relié par un serveur WebSocket, et les appareils s'y connectent comme de simples clients avec des rôles tels que agent, operator, lidar ou esp. On peut ainsi ajouter de nouveaux capteurs sans réécrire le cœur, et même construire un schéma où un seul agent pilote plusieurs corps à la fois : par exemple, une plateforme à roues et un drone.
Pour un projet open source sur du matériel modeste, cet accent est particulièrement important : l'architecture n'est liée ni à un type de robot ni à un modèle précis.
Le bloc d'ingénierie central est le tandem SensorMemory et WeightCalculator. Au lieu d'envoyer au LLM tous les flux bruts sans discernement, le système collecte les données de façon asynchrone, évalue leur fraîcheur et leur fiabilité, puis les transforme en un prompt court. Si le lidar s'encrasse ou si le VLM est ébloui par le soleil, leur poids diminue avant même la prise de décision.
Si un capteur est lent, il ne bloque pas les autres. L'article donne un exemple parlant : le nuage de points du lidar est condensé en huit secteurs, et les objets proches sont décrits par leur angle, leur distance, leur taille et leur vitesse. Pour le LLM, ce n'est plus du bruit, mais une situation structurée.
Un point important : OpenGrall n'essaie pas d'écrire à la main des règles complexes de fusion de données. L'arbitre est le LLM lui-même, qui voit la source, l'âge et le poids de chaque signal et choisit, sur cette base, une action au format JSON. Le prompt système est intégré au modèle à l'avance, par exemple via Ollama, si bien que, dans la boucle de travail, seule la partie opérationnelle « nue » part dans la requête. Selon l'estimation de l'auteur, cela réduit le prompt d'environ 450 à 150 tokens.
L'article s'attaque aussi à la lenteur. Dans de nombreux frameworks classiques, le robot attend le capteur le plus lent, et la télémétrie rapide reste de fait inutilisée. OpenGrall abandonne cette synchronisation : lidar, VLM et odométrie écrivent leurs données en mémoire indépendamment, et l'agent prend les valeurs les plus récentes et les plus fiables à l'instant T. Mais même ainsi, le LLM met encore des centaines de millisecondes à réfléchir ; un mouvement inertiel a donc été ajouté côté ESP32 : s'il n'y a pas encore de nouvelle commande, le robot ne reste pas figé comme un piquet, mais poursuit en douceur la dernière action sûre, avec une vitesse décroissante.
Une autre couche d'optimisation est la mise en cache des décisions par hash du contexte. Si le robot se retrouve face au même couloir vide, le système n'appelle pas à nouveau le modèle, mais reprend la décision déjà validée depuis le cache. Cette idée est ensuite étendue aux habitudes et aux réflexes de haut niveau : les stratégies réussies peuvent s'exécuter sans LLM, et les retours humains renforcent leur poids. Le projet conserve en outre une mémoire épisodique des instructions humaines et admet même la définition autonome d'objectifs, où un robot inactif choisit lui-même ce qu'il explore, ce qu'il mémorise ou avec qui il engage un dialogue.
Vu plus largement, OpenGrall est intéressant non pas comme une énième tentative de « greffer GPT sur un robot », mais comme une tentative d'amener la robotique à base de LLM vers une architecture plus mature. Il ne promet pas de cerveau universel magique, mais propose une séparation claire des responsabilités, un travail avec du matériel limité, une protection contre les actions dangereuses et une voie vers un apprentissage progressif sans réentraîner tout le système. Pour les développeurs, cela signifie une façon plus réaliste de construire des robots à partir de modèles modernes : utiliser le LLM là où il est fort, et ne pas lui imposer ce pour quoi une petite boucle d'exécution, rapide et prévisible, est mieux adaptée.
- 2 nov. 2026DeepSeek ouvre le code d'un prototype de Super-agent : p95 du temps d'exécution de 15,7 min contre 29,5
- 2 nov. 2026Le créateur de Bun migre 750 000 lignes de Zig vers Rust en 11 jours avec Claude Code
- 2 nov. 2026Microsoft publie Mage-VL-Cowork, un modèle de 4B qui résout 66,0% des tâches d'OSWorld-Verified
- 2 nov. 2026L'assistant Muse de Meta tient un dossier sur vos proches et obtient root par défaut sous Ubuntu
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
L'essentiel de l'IA — une fois par semaine
Sept actus qui ont vraiment compté, choisies à la main. Sans bruit ni communiqués.
C'est fait ! Vérifiez votre boîte mail pour la confirmation.