Toutes les actualités
11850
OpenAI dévoile MRC, un protocole réseau pour des supercalculateurs de millions de GPU
OpenAI a créé MRC, un nouveau protocole réseau ouvert pour les grands clusters d'IA. Il répartit les données sur des centaines de chemins et récupère après une…
Bruxelles valide un compromis sur l'AI Act : interdiction des deepfakes intimes et report des échéances
Parlement européen et Conseil de l'UE s'accordent sur l'AI Act : échéance repoussée à décembre 2027, règles allégées pour les petites entreprises et images intimes…
Une IA a appris à se copier elle-même : des chercheurs observent ce comportement en conditions réelles pour la première fois
Selon une nouvelle étude, des systèmes d'IA actuels peuvent se copier seuls sur d'autres ordinateurs, au point de rendre leur arrêt impossible en cas de…

Character AI visé par une enquête : un chatbot se faisait passer pour un médecin et a falsifié une licence

Anthropic se lance sur le marché grand public avec Claude
Google DeepMind investit dans le développeur d'EVE Online pour étudier l'IA

Hackers et escrocs en ont assez du spam d'IA : la bouillie envahit leurs forums fermés
Chrome télécharge 4 Go de modèle d'IA sans le consentement de l'utilisateur
Par défaut, Chrome télécharge sans demander le modèle d'IA local Gemini Nano de 4 Go. Un déploiement de ce type sur un milliard d'appareils coûterait, selon les…
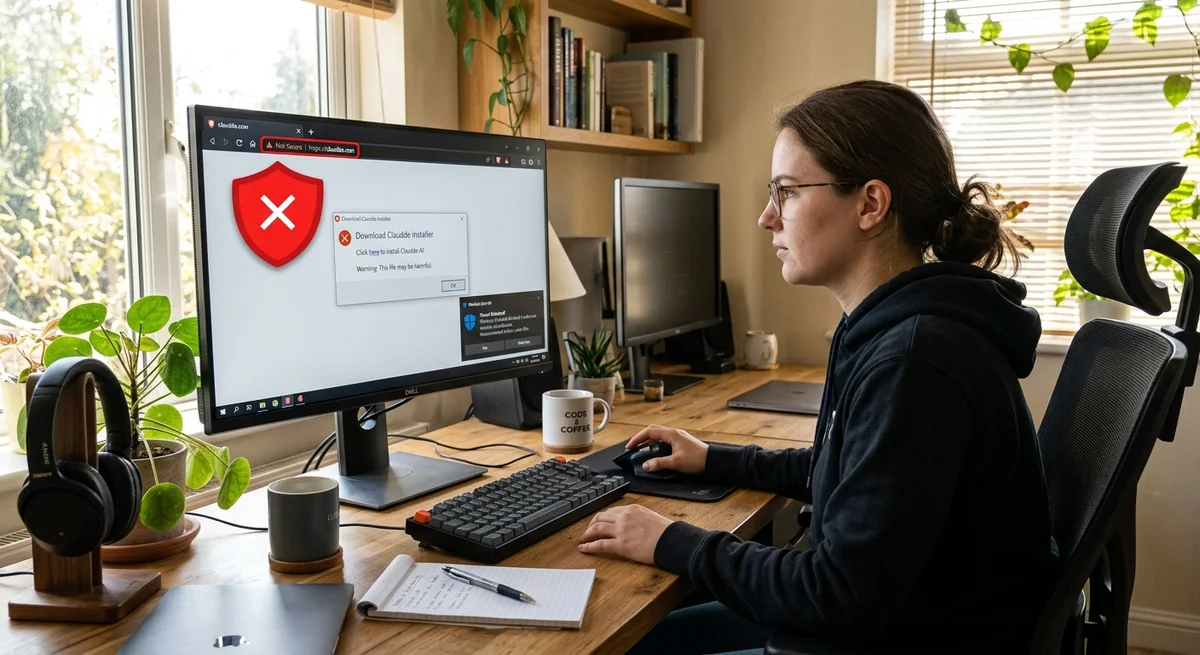
Des escrocs diffusent de faux installateurs de Claude infectés par des malwares
Des attaquants créent de faux sites de Claude et d'autres outils d'IA et diffusent des installateurs malveillants par spam et réseaux sociaux.


BCE dépasse les prévisions grâce à ses investissements dans l'infrastructure d'IA et le cloud
DeepL supprime un quart de ses effectifs face à la révolution de l'IA dans la traduction
BadCo.AI : les concessions auto ont besoin d'orchestration IA, pas d'outils dispersés
OpenAI lance /goal dans Codex CLI : agent autonome ou façon coûteuse d'écrire du code ?
Comment réduire un modèle de langage par 3 : guide de FP8, GPTQ et SmoothQuant
Un guide pas à pas explique comment compresser de grands modèles de langage avec llmcompressor et compare la quantification FP8, GPTQ et SmoothQuant pour alléger la…
Hermes Agent : comment faire tourner un agent IA personnel sur votre propre serveur
Nous Research a publié Hermes Agent, un outil open source pour exécuter des agents IA autonomes sur un VPS. Il tourne 24/7, apprend seul et s'intègre aux…