Le russe coûte 2 fois plus cher dans ChatGPT : la tokenisation en cause
Dans ChatGPT et les autres LLM cloud, un texte russe coûte 2 fois plus cher que son équivalent anglais. En cause : la manière dont les réseaux de neurones découpent le texte en tokens. Un mot anglais tient généralement en un seul token, alors qu'un mot russe en exige 2 à 4. Conséquence : la fenêtre de contexte utile est divisée par deux.
Traité par IA depuis Habr AI ; édité par Hamidun News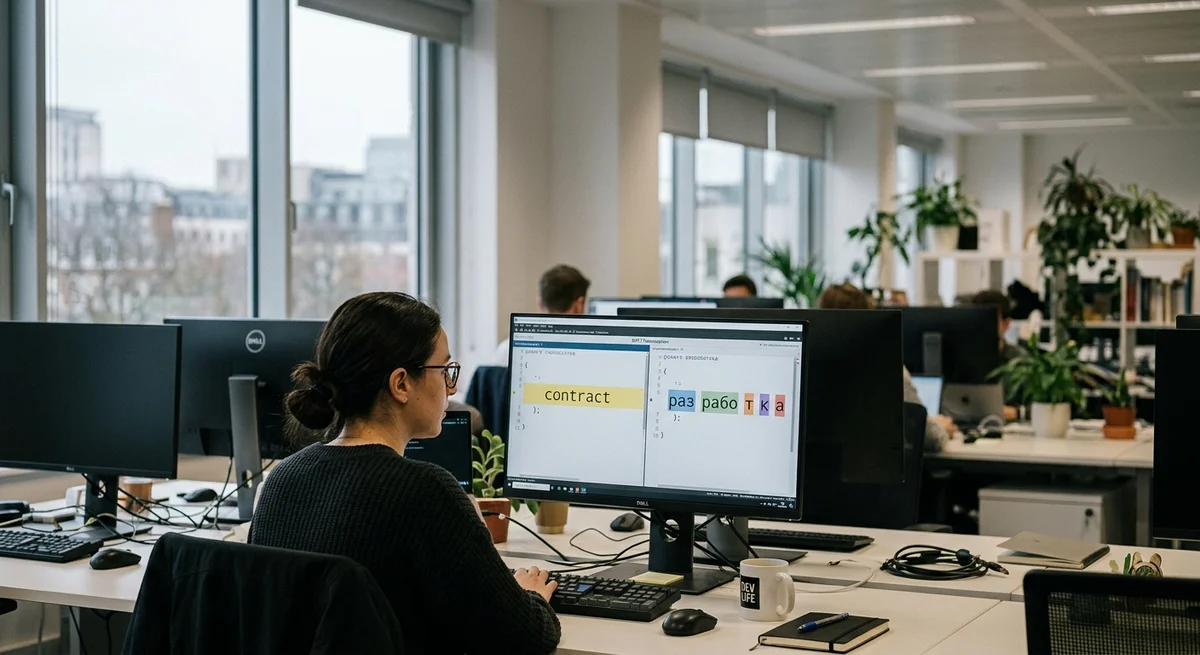
Quand vous envoyez une requête à ChatGPT ou à un autre réseau de neurones dans le cloud, le modèle ne manipule pas directement des lettres ni des mots. Il découpe d'abord le texte en tokens, de petits fragments de sens qu'il sait traiter. Ce découpage détermine le coût de la requête, la vitesse de la réponse et la quantité d'informations que la fenêtre de contexte peut contenir en une seule fois.
Comment fonctionne la tokenisation
La tokenisation est le processus par lequel un réseau de neurones découpe le texte, et chaque modèle s'y prend à sa manière. Le texte anglais se découpe très efficacement : un mot occupe généralement un ou deux tokens. Le mot « contract » correspond toujours à un seul token. Un texte anglais de 1000 mots nécessite environ 1200-1500 tokens.
Le russe est moins bien loti : le même contenu exige 2 à 3 fois plus de fragments. Le mot « разработка » (développement) demande deux à trois tokens, « программирование » (programmation) trois à quatre. Un adjectif comme « искусственный » (artificiel) peut en occuper quatre à cinq. Un texte russe de 1000 mots nécessite déjà 2500-3500 tokens.
L'explication tient à l'entraînement des grands modèles de langage actuels : l'anglais y a été utilisé de façon bien plus intensive que le russe. Son lexique est mieux représenté dans le vocabulaire de tokens, que les concepteurs des modèles ont constitué à partir d'énormes volumes de contenus anglophones. Pour les réseaux de neurones, le cyrillique reste une langue étrangère.
Ce que cela coûte en pratique
Cette inégalité de tokenisation rend le texte russe environ 2 fois plus cher que l'anglais dans des services cloud comme OpenAI, à volume d'information réel égal. Si vous payez 1 dollar pour traiter 1000 tokens de texte anglais, le russe vous coûtera 2 dollars.
L'écart saute aux yeux sur les gros projets : localiser une application en russe, traduire une documentation ou faire tourner un chatbot en russe coûte deux fois plus cher que les mêmes services destinés à un utilisateur anglophone.
Mais le surcoût n'est que le début des problèmes. Le traitement d'un texte russe est nettement plus lent, car le modèle doit passer davantage de tokens. Plus il y a de tokens, plus la réponse tarde. Quant à la fenêtre de contexte, c'est-à-dire la mémoire dans laquelle le modèle peut conserver l'information, sa capacité en contenu réel est divisée par deux. Avec une fenêtre de contexte de 128 000 tokens, vous ne pouvez faire tenir en russe que la moitié de l'information.
Qui est le plus touché
- Les développeurs russophones qui utilisent l'IA pour travailler sur de la documentation et du code
- Les entreprises qui traitent de gros volumes de texte russe (traductions, chatbots, analytique)
- Les startups russophones qui construisent des produits basés sur des LLM et ne peuvent pas se permettre les dépenses liées à OpenAI
- Les chercheurs qui travaillent sur la langue russe et ont besoin d'analyses approfondies via des réseaux de neurones
- Les auteurs et éditeurs qui veulent utiliser l'IA pour corriger et réécrire des textes
Comment mesurer sur vos propres données
L'auteur de l'article recommande de vérifier le ratio réel de tokens sur vos propres textes : prenez un échantillon en anglais et en russe, comptez les tokens via l'API d'OpenAI et comparez. Cela prend environ cinq minutes et vous donne le coût exact de votre cas d'usage.
Ce que cela signifie
L'inégalité de tokenisation agit comme une taxe cachée sur la langue russe à l'ère des grands modèles de langage. Ce n'est pas une erreur des développeurs, mais la conséquence naturelle de la façon dont ces modèles ont été construits : sur les contenus anglophones de la première génération d'Internet.
Pour la communauté russophone, il faut accepter cette réalité : soit payer plus cher et obtenir des réponses plus lentes, soit chercher des alternatives entraînées avec une meilleure prise en charge du cyrillique.
- 1 nov. 2026OpenAI réécrit les règles de comportement de GPT : cinq valeurs et une chaîne de priorités
- 1 nov. 2026Google reconnaît que l'AI Mode réduit les revenus de la recherche, l'action chute de 15%
- 31 oct. 2026Un auteur soumet son scénario à un jury d'IA : le verdict coûte 850 000 tokens
- 31 oct. 2026Anthropic : replier les sous-agents dans une seule boucle a doublé la vitesse des tâches chez un client
Questions clés sur cet article
Comment fonctionne la tokenisation?
La tokenisation est le processus par lequel un réseau de neurones découpe le texte, et chaque modèle s'y prend à sa manière. Le texte anglais se découpe très efficacement : un mot occupe généralement un ou deux tokens. Le mot « contract » correspond toujours à un seul token. Un texte anglais de 1000 mots nécessite environ 1200-1500 tokens. Le russe est moins bien loti : le même contenu exige 2 à 3 fois plus de fragments. Le mot « разработка » (développement) demande deux à trois tokens, « программирование » (programmation) trois à quatre. Un adjectif comme « искусственный »
Que sait-on sur Ce que cela coûte en pratique ?
Cette inégalité de tokenisation rend le texte russe environ 2 fois plus cher que l'anglais dans des services cloud comme OpenAI, à volume d'information réel égal. Si vous payez 1 dollar pour traiter 1000 tokens de texte anglais, le russe vous coûtera 2 dollars. L'écart saute aux yeux sur les gros projets : localiser une application en russe, traduire une documentation ou faire tourner un chatbot en russe coûte deux fois plus cher que les mêmes services destinés à un utilisateur anglophone. Mais le surcoût n'est que le début des problèmes. Le traitement d'un texte russe est
Que sait-on sur Qui est le plus touché ?
Les développeurs russophones qui utilisent l'IA pour travailler sur de la documentation et du code Les entreprises qui traitent de gros volumes de texte russe (traductions, chatbots, analytique) Les startups russophones qui construisent des produits basés sur des LLM et ne peuvent pas se permettre les dépenses liées à OpenAI Les chercheurs qui travaillent sur la langue russe et ont besoin d'analyses approfondies via des réseaux de neurones Les auteurs et éditeurs qui veulent utiliser l'IA pour corriger et réécrire des textes
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
L'essentiel de l'IA — une fois par semaine
Sept actus qui ont vraiment compté, choisies à la main. Sans bruit ni communiqués.
C'est fait ! Vérifiez votre boîte mail pour la confirmation.