Pourquoi GPT se trompe en comptant les lettres : le secret de la tokenisation
Les LLM traitent le texte comme une suite de tokens numériques, et non comme des lettres individuelles. D'où un paradoxe étrange : GPT peut facilement s'embrouiller quand il doit simplement compter les lettres d'un mot comme strawberry. Comprendre la tokenisation est la clé pour écrire des prompts plus efficaces, anticiper précisément les comportements étranges des modèles, optimiser la fenêtre de contexte et travailler avec des textes multilingues.
Traité par IA depuis Habr AI ; édité par Hamidun News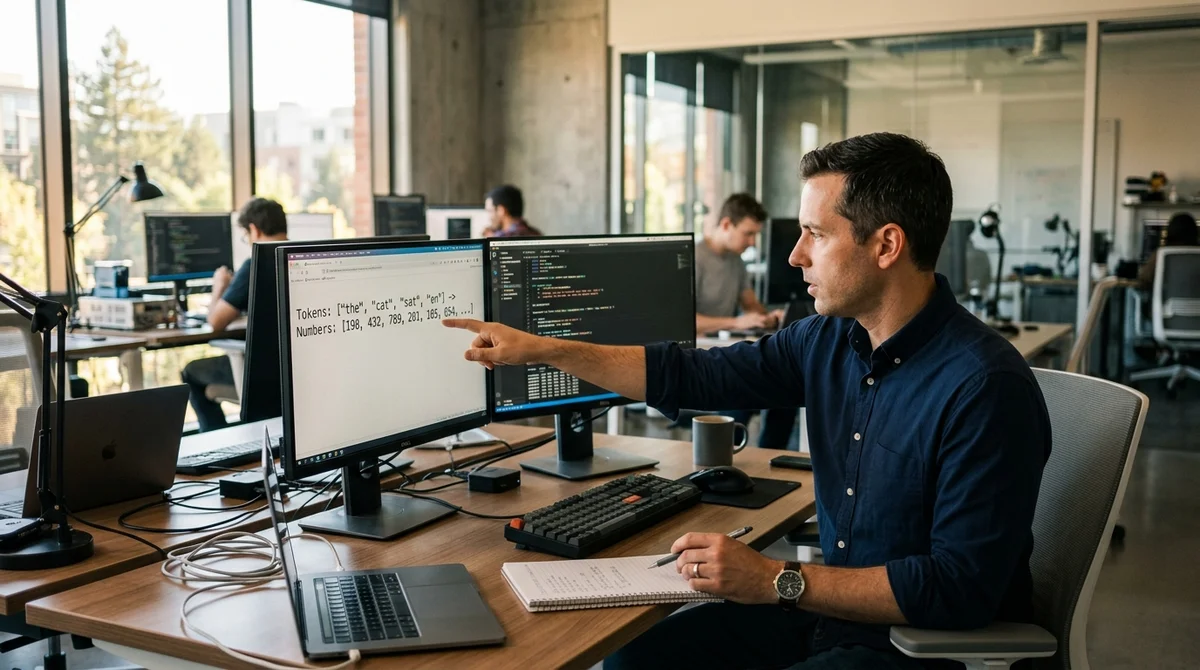
Quand vous écrivez un prompt dans ChatGPT, vous voyez un texte ordinaire, fait de lettres. Le modèle, lui, voit tout autre chose : une suite de nombres, appelés tokens. Ce décalage produit des effets étranges : GPT peut ne pas savoir combien de lettres compte le mot strawberry, ou s'embrouiller dans un simple comptage.
Comment les LLM voient le texte
Pour un réseau de neurones, un texte n'est pas une suite de lettres mais une séquence de codes numériques. Chaque token correspond à un nombre, et le modèle ne manipule que ces nombres : il ne voit jamais la lettre elle-même. Imaginez lire un livre à travers un système qui convertit d'abord les mots en codes ; vous traitez ces codes, puis ils sont reconvertis en texte.
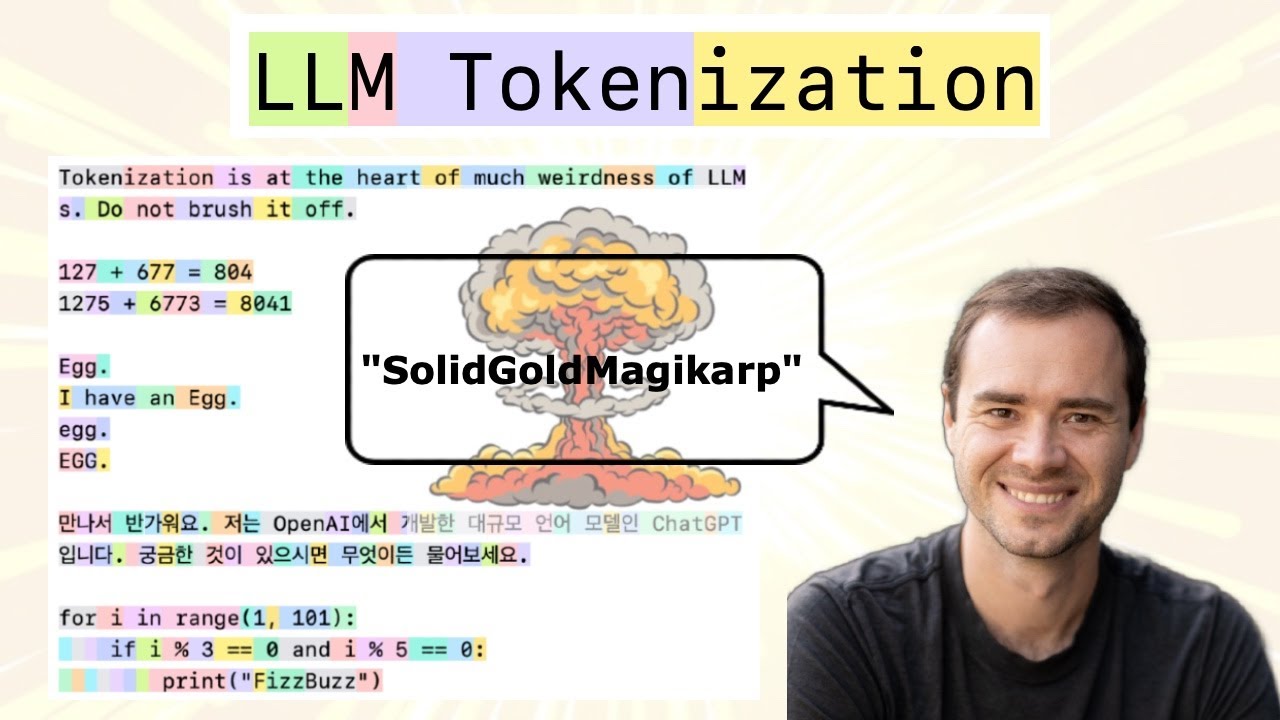
Un mot fréquent peut tenir en un seul token, tandis qu'un mot rare est découpé en plusieurs morceaux. Par exemple, « hello » est encodé par un seul nombre, alors que « strawberry » peut en nécessiter trois ou quatre. En russe, la situation est encore plus compliquée : la richesse morphologique de la langue rend le découpage des mots moins efficace.
Pourquoi cela pose problème
L'écart entre la façon dont les humains voient le texte et celle dont le modèle le perçoit entraîne toute une série de difficultés :
- Erreurs de comptage : GPT ne peut pas simplement compter les lettres, car il travaille avec des nombres et non avec des caractères
- Illisibilité des mots rares : les combinaisons de lettres rares sont découpées en plusieurs tokens, que le modèle perçoit comme des fragments distincts
- Asymétrie linguistique : l'anglais se découpe en tokens plus efficacement que le russe, le chinois ou l'arabe
- Consommation du contexte : si un mot est découpé en 3 tokens au lieu d'1, votre prompt occupe davantage de place dans la fenêtre de contexte
- Comportement imprévisible : le modèle peut se comporter étrangement avec les nombres, les codes et les noms rares, car ils sont fragmentés
L'algorithme en coulisses
La tokenisation repose sur l'algorithme Byte Pair Encoding (BPE). Voici son fonctionnement : le texte est d'abord découpé caractère par caractère, chacun formant un token distinct. L'algorithme repère ensuite les paires de caractères les plus fréquentes et les fusionne en un nouveau token. Il cherche alors les paires fréquentes parmi les tokens obtenus, et les fusionne à leur tour. L'opération se répète des milliers de fois.
Résultat : le vocabulaire de GPT compte environ 50 000 tokens. Les mots et fragments de mots fréquents deviennent des tokens à part entière, tandis que les combinaisons de lettres rares restent morcelées. Le système n'est pas idéal, mais il est plus efficace que d'encoder chaque lettre séparément.
Ce que cela implique
Comprendre la tokenisation change la manière de travailler avec les LLM. Si l'on sait que le modèle va s'embrouiller en comptant des lettres, on peut lui demander de procéder autrement, par exemple en écrivant d'abord les lettres une à une, puis en les comptant. Ce n'est pas une panacée, mais cela aide à écrire des prompts plus fiables.
Connaître la tokenisation est aussi utile pour optimiser les prompts longs : vous pouvez prévoir où le modèle « gaspillera » des tokens. C'est essentiel pour quiconque travaille en profondeur avec les LLM, des prompt engineers aux développeurs d'applications fondées sur les réseaux de neurones.
- 12 nov. 2026Jensen Huang quitte son poste de PDG de Nvidia : l’entreprise perd 1 400 milliards de dollars en deux semaines
- 12 nov. 2026Le syndicat d'Oakland obtient une reconversion plutôt que des licenciements dus à l'IA : 94,1 % pour la grève
- 12 nov. 2026Huit pays, OpenAI et Anthropic promettent un « interrupteur d'arrêt » pour les modèles d'IA, mais sans échéances ni sanctions
- 12 nov. 2026OpenAI et ModRetro lancent une console à 200 $ pour des jeux créés avec Codex
Questions clés sur cet article
Comment les LLM voient le texte?
Pour un réseau de neurones, un texte n'est pas une suite de lettres mais une séquence de codes numériques. Chaque token correspond à un nombre, et le modèle ne manipule que ces nombres : il ne voit jamais la lettre elle-même. Imaginez lire un livre à travers un système qui convertit d'abord les mots en codes ; vous traitez ces codes, puis ils sont reconvertis en texte. Un mot fréquent peut tenir en un seul token, tandis qu'un mot rare est découpé en plusieurs morceaux.
Pourquoi cela pose problème?
L'écart entre la façon dont les humains voient le texte et celle dont le modèle le perçoit entraîne toute une série de difficultés : Erreurs de comptage : GPT ne peut pas simplement compter les lettres, car il travaille avec des nombres et non avec des caractères Illisibilité des mots rares : les combinaisons de lettres rares sont découpées en plusieurs tokens, que le modèle perçoit comme des fragments distincts Asymétrie linguistique : l'anglais se découpe en tokens plus efficacement que le…
Que sait-on sur L'algorithme en coulisses ?
La tokenisation repose sur l'algorithme Byte Pair Encoding (BPE). Voici son fonctionnement : le texte est d'abord découpé caractère par caractère, chacun formant un token distinct. L'algorithme repère ensuite les paires de caractères les plus fréquentes et les fusionne en un nouveau token. Il cherche alors les paires fréquentes parmi les tokens obtenus, et les fusionne à leur tour. L'opération se répète des milliers de fois. Résultat : le vocabulaire de GPT compte environ 50 000 tokens.
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
L'essentiel de l'IA — une fois par semaine
Sept actus qui ont vraiment compté, choisies à la main. Sans bruit ni communiqués.
C'est fait ! Vérifiez votre boîte mail pour la confirmation.