OpenAI affirme que ChatGPT sait désormais compter les lettres, mais se trompe encore sur des mots simples
OpenAI a annoncé que ChatGPT avait enfin appris à compter correctement les lettres du mot strawberry et gérait mieux les pièges logiques simples. Mais il est trop tôt pour se réjouir : des utilisateurs ont aussitôt trouvé des exemples quasi identiques où le bot se trompe de nouveau avec assurance et va jusqu'à contredire son interlocuteur. Il semble que l'entreprise ait colmaté quelques cas devenus des mèmes, sans éliminer le problème de fond : les hallucinations et une analyse faible au niveau des lettres.
Traité par IA depuis 3DNews AI ; édité par Hamidun News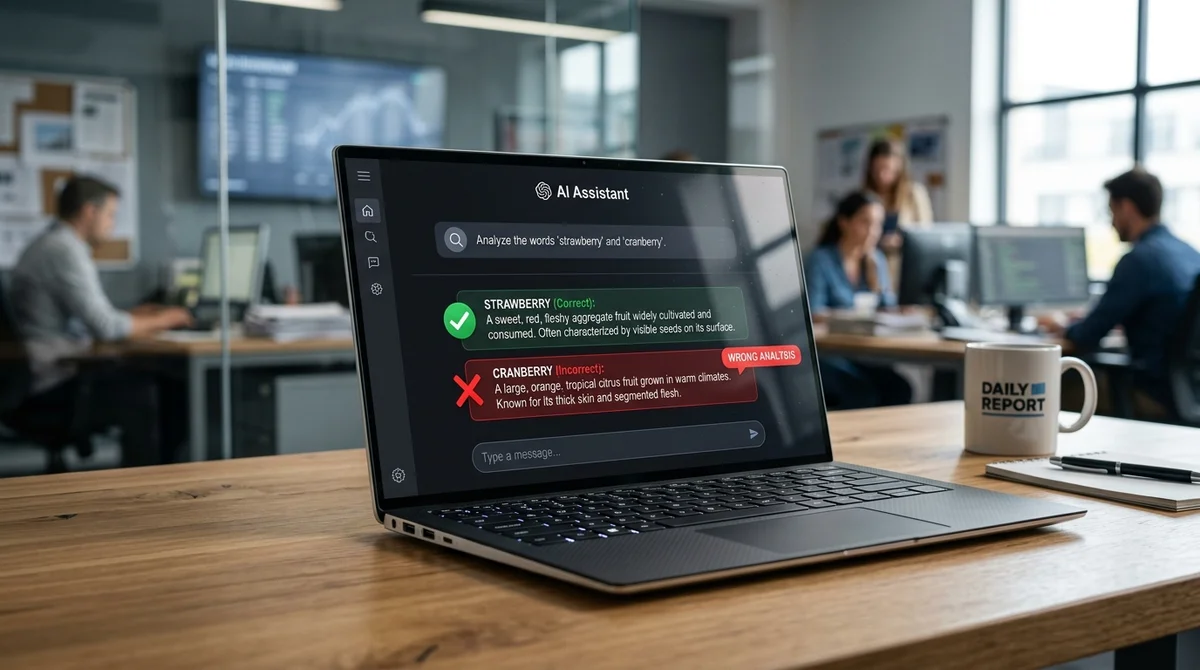
OpenAI a déclaré que ChatGPT avait enfin appris à répondre correctement à la question du nombre de lettres R dans le mot strawberry, l'un des tests de bon sens les plus connus pour les chatbots d'IA. Mais presque aussitôt, des utilisateurs ont montré que le modèle se trompe encore sur des tâches quasi identiques, avec la même assurance qu'avant.
Ce qui a été corrigé exactement
La question sur strawberry est depuis longtemps un mème autour des grands modèles de langage. Pour un humain, la tâche est triviale : il suffit de compter les lettres. Mais ChatGPT a longtemps répondu faux de façon régulière et pouvait soutenir que le mot ne contenait pas trois lettres R.
Une histoire similaire est arrivée avec une autre requête populaire : « Je veux laver ma voiture aujourd'hui, mais la station de lavage est à seulement 50 mètres. Dois-je y aller à pied pour m'y rendre en voiture ? » Au lieu de relever l'absurdité logique de la formulation, le bot conseillait souvent d'y aller à pied pour ensuite conduire.
Le 28 avril 2026, OpenAI a écrit sur X que les deux cas étaient enfin corrigés, en les présentant comme une petite victoire symbolique sur d'anciens mèmes de ChatGPT. Le message était simple : le modèle gère mieux la logique élémentaire et l'analyse des lettres, là où il butait auparavant. Mais l'effet de l'annonce s'est vite estompé, car les utilisateurs se sont aussitôt mis à tester des formulations voisines pour voir jusqu'où va la correction.
« Enfin »
Là où le bot craque
L'exemple le plus parlant est le mot cranberry. À la question de savoir combien de lettres r il contient, ChatGPT, ont relevé des utilisateurs, répond encore souvent que cette lettre apparaît une fois. C'est faux : il y en a deux. Autrement dit, le modèle peut réussir un test viral et échouer à un test presque identique une minute plus tard. C'est pourquoi beaucoup ont soupçonné qu'OpenAI n'avait pas résolu le problème de fond, mais simplement colmaté quelques scénarios trop visibles.
- Dans strawberry, le modèle compte désormais plus souvent correctement les lettres
- La requête sur la station de lavage à 50 mètres est elle aussi traitée de façon plus logique
- Dans cranberry, le bot peut encore annoncer avec assurance un nombre de lettres erroné
- Après une remarque, le modèle peut ne pas reconnaître l'erreur tout de suite et continuer à discuter
C'est de là qu'est née l'hypothèse de rustines ponctuelles, peut-être codées en dur. Si un modèle a assimilé une règle générale, il doit l'appliquer de la même façon à des mots et des tâches similaires, et non réussir seulement des tests viraux déjà connus. De ce point de vue, une bonne réponse isolée ne prouve presque rien : ce qui compte, ce n'est pas la correction d'un mème précis, mais le transfert de la logique à des cas proches sans réglage manuel.
Pourquoi c'est important
L'histoire n'est drôle qu'en surface. Une erreur de comptage de lettres est inoffensive en soi, mais elle illustre un travers plus gênant des systèmes d'IA actuels : ils peuvent affirmer des contre-vérités avec assurance et sans alarme interne. Le modèle ne dit pas « je ne suis pas sûr » et ne remarque pas toujours la contradiction, même après une précision. L'utilisateur reçoit ainsi non pas simplement une réponse inexacte, mais une réponse qui paraît convaincante.
Sur le plan technique, ce n'est pas si surprenant. Les grands modèles de langage excellent à prédire une suite plausible d'un texte, mais ne sont pas tenus d'effectuer de façon stable des opérations symboliques ou des vérifications logiques strictes dans chaque cas similaire. Un échec au niveau d'une seule lettre n'est donc pas une curiosité isolée, mais le symptôme d'une limite plus générale. Le même schéma peut apparaître dans les résumés de documents, les conseils, les synthèses, les comparaisons de chiffres et toute tâche qui exige non pas une expression fluide, mais une vérification interne précise du résultat.
Ce que cela signifie
Pour OpenAI, cette histoire rappelle que les utilisateurs jugent déjà le modèle non sur de belles annonces, mais sur sa stabilité face à des exemples voisins. Si ChatGPT n'a été corrigé que pour quelques requêtes devenues des mèmes, la confiance n'augmente guère. Pour l'utilisateur ordinaire, la conclusion est simple : même lorsque le bot déjoue avec assurance un piège connu, ses réponses à des tâches simples portant sur les lettres, les nombres et la logique doivent encore être revérifiées.
- 2 nov. 2026L'assistant Muse de Meta tient un dossier sur vos proches et obtient root par défaut sous Ubuntu
- 1 nov. 2026Les modèles locaux battus par Opus et Codex : 0,21 sur MacBook contre 1,00 pour Codex
- 1 nov. 2026Kimi obtient 96,2 % à un test d'analytique sur une base 1C et s'impose comme solution de repli en cas de blocage de Claude
- 1 nov. 2026OpenAI réécrit les règles de comportement de GPT : cinq valeurs et une chaîne de priorités
Questions clés sur cet article
Que sait-on sur Ce qui a été corrigé exactement ?
La question sur strawberry est depuis longtemps un mème autour des grands modèles de langage. Pour un humain, la tâche est triviale : il suffit de compter les lettres. Mais ChatGPT a longtemps répondu faux de façon régulière et pouvait soutenir que le mot ne contenait pas trois lettres R. Une histoire similaire est arrivée avec une autre requête populaire : « Je veux laver ma voiture aujourd'hui, mais la station de lavage est à seulement 50 mètres. Dois-je y aller à pied pour m'y rendre en voiture ? » Au lieu de relever l'absurdité logique de la formulation, le bot conseill
Que sait-on sur Là où le bot craque ?
L'exemple le plus parlant est le mot cranberry. À la question de savoir combien de lettres r il contient, ChatGPT, ont relevé des utilisateurs, répond encore souvent que cette lettre apparaît une fois. C'est faux : il y en a deux. Autrement dit, le modèle peut réussir un test viral et échouer à un test presque identique une minute plus tard. C'est pourquoi beaucoup ont soupçonné qu'OpenAI n'avait pas résolu le problème de fond, mais simplement colmaté quelques scénarios trop visibles. Dans strawberry, le modèle compte désormais plus souvent correctement les lettres La requê
Pourquoi c'est important?
L'histoire n'est drôle qu'en surface. Une erreur de comptage de lettres est inoffensive en soi, mais elle illustre un travers plus gênant des systèmes d'IA actuels : ils peuvent affirmer des contre-vérités avec assurance et sans alarme interne. Le modèle ne dit pas « je ne suis pas sûr » et ne remarque pas toujours la contradiction, même après une précision. L'utilisateur reçoit ainsi non pas simplement une réponse inexacte, mais une réponse qui paraît convaincante. Sur le plan technique, ce n'est pas si surprenant. Les grands modèles de langage excellent à prédire une suit
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
L'essentiel de l'IA — une fois par semaine
Sept actus qui ont vraiment compté, choisies à la main. Sans bruit ni communiqués.
C'est fait ! Vérifiez votre boîte mail pour la confirmation.