النماذج اللغوية المحلية
النماذج اللغوية المحلية هي نماذج تعمل مباشرة على عتادك الخاص — حاسوب محمول أو جهاز بمعالج رسوميات أو خادم منزلي — دون سحابة أو اشتراكات أو خروج البيانات من جهازك. أدوات مثل Ollama و llama.cpp و LM Studio مع نسخ GGUF المكمَّمة من Llama و Qwen و Gemma تجعل ذلك ممكنًا حتى على بطاقة رسوميات عمرها عشر سنوات. هنا كل تغطيتنا لتشغيل الذكاء الاصطناعي محليًا: أدلة عملية واختبارات العتاد والتكميم والخصوصية.
سبير تطوّر GigaChain دون نسخة متفرعة من LangChain وتراهن على حزمة التوافق
كشفت سبير كيف تطوّر GigaChain حول GigaChat: تخلّى الفريق عن نسخة LangChain المتفرعة الثقيلة، وأنشأ حزمة توافق، ويبني منظومة مفتوحة لوكلاء الذكاء الاصطناعي.
رؤية محلية لـ z.ai GLM-5.1: نموذج 8B يغلق 70% من الفجوة مع النماذج الرائدة
أوضح مطوّر كيف يمكن منح وكيل برمجة منخفض التكلفة قائم على z.ai GLM-5.1 «رؤية» محلية عبر خادم MCP ونموذج qwen3-vl:8b، ليتحقق بنفسه من الواجهة اعتمادًا على لقطات…
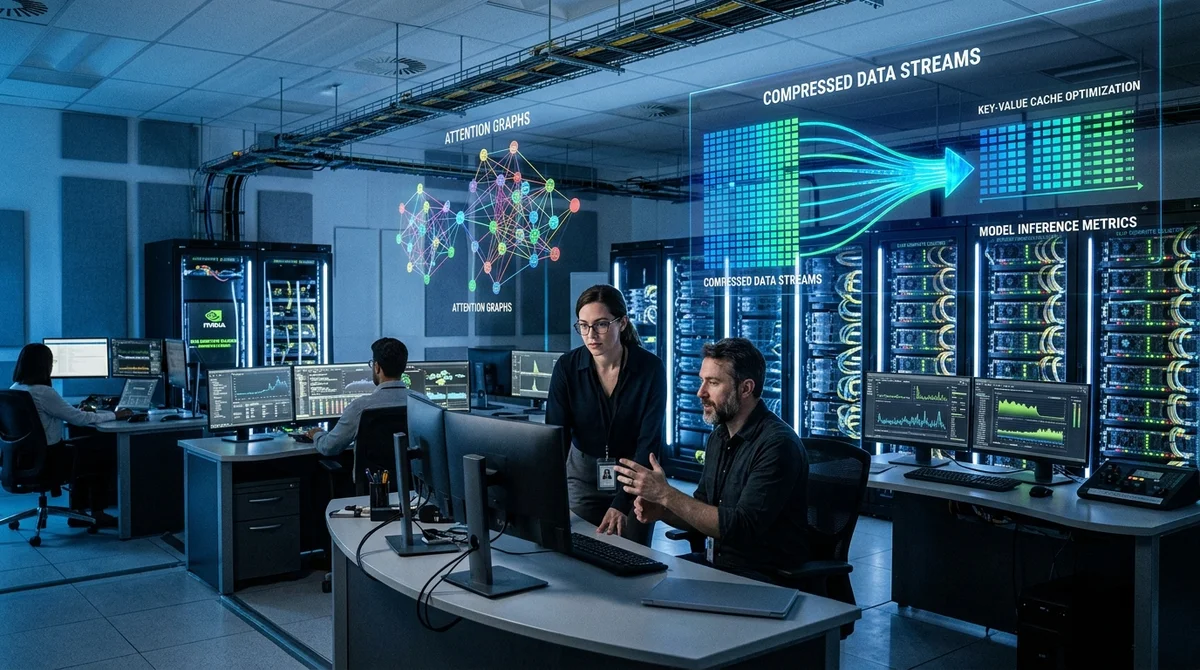
DeepSeek وGoogle وMeta: 10 تقنيات لضغط KV-cache في نماذج LLM لخفض استهلاك الذاكرة أثناء الاستدلال
أصبح KV-cache أكبر مستهلك لذاكرة GPU في نماذج LLM الكبيرة. ويستعرض تقرير جديد 10 أساليب، من H2O وSnapKV إلى TurboQuant وMLA من DeepSeek، تقلّص استهلاك الذاكرة دون…
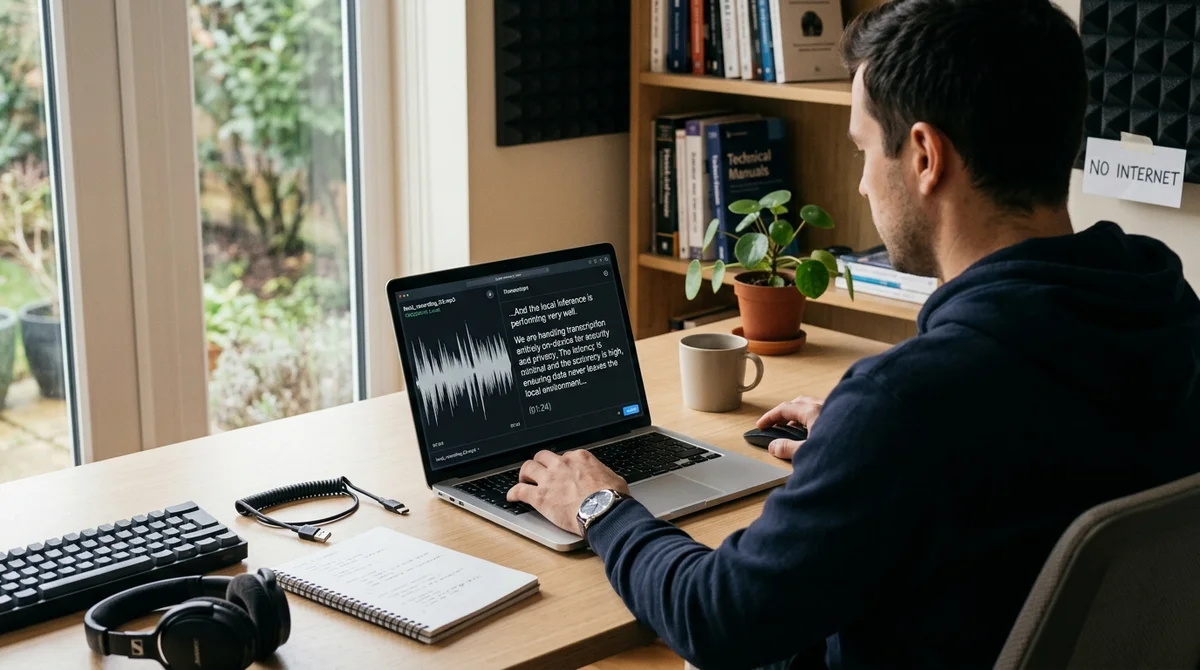
Whisper وFaster-Whisper: كيف تفرّغ الملفات الصوتية محليًا دون إرسالها إلى السحابة
Nvidia تطلق Nemotron 3 Nano Omni: نموذج مفتوح متعدد الوسائط لوكلاء الحوسبة الطرفية
Anthropic وOpenClaude: لماذا لا يُعد Claude Code «المجاني» في 2026 مجانيًا تمامًا
ruGPT3XL تحصل على سياق 8k: النموذج المُستعاد يتجاوز حد 2k دون خسائر تُذكر
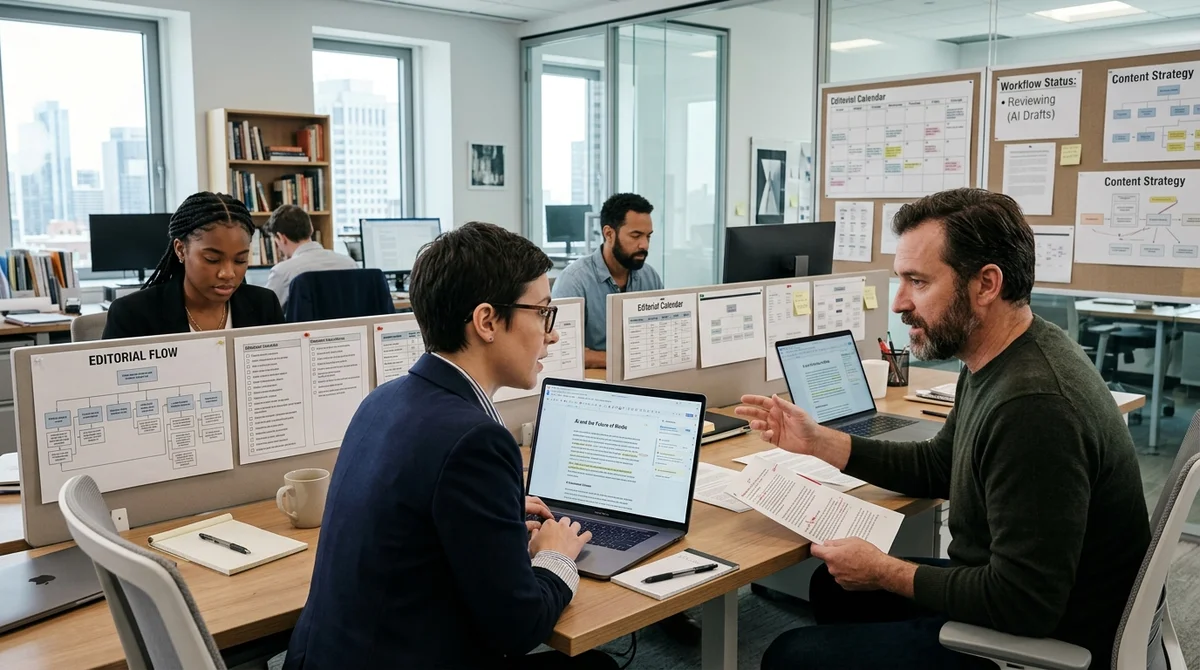
M2 أوكلت إلى الذكاء الاصطناعي 40% من نصوصها التسويقية دون أن تفقد جودة المحتوى
دمج فريق M2 كاتب نصوص يعمل بالذكاء الاصطناعي في هيئة التحرير الداخلية، ونقل إليه 40% من النصوص التسويقية ونصوص المنتجات، مع الحفاظ على نبرة موحدة ورقابة على الجودة…
Habr AI يوضح كيفية إضافة الذاكرة والسياق إلى دردشة LLM بلغة Python باستخدام Ollama وLiteLLM
يوضح الجزء الجديد من الدليل التعليمي لدردشة Python مع Ollama وLiteLLM كيفية حفظ سجل الرسائل وتمرير السياق إلى النموذج وتقييد الذاكرة دون تعقيد البنية.
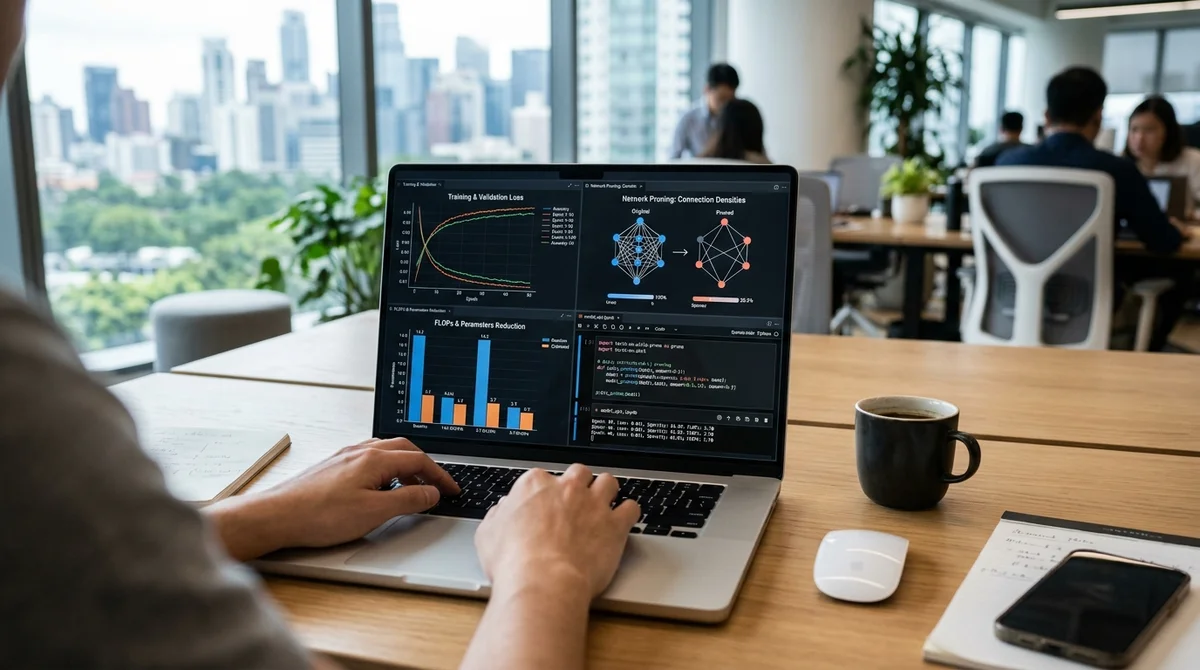
NVIDIA تعرض مسارًا متكاملًا لتحسين النماذج باستخدام FastNAS pruning وfine-tuning
Qwen وllama.cpp: كيف تشغّل نموذج ذكاء اصطناعي محليًا دون سحابة على حاسوبك أو خادمك
الذكاء الاصطناعي للمنزل الذكي: Llama 8B محليًا، والمطبّات الحقيقية، وكيف تستغني عن السحابة
كيف حوّل كاتب على Habr سبعة سيناريوهات n8n إلى منظومة أخبار ذكية مستقلة
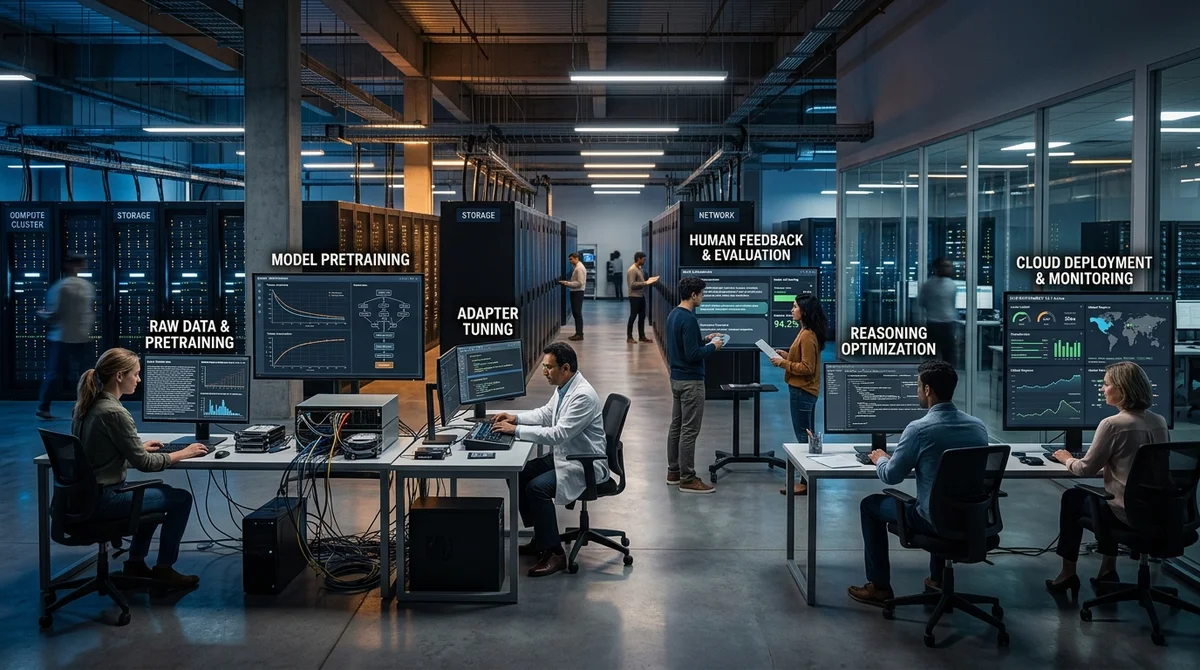
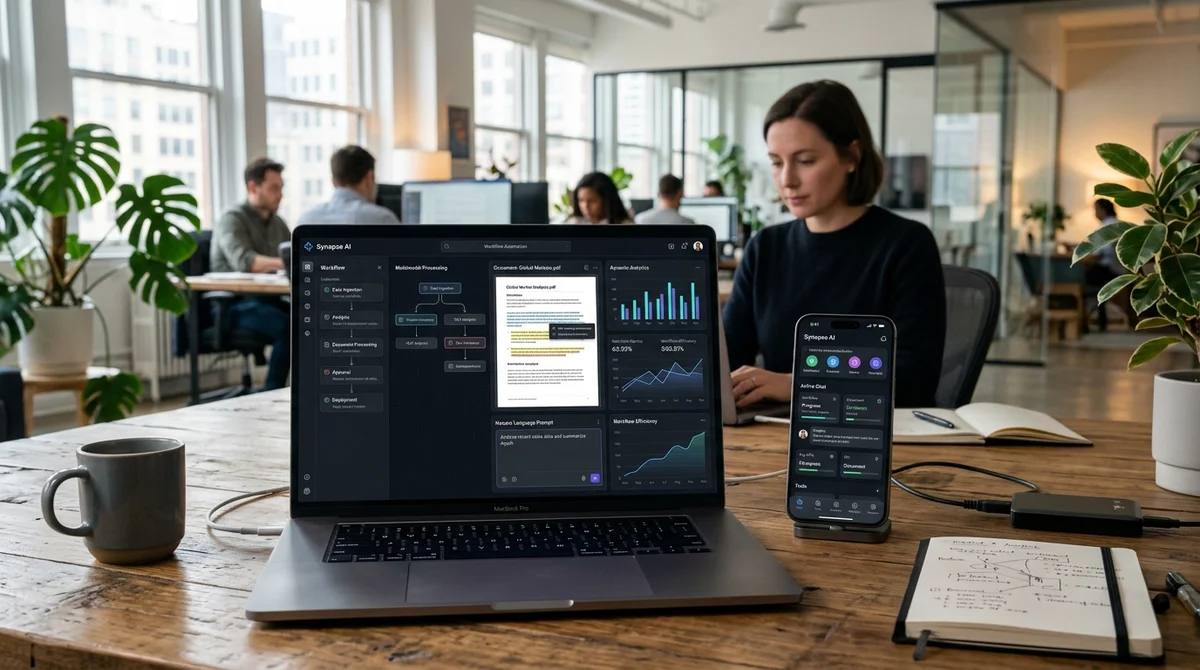
GPTunneL واتجاه Forbes: لماذا أصبحت التطبيقات الفائقة للذكاء الاصطناعي نقطة النمو الجديدة في السوق
تروي GPTunneL، التي بلغ عدد مستخدميها 2 مليون، كيف تغيّر التطبيقات الفائقة للذكاء الاصطناعي سلوك الجمهور وطلب الشركات واقتصاد السوق، من الصين والولايات المتحدة إلى…
Habr يستعرض كيفية تدريب نموذج LLM مصغّر بلغة C# عبر ILGPU ورسوميات AMD المدمجة
نشر Habr شرحًا لكيفية بناء نموذج LLM صغير جدًا وتدريبه بلغة C# باستخدام ILGPU وOpenCL، ثم تصديره بصيغة GGUF وتشغيله في LM Studio حتى على رسوميات AMD المدمجة.