Habr يستعرض كيفية تدريب نموذج LLM مصغّر بلغة C# عبر ILGPU ورسوميات AMD المدمجة
عرض Habr دورة كاملة لبناء نموذج LLM مصغّر بلغة C# دون Python ودون بطاقة NVIDIA إلزامية. استخدم المؤلف ILGPU وOpenCL، ودرّب النموذج على رسوميات AMD المدمجة، ثم حزمه بصيغة GGUF وفتحه في LM Studio. النتيجة متواضعة من حيث الجودة، لكنها مهمة بوصفها proof of concept لمطوّري .NET الذين يحتاجون إلى تجربة محلية واضحة مع نماذج LLM.
معالج بواسطة الذكاء الاصطناعي من Habr AI؛ بتحرير Hamidun News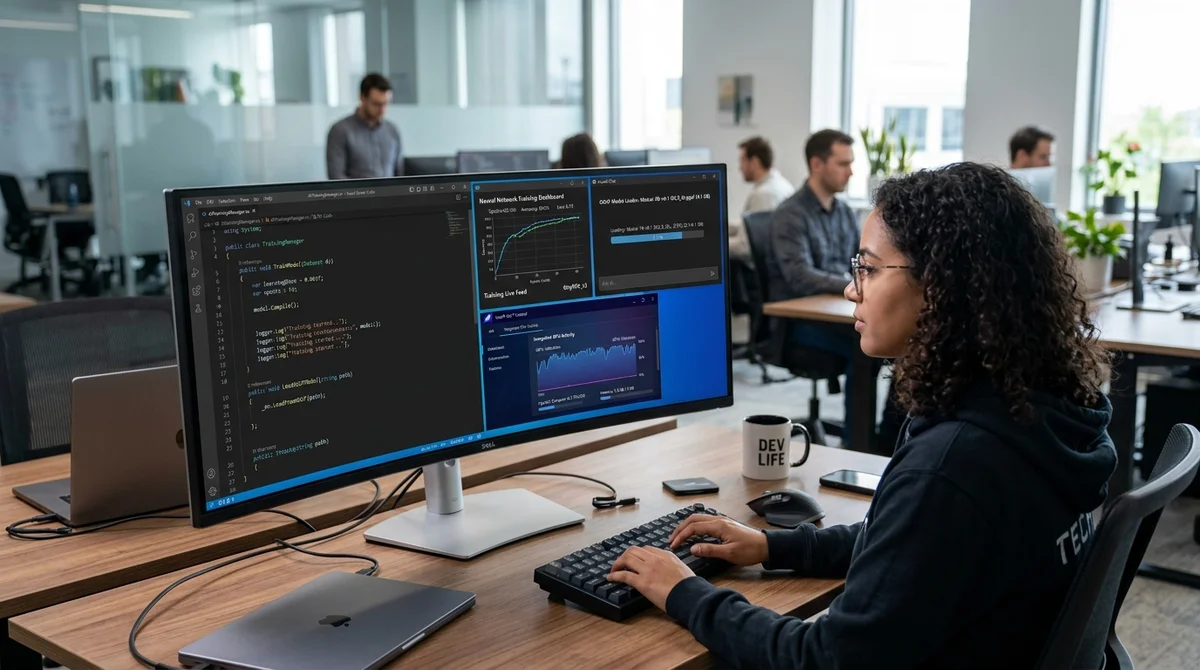
نشر Habr شرحًا عمليًا مفصلًا يعرض سيناريو نادرًا في مجتمع الذكاء الاصطناعي المحلي: يمكن بناء نموذج لغوي صغير وتدريبه من الصفر بلغة C#، دون Python ودون بطاقة NVIDIA إلزامية، ثم حفظه بصيغة GGUF وتشغيله في LM Studio. استخدم المؤلف مكتبة ILGPU وOpenCL معتمدًا على رسوميات AMD المدمجة، وحصل على نموذج LLM أوّلي يعمل، وإن كان محدودًا جدًا، بحجم نحو 422 كيلوبايت. صُمّم المشروع كعرض تعليمي للدورة الكاملة، وليس كمحاولة لمنافسة النماذج المفتوحة المصدر الكبيرة.
يتناول المقال البنية الأساسية للمحوّل (transformer): التقسيم إلى رموز (tokenization)، وطبقة embedding، وآلية self-attention، وطبقة feed-forward، والتطبيع، والإسقاط الخرجي. وللتدريب أعدّ المؤلف مجموعتَي بيانات صغيرتين: مدوّنة pretrain قصيرة تضم حقائق عامة عن العالم، وعيّنة instruction-tuning تحتوي على أسئلة وأجوبة. لم يكن الهدف الحصول على نموذج قوي، بل المرور يدويًا بكل المراحل، من بناء المفردات إلى الاستدلال (inference).
جاءت الإعدادات النهائية مدمجة إلى أقصى حد: مفردات من 512 رمزًا، وطول سياق 64، وembedding بحجم 64، وطبقة مخفية بحجم 128، وطبقة محوّل واحدة، ورأسا attention. يبلغ المجموع 103 744 معامل. وقبل التصدير يمكن حفظ النموذج في ملف ثنائي بحجم نحو 6,87 ميغابايت، لكن ملف GGUF النهائي يشغل نحو 422 كيلوبايت ويُعرَّف على أنه GGUF V3. بعد التدريب انخفضت قيمة pretrain-loss إلى نحو 0,212، وبعد الضبط الدقيق لصيغة الحوار انخفضت قيمة finetune-loss إلى 0,3926. وعند هذا الحجم، هذه الأرقام دليل على أن المخطط يعمل تقنيًا أكثر مما هي دليل على جودة الإجابات.
كما أن منطق التدريب نفسه مهم. يمرّ النموذج أولًا بمرحلة تدريب أولي على مدوّنة قصيرة من عشرات الجمل، ثم بمرحلة منفصلة من instruction tuning على أمثلة حوارية. وتتضمن واجهة البرنامج قائمة لإعادة التدريب، واختبار المقسّم إلى رموز (tokenizer)، وحفظ الأوزان، وتشغيل دردشة تفاعلية. وأضاف المؤلف فلتر ثقة بدائيًا للإجابات: إذا انخفض الحد الأدنى للثقة على مستوى الرموز عن عتبة معينة، يعرض النظام عبارة «затрудняюсь ответить» (أجد صعوبة في الإجابة) بدلًا من الإجابة. وهي طريقة فجّة لكنها مفهومة لإخفاء المخرجات العشوائية الواضحة التي يكاد يكون ظهورها حتميًا في نموذج بهذا الحجم. وهذا ما يجعل العرض صالحًا على الأقل للتحقق الأساسي من خط المعالجة (pipeline).
لم يكن الجزء الأصعب هو forward pass ولا التدريب نفسه، بل التوافق مع منظومة llama.cpp. حاول المؤلف في البداية بناء النموذج بإعدادات أقرب إلى LLaMA، لكنه اصطدم بأخطاء عند التحميل وبعدم تطابق عدد التنسورات. وفي النهاية اضطر إلى تبسيط البنية، وإعادة بناء المقسّم إلى رموز (tokenizer) على غرار Microsoft.ML.Tokenizers، ووصف بيانات GGUF الوصفية بدقة: البنية، وطول السياق، ومعاملات الانتباه، والرموز الخاصة، وقالب الدردشة (chat template). ومن التفاصيل التقنية الخاصة أن النموذج لا يحتفظ فعليًا بتاريخ حوار طويل، ولذلك يُستخدم في الدردشة قالب يتضمن آخر رسالة للمستخدم فقط، وإلا فإن السياق الصغير جدًا يعطّل الاستدلال بسرعة.
النتيجة العملية متواضعة لكنها دالّة. يجيب النموذج عن الطلبات البسيطة، ويُفتح في LM Studio ويمكنه العمل عبر منظومة متوافقة، لكن llama.cpp يحذّر من تدهور جودة التوليد، ويكتب المؤلف صراحةً أن التدريب ما زال غير جيد بما يكفي. إضافة إلى ذلك، ينهار الاستدلال عند بعض الطلبات التي تحتوي على علامات استفهام وتعجب، أي أن المشروع يظل تجربة ومنصة تعليمية. لكن أهمية العمل تكمن في سبب آخر: فهو يبيّن أن عتبة الدخول إلى التجارب منخفضة المستوى مع نماذج LLM يمكن خفضها كثيرًا. وبالنسبة إلى مطوّري عالم .NET، هو مثال واضح على كيفية بناء نموذج أدنى، واختبار سيناريو OpenCL خارج احتكار CUDA، وفهم التفاصيل التي يتألف منها فعليًا تشغيل نموذج لغوي محليًا.
Access Frontier LLMs & Multimodal AI in One Workspace
Discover NomadNet AI (nomadnet.ai) — unified access to frontier language models, research synthesis, and multimodal workflows.
أهم ما في عالم الذكاء الاصطناعي — مرة كل أسبوع
سبع قصص مهمة فعلاً هذا الأسبوع، مختارة بعناية. بلا ضجيج ولا بيانات صحفية.
تم! تحقق من بريدك للتأكيد.