Google Gemma 4 وNVIDIA وOpenClaw: وكلاء ذكاء اصطناعي محليون دون دفع مقابل كل رمز
تروّج Google بالتعاون مع NVIDIA لنموذج Gemma 4 بوصفه أساسًا لوكلاء الذكاء الاصطناعي المحليين. يمكن تشغيل النماذج على Jetson Orin Nano وأجهزة الكمبيوتر المزوّدة ببطاقات RTX وعلى DGX Spark، ويزيل الجمع بينها وبين OpenClaw العائق الأكبر أمام سيناريوهات العمل الدائم (always-on)، وهو النفقات المستمرة على واجهات API. ثمة تنبيه مهم: ففي حالة البيانات المؤسسية والحساسة، تروّج NVIDIA بشكل منفصل لـ NemoClaw المزوّد بقيود العزل (sandbox) وسياسات الوصول.
معالج بواسطة الذكاء الاصطناعي من MarkTechPost؛ بتحرير Hamidun News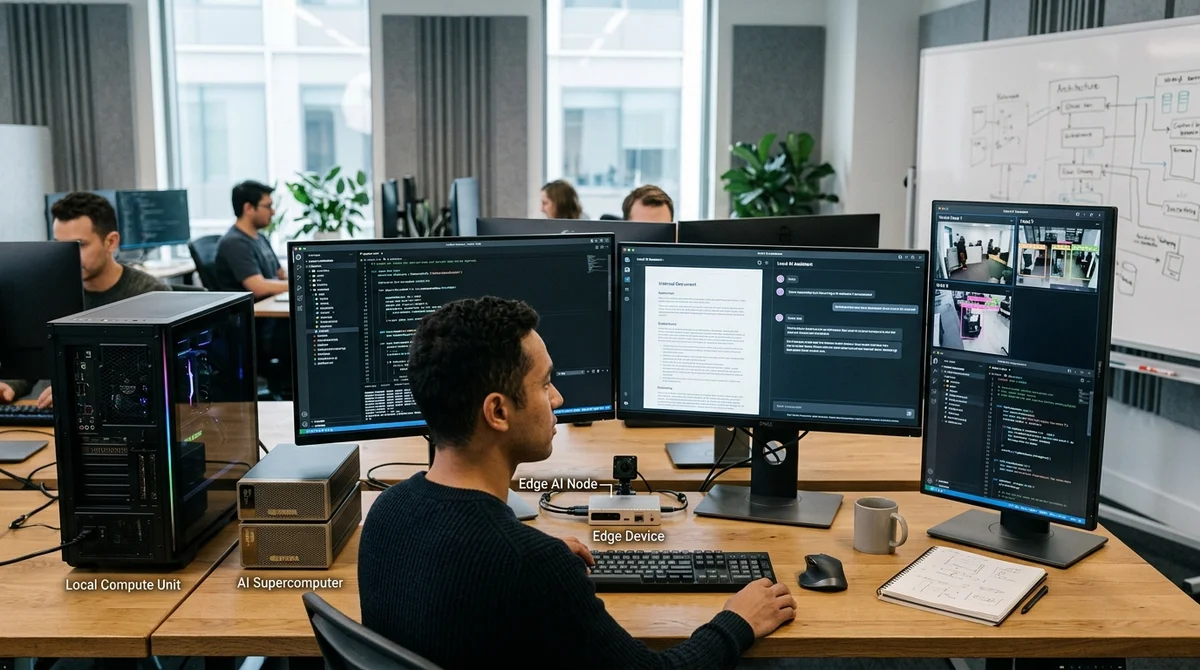
فكرة المقال بسيطة: إذا كان على وكيل الذكاء الاصطناعي أن يعمل باستمرار، وأن يرى الشاشة، ويقرأ الملفات المحلية، ويحلّل المستندات، ويشغّل الإجراءات في الخلفية، فإن النموذج المدفوع بحسب الرموز عبر واجهة API سحابية يتحول بسرعة كبيرة إلى خدمة باهظة الثمن. وتقترح Google وNVIDIA ومنظومة OpenClaw مسارًا مختلفًا: إبقاء النموذج قرب البيانات وتشغيله على عتاد محلي، وبذلك يزول التأخير، وتزول معه أيضًا منطق «الدفع عن كل خطوة» يخطوها الوكيل.
يُقصد بـ«ضريبة الرموز» هنا ليس النفقات لمرة واحدة على روبوت دردشة، بل الأثر التراكمي للمساعدين العاملين دون توقف. فمثل هذه الأنظمة تقرأ السياق باستمرار: المراسلات ونوافذ التطبيقات والشيفرة البرمجية والمستندات والتقويم والمجلدات والإشعارات. وإذا مُرّرت كل ملاحظة وكل استنتاج وسيط وكل إجراء عبر نموذج سحابي، تصبح التكلفة غير قابلة للتنبؤ بسرعة. وبالنسبة إلى المساعد الشخصي، يضغط ذلك على الميزانية، أما في السيناريو المؤسسي فيُضاف إليه سؤال الخصوصية: إذ تضطر الجهة إلى إرسال بيانات حساسة إلى الخارج بانتظام. لذلك لا يُعدّ التشغيل المحلي هنا مسألة أيديولوجية، بل ضرورة اقتصادية وتشغيلية.
ويؤدي دورًا محوريًا في هذا النهج نماذج Google Gemma 4 التي قُدّمت في 2 أبريل 2026. أصدرت Google أربعة إصدارات: E2B وE4B و26B و31B. النماذج الأصغر مصمّمة للأجهزة الطرفية وسيناريوهات الهواتف المحمولة، أما الأكبر فموجّهة إلى الاستدلال (reasoning) والبرمجة وسير العمل الوكيلي (agentic workflow) على محطات العمل، علمًا بأن نموذج 26B يعتمد بنية مزيج الخبراء (Mixture of Experts) ولا يفعّل أثناء الاستدلال سوى 3,8 مليار معامل. وتدعم Gemma 4 بشكل أصيل استدعاء الدوال (function calling) والمخرجات المنظّمة بصيغة JSON وتعليمات النظام، أي كل ما يلزم لوكيل موثوق يستخدم الأدوات. وتتعامل جميع النماذج مع الصور والفيديو، بينما يدعم E2B وE4B كذلك إدخال الصوت بشكل أصيل. ويصل حجم نافذة السياق في النماذج الطرفية إلى 128K رمز، وفي النماذج الأكبر إلى 256K.
ووفق بيانات Google في 2 أبريل 2026، احتل إصدار 31B المرتبة الثالثة بين النماذج المفتوحة في Arena AI، واحتل 26B المرتبة السادسة، وتؤكد الشركة أن هذه الفئة تتفوق على نماذج أكبر منها حجمًا بكثير. ومن المهم أيضًا أن Gemma 4 تُوزَّع بموجب ترخيص Apache 2.0، وأن عائلة Gemma بلغت وقت الإصدار أكثر من 400 مليون عملية تنزيل وما يزيد على 100 ألف نسخة معدّلة في المنظومة.
أما النصف الثاني من القصة فيتعلق بالعتاد ومنظومة التشغيل. تروّج NVIDIA لـ Gemma 4 بوصفها فئة نماذج تتدرّج من Jetson Orin Nano إلى GeForce RTX وRTX Pro وDGX Spark دون تغيير يُذكر في النهج. وفي السيناريوهات الطرفية، يدعم Jetson Orin Nano النموذجين E2B وE4B، ما يتيح بناء أنظمة بصرية وصوتية مستقلة ذات زمن استجابة منخفض على الجهاز نفسه.
أما لمحطات العمل المحلية والمساعدين الشخصيين، فينتقل التركيز إلى 26B و31B، اللذين يمكن تشغيلهما عبر Ollama وllama.cpp وvLLM وUnsloth. ويحظى DGX Spark بأهمية خاصة هنا: إذ تبرز NVIDIA بشكل منفصل تهيئته المزوّدة بـ GB10 Grace Blackwell Superchip وذاكرة موحّدة سعتها 128 ГБ باعتبارها نقطة دخول مناسبة للنمذجة الأولية المحلية والضبط الدقيق وتشغيل النماذج الكبيرة دون سحابة.
وفي هذا الوضع يتحول OpenClaw من «غلاف فوق واجهة API بعيدة» إلى وكيل محلي حقيقي يستمد السياق من الملفات والتطبيقات وسير العمل مباشرة على جهاز المستخدم.
وفي الواقع، يجعل OpenClaw هذه القصة مفهومة على المستوى العملي. فهو وكيل ينطلق من مبدأ المحلية أولًا (local-first)، ويمكنه البقاء على الحاسوب بصورة دائمة، والاتصال بتطبيقات المراسلة، وتذكّر حالة المهام، واستدعاء الأدوات. وبالنسبة إليه، لا يُعدّ النموذج المحلي ميزة إضافية لطيفة، بل شرطًا أساسيًا لاقتصاديات سليمة. فإذا كان على الوكيل أن يقرأ قاعدة الشيفرة طوال اليوم، ويتابع المشاريع، ويرد في المحادثات، أو يحلّل مستندات مالية، فإن التسعير السحابي بحسب الرموز يصبح القيد الرئيسي.
ومع ذلك، لا تحلّ المحلية وحدها مسألة الأمان: فالوكيل الذي يملك صلاحية الوصول إلى الملفات والشبكة والحسابات يبقى كيانًا محفوفًا بالمخاطر. لذلك تروّج NVIDIA بالتوازي لـ NemoClaw، وهي منظومة مفتوحة تضم OpenShell وحواجز حماية قائمة على السياسات (policy-based guardrails)، يُفترض أن تقيّد سلوك الوكلاء العاملين باستمرار، وتعزل تنفيذهم داخل بيئة معزولة (sandbox)، وتُبقي البيانات الحساسة داخل النطاق المحلي.
وعمليًا يعني ذلك تحوّلًا في نموذج استهلاك الذكاء الاصطناعي نفسه. فلم يعد السؤال مقتصرًا على مدى ذكاء النموذج في الاختبارات، بل على إمكانية إبقائه قيد التشغيل طوال اليوم دون خشية من الفاتورة أو التأخير أو تسرب البيانات. ويُظهر الجمع بين Gemma 4 وNVIDIA RTX أو DGX Spark وOpenClaw أن السوق يتجه نحو وكلاء شخصيين ومؤسسيين يعملون أقرب إلى البيانات وأقرب إلى المستخدم. لن تختفي السحابة، لكن الاستدلال المحلي (inference) لم يعد، في حالة المساعدين العاملين دون توقف والشيفرة المحلية وإدارة المستندات والروبوتات والملفات الحساسة، خيارًا هامشيًا، بل أصبح البنية الأساسية.
- 31 أكتوبر 2026الأنطولوجيا مدقِّقًا لوكيل الذكاء الاصطناعي: على UniProt تتفوق علامات الخطأ فيها على الصدفة بهامش ضئيل فقط
- 31 أكتوبر 2026IBM: طرح أسئلة على العميل قبل التوليد رفع دقة العقود الذكية من 54% إلى 73%
- 30 أكتوبر 2026Mistral تفتح أوزان Large 4: قوي في البرمجة، لكن النماذج الصينية تسجل 32 نقطة مقابل 26
- 30 أكتوبر 2026Google: وكلاء الذكاء الاصطناعي مع Android CLI ينجزون مهام الواجهات أسرع بنسبة 77%
Delegate Deep Research, Coding & Multi-Step Workflows to Nomad Agent
Deploy autonomous task execution with Nomad Agent (agent.nomadnet.ai) — automated web research, data synthesis, code generation, and MCP tool orchestration.
أهم ما في عالم الذكاء الاصطناعي — مرة كل أسبوع
سبع قصص مهمة فعلاً هذا الأسبوع، مختارة بعناية. بلا ضجيج ولا بيانات صحفية.
تم! تحقق من بريدك للتأكيد.