NVIDIA تستعرض تشغيل Gemma 4 بالصوت وكاميرا الويب على Jetson Orin Nano Super
أعدّت NVIDIA عرضًا محليًا لنموذج Gemma 4 على Jetson Orin Nano Super: يستمع النموذج إلى الصوت، ويلجأ بنفسه إلى كاميرا الويب عند الحاجة، ثم يرد عبر TTS. وتعتمد المنظومة على Parakeet للتعرف على الكلام وKokoro لتوليد الصوت وllama.cpp مع vision projector. والنتيجة الأبرز أن وكيلًا متعدد الوسائط يعمل على لوحة صغيرة بذاكرة 8 غيغابايت دون الحاجة الإلزامية إلى السحابة.
معالج بواسطة الذكاء الاصطناعي من Hugging Face Blog؛ بتحرير Hamidun News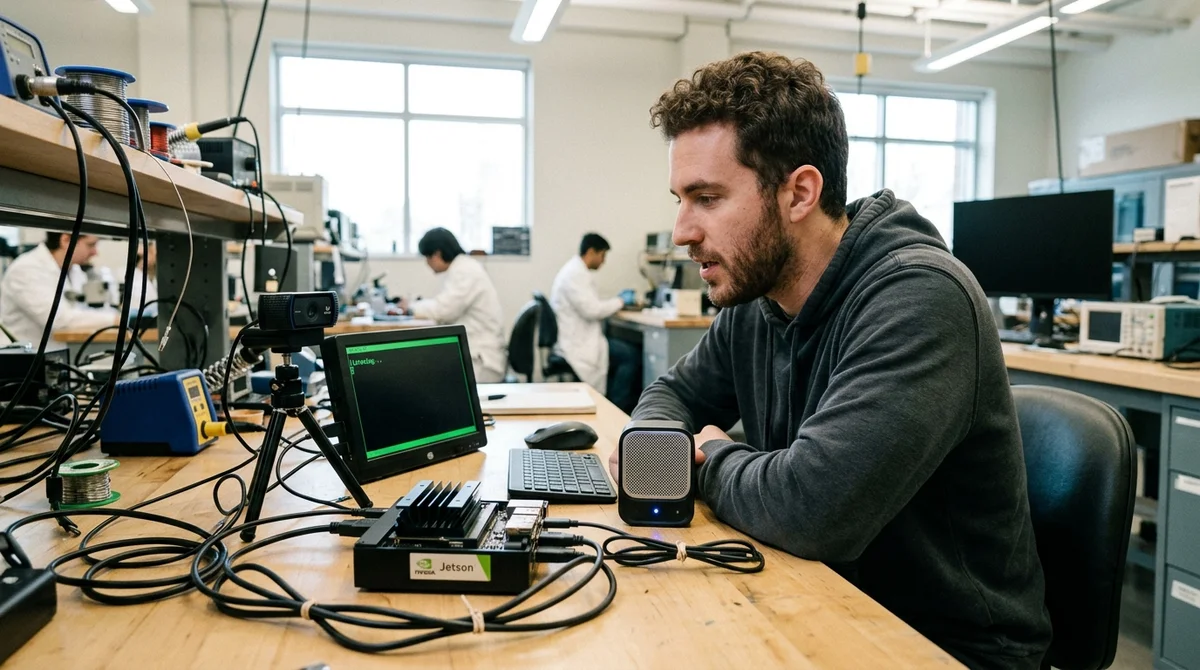
عرضت NVIDIA نموذجًا عمليًا لتطبيقات الحوسبة الطرفية (edge): يستمع Gemma 4 إلى السؤال، ويستعين بنفسه بكاميرا الويب عند الحاجة، ثم يرد بالصوت، وكل ذلك محليًا على Jetson Orin Nano Super بذاكرة 8 غيغابايت. ولا تكمن أهمية المنشور، الصادر في 22 أبريل 2026، في الدليل التعليمي وحده، بل في أن وكيلًا متعدد الوسائط يعمل على لوحة صغيرة بدلًا من السحابة.
كيف تعمل المنظومة
صُمّم السيناريو كوكيل صوتي بسيط يملك أداة بصرية واحدة. يضغط المستخدم على مفتاح المسافة ويطرح سؤاله بالصوت، ثم يحوّل Parakeet الكلام إلى نص محليًا. بعد ذلك يتلقى Gemma 4 الطلب ويقرر بنفسه ما إذا كان يحتاج إلى النظر عبر كاميرا الويب. إذا احتاج، يلتقط السكربت إطارًا ويمرره إلى النموذج، ثم يُنطق الرد عبر Kokoro TTS. ويؤكد المقال تحديدًا أن النموذج لا يصف الصورة بوجه عام، بل يستخدم ما رآه فقط للإجابة عن السؤال المطروح.
«بصراحة، يكفي أن هذا يعمل على Jetson Orin Nano لكي يكون مثيرًا للإعجاب».
النقطة المحورية هنا أنه لا توجد محفزات صارمة ولا منطق يدوي من نوع «إذا ورد في السؤال كلمة camera». فالسكربت يتيح لـ Gemma 4 أداة (tool) واحدة فقط هي look_and_answer، تلتقط صورة وتحلل المشهد. أما استدعاؤها من عدمه فيقرره النموذج بنفسه. ولهذا تستخدم NVIDIA الأمر llama-server من llama.cpp مع الخيار --jinja، الذي يفعّل الدعم الأصلي لاستدعاء الأدوات (tool calling). وهو في جوهره سيناريو VLA مصغّر، لا تُستدعى فيه الرؤية إلا عند الحاجة الفعلية.
ما المطلوب للتشغيل
لا يبدو العرض سحرًا جاهزًا للاستخدام فور التشغيل، بل هو أقرب إلى دليل مُعدّ بعناية للهواة والمطورين الراغبين في إعادة بناء هذا المسار المحلي متعدد الوسائط بأنفسهم. وتصف NVIDIA المنظومة كاملة، لا مجرد تشغيل سكربت Python، بدءًا من حزم النظام وبناء llama.cpp وصولًا إلى إعداد الصوت والكاميرا وتنزيل vision projector الخاص بـ Gemma 4.
- Jetson Orin Nano Super بذاكرة 8 غيغابايت، وكاميرا ويب، وميكروفون USB أو كاميرا بميكروفون مدمج، ومكبرات صوت USB ولوحة مفاتيح
- بيئة Python تضم
opencv-python-headlessوonnx_asrوkokoro-onnxوsoundfileوhuggingface-hubوnumpy - نسخة
llama.cppمبنية محليًا مع CUDA، ونموذجgemma-4-E2B-itبصيغة GGUF، وملفmmprojمنفصل لا يستطيع Gemma 4 الرؤية بدونه - ضبط
MIC_DEVICEوSPK_DEVICEوWEBCAMوVOICE، ثم يُشغَّل العرض بأمر واحد هوpython3 Gemma4_vla.py - وضع نصي منفصل عبر Docker لمن يريد فحص جزء LLM بسرعة دون الإعداد البصري الكامل
ويحظى جانب الذاكرة بتركيز خاص. فاللوحة ذات 8 غيغابايت تكفي، لكن الكاتب ينصح صراحة بتحرير الذاكرة (RAM) وإيقاف العمليات غير الضرورية، بل وإضافة swap لتجنب خطأ OOM عند تحميل النموذج. ويُعدّ Q4_K_M المكمَّم الخيار الأساسي، وعند القيود الشديدة يمكن النزول إلى Q3. وهذه تفصيلة مهمة: فالحديث ليس عن منتج استهلاكي مصقول، بل عن وصفة عملية يؤثر فيها كل غيغابايت فعليًا في النتيجة.
لماذا يستحق الاهتمام
الخبر ليس في أن Gemma 4 يمكن تشغيله على Jetson، فهذا متوقع أصلًا مع الإصدارات الخفيفة. الأهم أن NVIDIA تقدم نموذجًا عمليًا لوكيل محلي متعدد الوسائط يجمع بين STT وLLM واستدعاء الأدوات والرؤية وTTS دون اللجوء الإلزامي إلى السحابة. وهذه إشارة قوية للأجهزة الطرفية. فقد ارتبطت سيناريوهات كهذه سابقًا إما بالخوادم، أو بعروض مبسطة إلى حد كبير يكتفي فيها النموذج بالرد على النصوص.
وفي الوقت نفسه، يعرض الدليل القيود بصدق. فالتشغيل الأول بطيء لأن النماذج تُحمَّل وتُولَّد الملفات الصوتية. ويتطلب وضع VLA الكامل بناءً أصليًا وvision projector، أما نسخة Docker فتصلح للنص فقط. وإذا لم تكفِ الذاكرة في الجهاز، يضطر المستخدم إلى تنظيف النظام يدويًا. كما لا تورد NVIDIA في المقال أي اختبارات أداء للسرعة، ولا تعرض فيديو يُظهر زمن الاستجابة الفعلي، لذا فالطريق ما زال طويلًا قبل أن يصبح هذا مساعدًا جاهزًا للجميع. لكنه، كعرض لاتجاه التطور، حالة قوية جدًا.
ماذا يعني ذلك
تقترب وكلاء الذكاء الاصطناعي المحلية من الاستخدام العملي على عتاد منخفض التكلفة. وهذا يعني للمطورين إمكانية بناء واجهات صوتية خاصة ونماذج أولية متعددة الوسائط دون الحاجة الإلزامية إلى بنية سحابية. أما بالنسبة لسوق edge AI، فهي خطوة أخرى من العروض التقديمية المبهرة نحو أنظمة يمكن تشغيلها فعليًا على المكتب واختبارها ودمجها في منتج.
- 2 نوفمبر 2026NVIDIA تطلق Nemotron 3.5 Bolt E4B بحجم 4 غيغابايت وسرعة 133 توكن في الثانية على RTX 5070
- 2 نوفمبر 2026Cosmos يولّد فيديو تدريبيًا للطائرات المسيّرة: ارتفاع mAP@50–95 لكاشف الأجسام بنسبة 10,3%
- 2 نوفمبر 2026على Anthropic أن تنمّي إيراداتها 32% سنويًا لتغطية عقود بقيمة $850 مليار
- 2 نوفمبر 2026TensorFold 1.2.0 يرفع إنتاجية Qwen3.8-27B على M3 Ultra بنسبة 44,2% عند 16 تدفقًا
أسئلة وأجوبة حول الخبر
ما أبرز التفاصيل حول كيف تعمل المنظومة؟
صُمّم السيناريو كوكيل صوتي بسيط يملك أداة بصرية واحدة. يضغط المستخدم على مفتاح المسافة ويطرح سؤاله بالصوت، ثم يحوّل Parakeet الكلام إلى نص محليًا. بعد ذلك يتلقى Gemma 4 الطلب ويقرر بنفسه ما إذا كان يحتاج إلى النظر عبر كاميرا الويب. إذا احتاج، يلتقط السكربت إطارًا ويمرره إلى النموذج، ثم يُنطق الرد عبر Kokoro TTS. ويؤكد المقال تحديدًا أن النموذج لا يصف الصورة بوجه عام، بل يستخدم ما رآه فقط للإجابة عن السؤال المطروح. «بصراحة، يكفي أن هذا يعمل على Jetson Orin Nano لكي يكون مثيرًا للإعجاب».
ما أبرز التفاصيل حول ما المطلوب للتشغيل؟
لا يبدو العرض سحرًا جاهزًا للاستخدام فور التشغيل، بل هو أقرب إلى دليل مُعدّ بعناية للهواة والمطورين الراغبين في إعادة بناء هذا المسار المحلي متعدد الوسائط بأنفسهم. وتصف NVIDIA المنظومة كاملة، لا مجرد تشغيل سكربت Python، بدءًا من حزم النظام وبناء llama.cpp وصولًا إلى إعداد الصوت والكاميرا وتنزيل vision projector الخاص بـ Gemma 4.
ما أبرز التفاصيل حول لماذا يستحق الاهتمام؟
الخبر ليس في أن Gemma 4 يمكن تشغيله على Jetson، فهذا متوقع أصلًا مع الإصدارات الخفيفة. الأهم أن NVIDIA تقدم نموذجًا عمليًا لوكيل محلي متعدد الوسائط يجمع بين STT وLLM واستدعاء الأدوات والرؤية وTTS دون اللجوء الإلزامي إلى السحابة. وهذه إشارة قوية للأجهزة الطرفية. فقد ارتبطت سيناريوهات كهذه سابقًا إما بالخوادم، أو بعروض مبسطة إلى حد كبير يكتفي فيها النموذج بالرد على النصوص. وفي الوقت نفسه، يعرض الدليل القيود بصدق. فالتشغيل الأول بطيء لأن النماذج تُحمَّل وتُولَّد الملفات الصوتية.
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
أهم ما في عالم الذكاء الاصطناعي — مرة كل أسبوع
سبع قصص مهمة فعلاً هذا الأسبوع، مختارة بعناية. بلا ضجيج ولا بيانات صحفية.
تم! تحقق من بريدك للتأكيد.