Hugging Face Blog
مصدر أخبار الذكاء الاصطناعي. تُختار المقالات وتُعدَّل من قِبَل تحرير Hamidun News.
أحدث المنشورات

Ai2 يكشف: قضاة الجدّة من نماذج LLM ينهارون بمجرد تغيير كلمات قليلة في الموجّه
اختبر Ai2 ستة قضاة LLM على 299 فكرة من مراجعات ICLR 2026: تغيير الصياغة خفّض دقة GPT-5.4 من 93,5% إلى 40,9%، وتفوّق موجّه رخيص على أنظمة باهظة.

Liquid AI تطلق LFM3: ست نماذج متعددة الوسائط بحجم 2B وسياق 256K
يتفوق LFM3-1.7B على LFM2.5-2.6B بعدد معاملات أقل بنسبة 35%، ويتسع في 1 غيغابايت بدقة 4 بتات. نماذج النص والرؤية والصوت وomni والمعايرة مبنية على قاعدة واحدة.

Black Forest Labs تطلق FLUX.3 Klein: صورة 1024×1024 في 2 ثانية على H100
FLUX.3 Image Klein من Black Forest Labs متاحة في Diffusers منذ اليوم الأول: نص إلى صورة، وتحرير بالصور المرجعية، وتحكم بالتخطيط عبر bounding box. الإطار في 1,93 ثانية.

Liquid AI تطلق LFM2.5-24B-A2B: وكيل ذكي بمعاملات نشطة لا تتجاوز 2B
فتحت Liquid AI أوزان نموذج MoE بحجم 24B معامل، يُفعَّل منها 2B فقط. يولّد 184 توكن/ثانية على حاسوب محمول بمعالج M5 Max، وأكثر من 21 ألف توكن/ثانية على وحدة B300 واحدة.

PyTorch 2.15 يسرّع نماذج MoE على Mac بمعدل 5–6.5 أضعاف ويضيف دعم FP8
أعادت فرق Hugging Face كتابة عمليات MPS الحرجة على Metal: ارتفع أداء Qwen3.6-35B-A3B على M3 Ultra من 9.4 إلى 61.3 رمزًا/ثانية، وانخفضت ذروة ذاكرة Wan2.2 من 270 إلى 8 GiB.

NVIDIA Kumo Relational يتفوق على نماذج التعلم الخاضع للإشراف في 41 مهمة دون تدريب
أطلقت NVIDIA نموذج Kumo Relational المدرَّب مسبقًا، وهو يتنبأ بانسحاب العملاء والطلب مباشرة من قاعدة بيانات علائقية في تمريرة واحدة، ويتفوق على AutoGluon بنسبة 8% في MRR على SAP SALT.

Apertus 1.5 السويسري يكتسب الرؤية والسمع وسياقًا بطول 262 ألف رمز
أصدر مشروع Swiss AI نموذجَي Apertus 1.5 بحجم 8B و70B بترخيص Apache 2.0: تعدد وسائط عبر المُجزّئ، ووضع تفكير، وسياق أطول 4 مرات، وبيانات مفتوحة بالكامل.

Microsoft وHugging Face تدرّبان Qwen3.8-27B على تقييمات قاعدة البيانات: من 38 إلى 107 مهام
تحوّلت فحوص الحالة النهائية لقاعدة البيانات إلى مكافأة لـ GRPO: خلال 50 خطوة رفع Qwen3.8-27B نتيجة pass@1 من 51,70% إلى 60,78% وضاعف مهام 20/20 قرابة ثلاثة أضعاف.

Dharma-AI تقلّص مفردات Qwen3-4B وتخفض تكلفة الاستدلال بنسبة 77%
أعاد فريق Dharma-AI البرازيلي بناء مُجزِّئ Qwen3-4B (tokenizer) لمهمة واحدة. تقلّص رد النموذج من 350 إلى 101 توكن، وارتفعت الجودة من 0.703 إلى 0.810.

Reflection تطلق Beam: نموذج MoE مفتوح بـ 501B معامل بترخيص Apache 2.0
أتاحت مختبر Reflection الأمريكي الجديد نموذج Beam مفتوحًا: 501B معامل، و23B نشطة لكل رمز، وسياق 1M، وترخيص Apache 2.0. النموذج مخصص للبرمجة والوكلاء.

Meta تفتح Muse Spark Open: نموذج MoE بـ816 مليار معامل ونافذة سياق بمليون رمز
أطلقت Meta نموذج Muse Spark Open مفتوح الأوزان: 816 مليار معامل، 42 مليارًا منها نشطة لكل رمز، ويستقبل النص والصور والصوت والفيديو، ومُهيّأ للبرمجة الوكيلية.

وحدات GPU متوقفة كالطائرات على الأرض: Hugging Face تشرح الخسائر الخفية لفرق الذكاء الاصطناعي
تقارن Hugging Face وحدات GPU غير المستغلة بالطائرات الرابضة على الأرض، وتبيّن كيف تكلّف إدارة GPU السيئة فرق الذكاء الاصطناعي مئات الآلاف من الدولارات سنويًا.

Nunchaku Lite: توليد الصور بدقة 4 بت في Diffusers — ذاكرة VRAM أقل بنسبة تصل إلى 50%
دمجت Hugging Face استدلال Nunchaku Lite بدقة 4 بت مباشرة في Diffusers: ذاكرة فيديو أقل بنسبة تصل إلى 50% وتوليد أسرع بنسبة 30% بسطر برمجي واحد.

NVIDIA تتيح مجموعات بيانات Nemotron: 10 تريليونات رمز لتدريب وكلاء الذكاء الاصطناعي
أصدرت NVIDIA مجموعات بيانات Nemotron التي تضم أكثر من 10 تريليونات رمز و2.4 مليار شخصية اصطناعية لتدريب وكلاء الذكاء الاصطناعي على سيناريوهات واقعية وأعطال الأدوات.

Hugging Face: واجهة transformers الخلفية في vLLM تعمل الآن بالسرعة الأصلية
أعلنت Hugging Face تحقيق تكافؤ في الأداء: الخيار --model-impl transformers يمنح سرعة vLLM الأصلية على أكثر من 450 معمارية دون إعادة كتابة الكود.
Hugging Face تطلق خدمة تخزين سحابية دون رسوم على حركة البيانات الصادرة
يتيح التكامل بين SkyPilot وHugging Face Storage تدريب النماذج على أي سحابة، مع تخزين الأوزان ومجموعات البيانات بسعر 12-18 دولارًا للتيرابايت شهريًا ودون رسوم على حركة البيانات الصادرة.
مايكروسوفت تطلق Foundry Managed Compute: آلاف نماذج Hugging Face بنقرة واحدة
دمجت مايكروسوفت Azure Foundry مع كتالوج Hugging Face: آلاف النماذج المفتوحة يمكن نشرها الآن في السحابة بنقرة واحدة، مع أمان على مستوى المؤسسات وفوترة موحّدة.
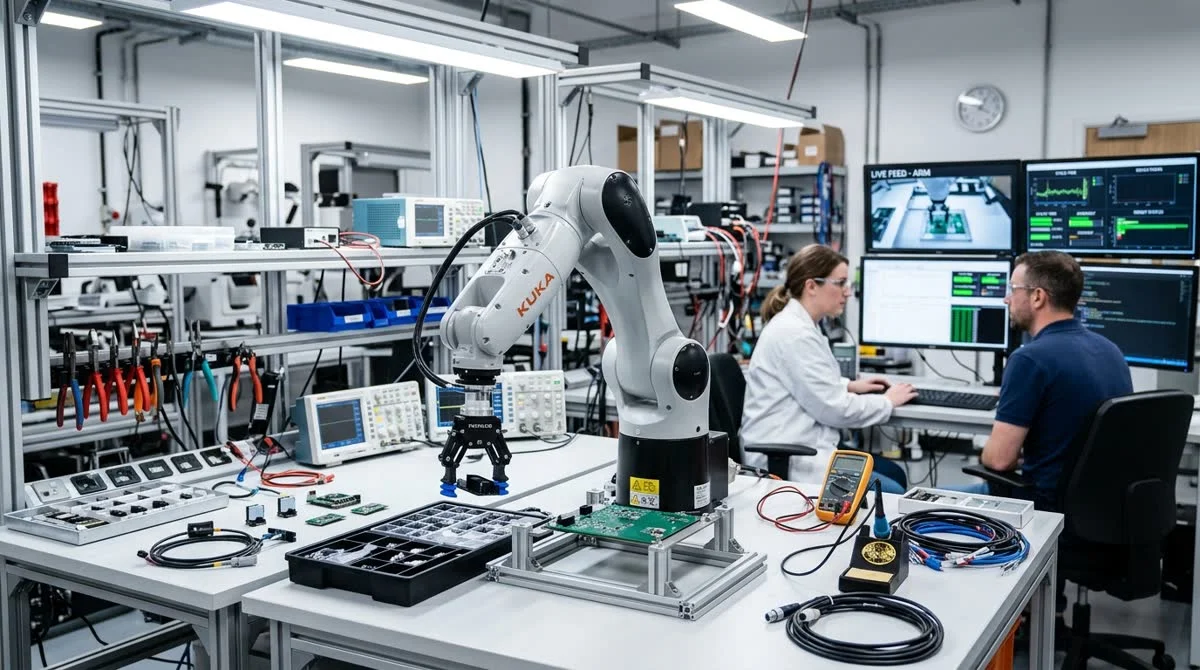
LeRobot v0.6.0 من Hugging Face: الروبوتات تتعلم التنبؤ بالمستقبل وتقييم نفسها
أطلقت Hugging Face الإصدار LeRobot v0.6.0 بسياسات world-model ونماذج reward للتقييم الآلي للمهام وستة معايير اختبار جديدة، لتُغلق حلقة تدريب الروبوتات بالكامل.
Hugging Face تحدّث Kernels: ناشرون موثوقون وتوقيع الشيفرة وتطوير قائم على الوكلاء
أطلقت Hugging Face في 6 يوليو 2026 تحديثًا كبيرًا لـ Kernels: أصبحت النواة نوعًا مستقلًا من المستودعات على Hub، مع إضافة ناشرين موثوقين وتوقيع الشيفرة عبر Sigstore.
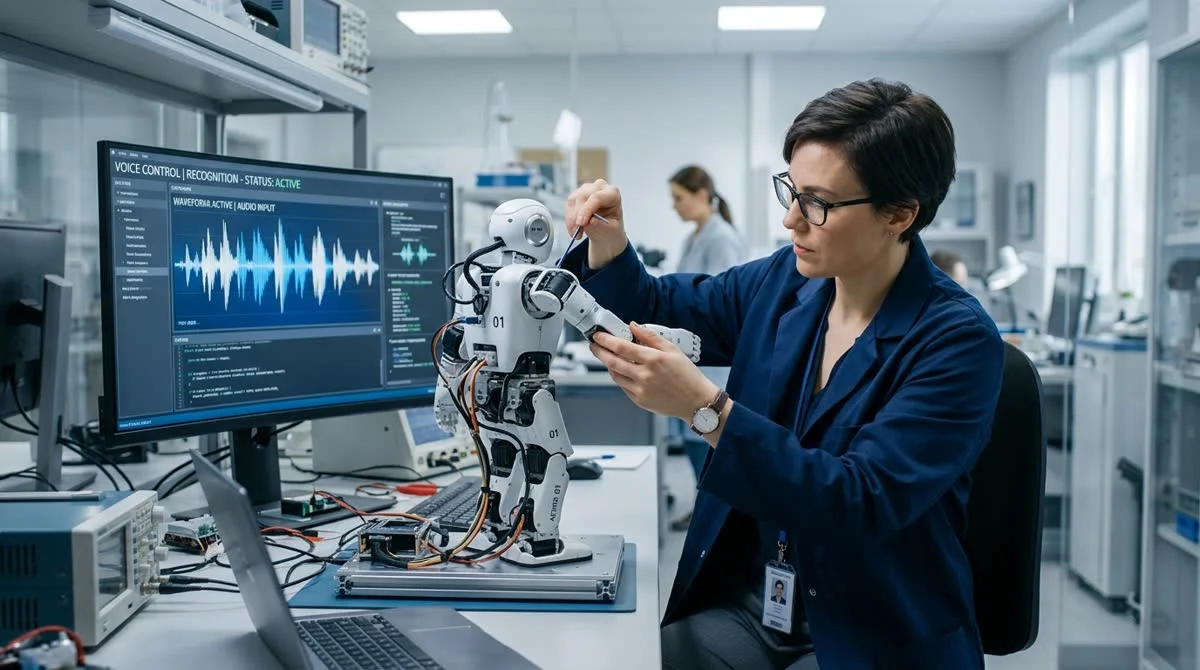
Hugging Face تطلق نظام الذكاء الاصطناعي الصوتي Gemma 4 في الوقت الفعلي
قدّمت Hugging Face وCerebras منظومة مفتوحة المصدر لتحويل الكلام إلى كلام تعتمد على Gemma 4 مع زمن استجابة يمكن التنبؤ به، وتعمل حاليًا في أكثر من 9000 روبوت Reachy Mini.
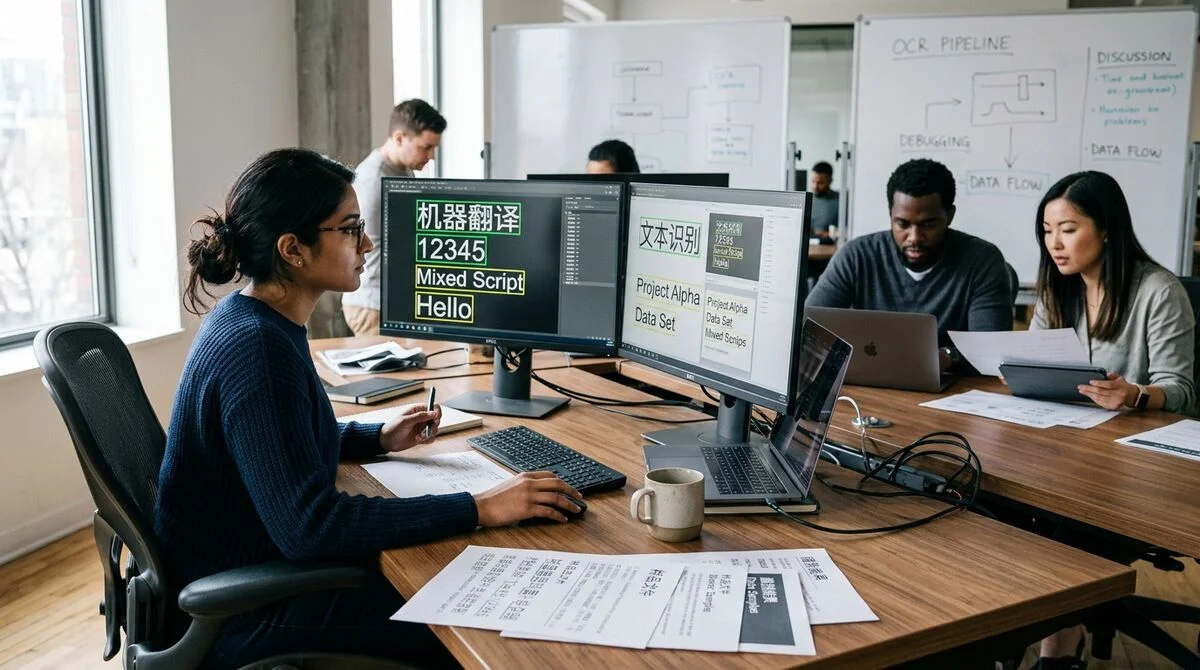
PaddleOCR تطلق PP-OCRv6: التعرّف على النصوص بـ 50 لغة بنماذج من 1.5 إلى 34.5 مليون معامل
PP-OCRv6 من Baidu PaddlePaddle: نظام OCR شامل يدعم 50 لغة في ثلاثة إعدادات من 1.5 إلى 34.5 مليون معامل، بتحسّن في الدقة يتراوح بين +4.6 و+5.1 نقطة مئوية عن الإصدار الخادمي السابق.
ServiceNow: وكيل ذكاء اصطناعي يسرّب أسرار الشركات عبر سلسلة من استعلامات البحث
أظهر باحثو ServiceNow أن وكيل البحث العميق (deep-research) يكشف أسرار الشركات دون قصد: كل استعلام بريء، لكن السلسلة بأكملها تتجمع كفسيفساء.
Hugging Face تقارن بين جميع بدائل LoRA: من يتفوق في الضبط الدقيق لنماذج LLM
اختبر فريق Hugging Face خمس طرق PEFT لضبط نماذج LLM، من DoRA إلى GaLore، وحدّد متى يمكن تجاوز LoRA وبأي ثمن.
النماذج الهجينة تتفوق على المحوّلات في التنبؤ بالكلمات ذات المعنى — دراسة من Allen AI
قارنت Allen AI بين معماريتي OLMo 3 وOLMo Hybrid: النماذج الهجينة أدق في التنبؤ بالأسماء والأفعال والصفات، لكنها تتأخر عن المحوّلات في المقاطع النصية المتكررة.
نشر النماذج اللغوية دون الحاجة إلى DevOps: تكامل Hugging Face مع vLLM
أضافت Hugging Face دعم vLLM إلى منصة HF Jobs: يمكن الآن نشر خادم استدلال جاهز للإنتاج لأي نموذج من Hub بأمر واحد في CLI.
الذكاء الاصطناعي لتقييم النماذج: AllenAI تطلق olmo-eval
أصدرت AllenAI أداة olmo-eval مفتوحة المصدر لتقييم النماذج اللغوية بشكل مستمر خلال دورة التدريب، نقطة حفظ تلو الأخرى.
North Mini Code: نموذج ذكاء اصطناعي لكتابة الشيفرة البرمجية من Cohere
أطلقت Cohere نموذج North Mini Code بحجم 30 مليار معامل، وقد دُرّب خصيصًا على البرمجة والعمل مع وكلاء الذكاء الاصطناعي. النموذج مجاني ومتاح للجميع.
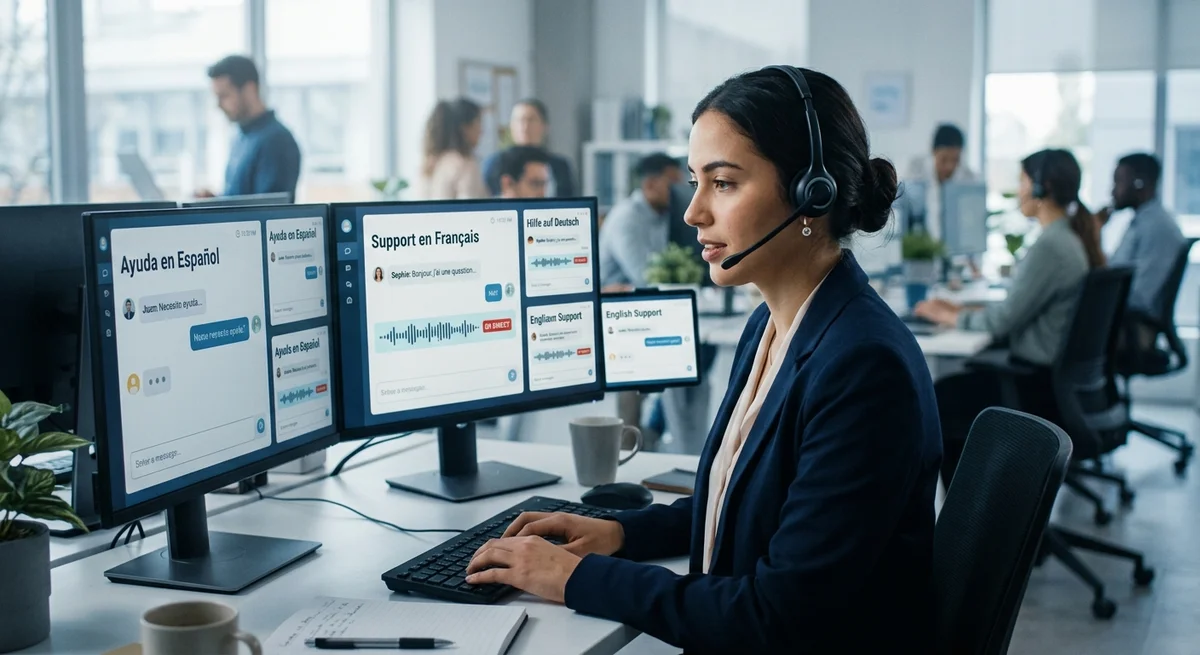
وكلاء الذكاء الاصطناعي الصوتيون يتعثرون أمام الثنائية اللغوية: دراسة
أظهرت دراسة أجرتها ServiceNow-AI أن معظم الأنظمة الصوتية ليست جاهزة بعد لخدمة العملاء ثنائيي اللغة، مع أن ElevenLabs وAssemblyAI تحققان أفضل النتائج.
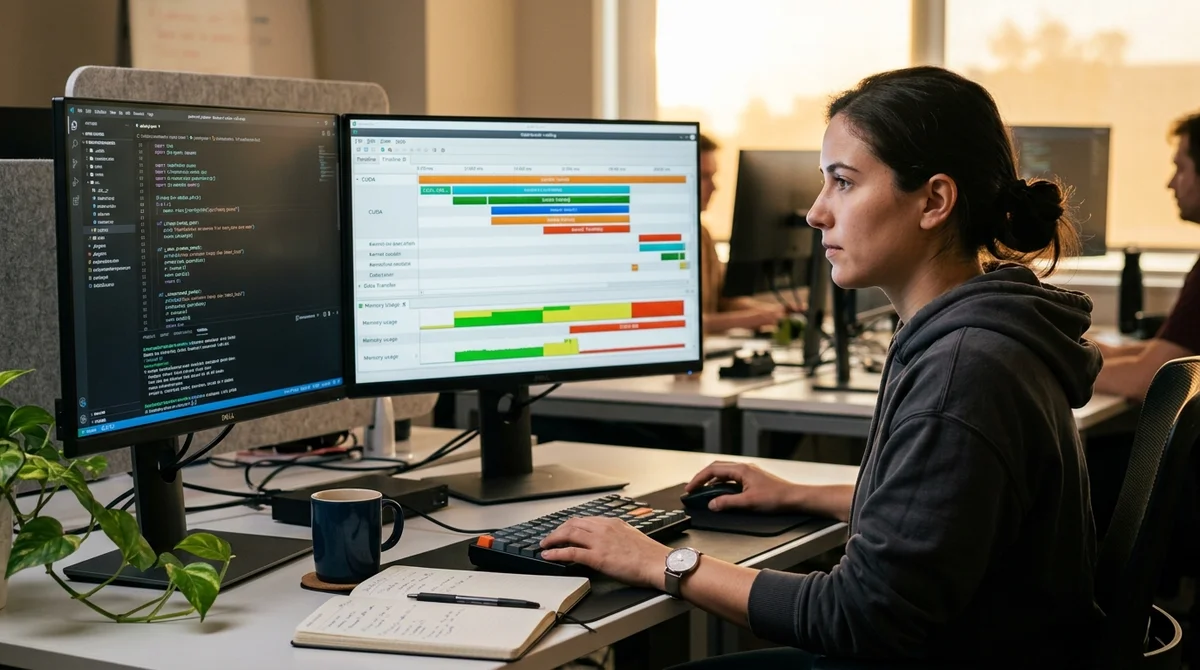
كيف تُسرّع نماذج PyTorch: دليل عملي لأداة torch.profiler
تناولت Hugging Face أداة torch.profiler المدمجة في PyTorch لتحليل الأداء، وهي تساعد على رصد اختناقات الأداء في تدريب النماذج والاستدلال.
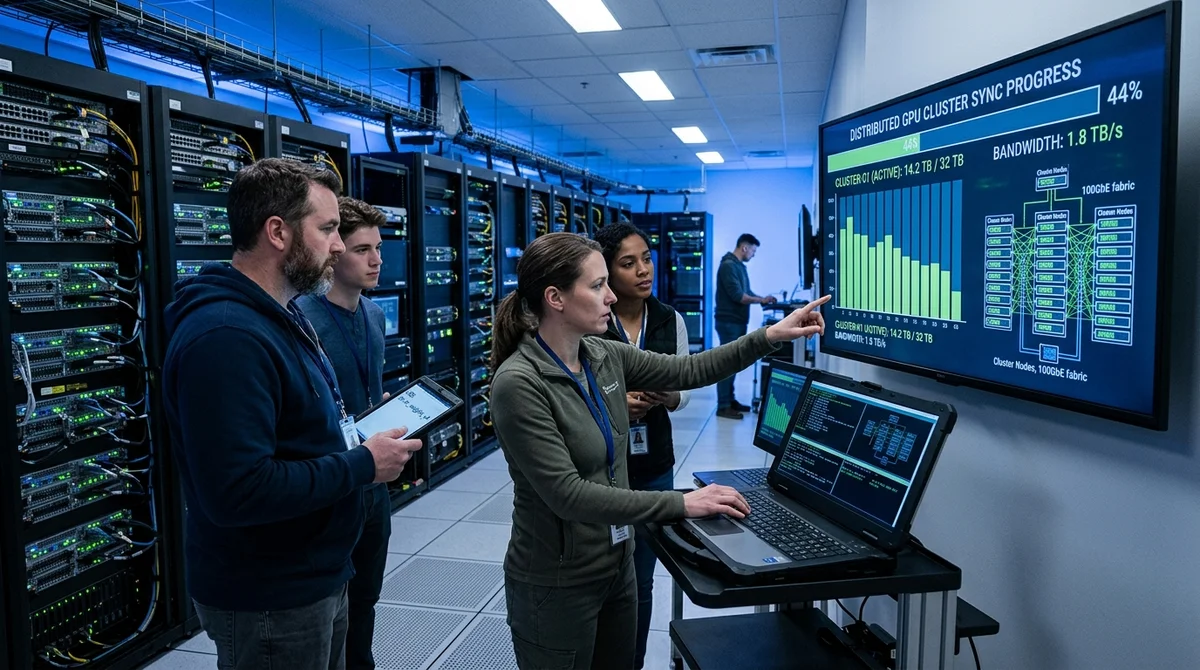
Hugging Face تُمكّن TRL من نقل تريليون معامل عبر أوزان الدلتا
أضافت Hugging Face أداة Delta Weight Sync إلى TRL، وهي تقنية ترسل التغييرات في الأوزان فقط بدل الملفات الكاملة، ما يخفّض حجم البيانات بمئات المرات عند تدريب النماذج العملاقة.