Hugging Face تُمكّن TRL من نقل تريليون معامل عبر أوزان الدلتا
قدّمت Hugging Face أداة Delta Weight Sync لمكتبة TRL، وهي تنقل تريليون معامل عبر Hub بإرسال دلتا الأوزان فقط. تخفّض هذه الطريقة حجم البيانات المنقولة بمئات المرات، وتسرّع المزامنة بين العقد أثناء التدريب الموزّع.
معالج بواسطة الذكاء الاصطناعي من Hugging Face Blog؛ بتحرير Hamidun News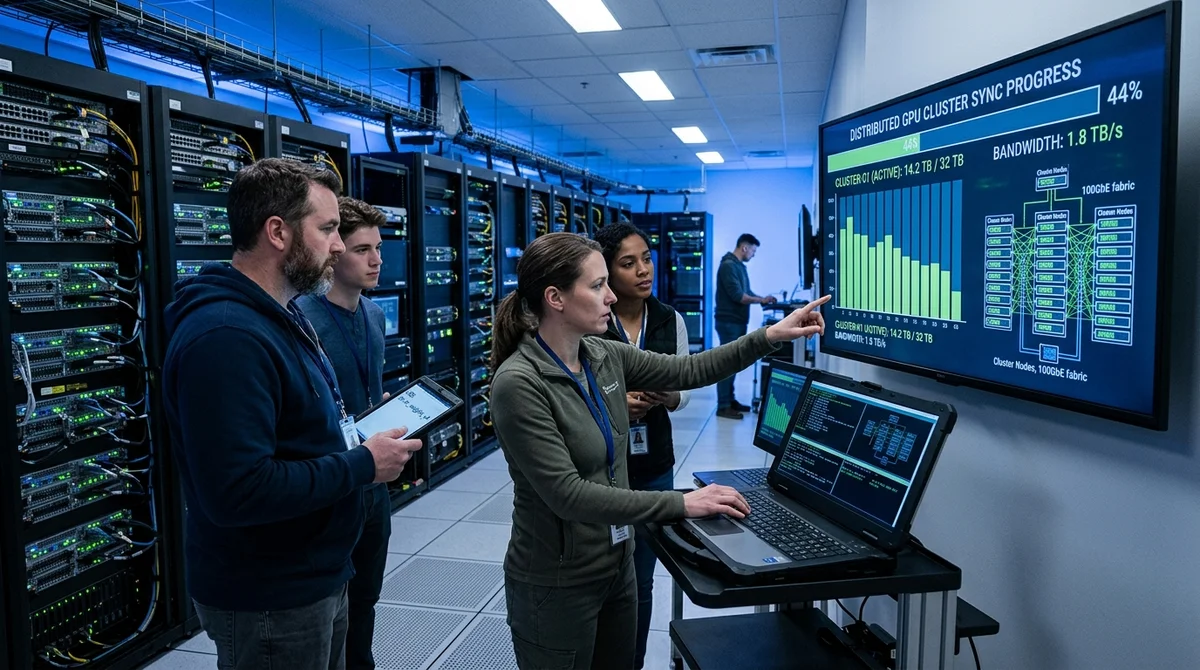
أضافت Hugging Face إلى مكتبة TRL (Transformers Reinforcement Learning) أداة Delta Weight Sync، وهي طريقة لنقل النماذج العملاقة التي تضم تريليون معامل ومزامنتها بكفاءة عبر حاوية Hub عادية (bucket).
لماذا يصعب نقل تريليون معامل؟
عند تدريب النماذج اللغوية الكبيرة في بيئة موزّعة، مثل الضبط الدقيق عبر التعلم المعزز (reinforcement learning) أو الضبط الدقيق (fine-tuning) على بيانات متخصصة، يجب مزامنة أوزان النموذج بين عقد العنقود. وإذا بلغ حجم النموذج مئات الغيغابايت أو حتى تيرابايتات، فإن إرسال الملفات الكاملة يعني استهلاك كمية هائلة من حركة الشبكة.
يقوم النهج التقليدي على تنزيل نقطة الحفظ (checkpoint) الكاملة، وقد يصل حجمها إلى 2-4 تيرابايت، ثم تطبيق التغييرات الناتجة عن خطوة تدريب واحدة، ثم رفعها مجددًا إلى Hub. وهذا يستهلك مساحة على خادم Hub (الحصص)، ويعني ساعات من الانتظار على مستوى الشبكة.
كيف تعمل Delta Weight Sync
لا ترسل Delta Weight Sync الملف كاملًا، بل الفرق (الدلتا) بين النسخة القديمة من الأوزان والنسخة الجديدة. وهذا يشبه git diff، لكن لأوزان الشبكات العصبية.
- يُحسب الفرق بين نقطة الحفظ A ونقطة الحفظ B
- تُضغط الدلتا (يصل الضغط إلى 10-50x في التحديثات التدريجية)
- تُرسل الدلتا إلى Hub في ملف منفصل
- على العقدة الأخرى: تُنزَّل الدلتا وتُطبَّق على النسخة المحلية من الأوزان
- النتيجة: مزامنة بحجم بيانات أقل بمئات المرات
يعتمد الأثر على مقدار التغيّر في الأوزان. ففي الضبط الدقيق التدريجي يتغيّر غالبًا 2-5% من الأوزان، ويبقى الباقي مطابقًا للأصل. وتستفيد Delta Weight Sync من هذه الخاصية بشكل مكثّف.
وفورات على نطاق واسع
قد تبلغ نقطة الحفظ الكاملة لنموذج بتريليون معامل 2-4 تيرابايت. وإرسال هذا الحجم عبر الشبكة يستغرق ساعات، حتى على القنوات المخصصة. أما دلتا بحجم 100-500 غيغابايت فتُرسل خلال 15-60 دقيقة. وبالنسبة إلى الأنظمة التي تزامن الأوزان عشرات المرات يوميًا (وهو أمر معتاد في RLHF حيث تتغيّر أوزان النموذج في كل تكرار)، يوفّر ذلك أيامًا من وقت التدريب.
«مع
Delta Weight Sync يمكن الاحتفاظ بالنماذج العملاقة في Hub دون عقوبة على حركة الشبكة» — هذه هي الفكرة التي تقوم عليها الأداة.
من يستخدمها؟
تفيد Delta Weight Sync بصفة خاصة في:
- RLHF الموزّع، أي عند الضبط الدقيق للنموذج بالاعتماد على ملاحظات البشر أو نماذج أخرى
- العناقيد متعددة العقد، حيث تضبط كل عقدة نسخة من النموذج بالتوازي
- تجارب المعاملات الفائقة (hyperparameters)، إذ يمكن تغيير الإعدادات بسرعة ومزامنة الدلتا فقط
- الفرق ذات الشبكات المحدودة، مثل الحوسبة السحابية دون نطاق ترددي غير محدود والمختبرات المحلية
ماذا يعني ذلك؟
Delta Weight Sync ليست ثورة على المستوى النظري، بل خطوة هندسية نحو الجدوى العملية. لم يعد تريليون معامل كابوسًا من حيث التخزين والمزامنة، بل أصبح معيارًا عاديًا. وبالنسبة إلى الشركات الناشئة والفرق البحثية، يعني ذلك إمكانية العمل مع نماذج ضخمة على عتاد متواضع وشبكات أضعف، شرط تنظيم ضغط الدلتا بالشكل الصحيح.
Executive AI Consulting, Custom Agents & Team Workshops
Work directly with Zhemal Khamidun at hamidun.com — enterprise AI architecture, production RAG & multi-agent systems, and executive training.
أهم ما في عالم الذكاء الاصطناعي — مرة كل أسبوع
سبع قصص مهمة فعلاً هذا الأسبوع، مختارة بعناية. بلا ضجيج ولا بيانات صحفية.
تم! تحقق من بريدك للتأكيد.