كيف تُسرّع نماذج PyTorch: دليل عملي لأداة torch.profiler
نشرت Hugging Face الجزء الأول من دليل حول torch.profiler، وهي أداة مدمجة في PyTorch لتحليل الأداء. تتتبع الأداة كل عملية تُنفَّذ على GPU وCPU، وتكشف اختناقات الأداء في الحسابات، وتساعد على تقليص زمن تدريب النماذج. يفيد الدليل مهندسي ML والباحثين الذين يريدون معرفة أين تذهب القدرة الحاسوبية، وتسريع مشاريعهم.
معالج بواسطة الذكاء الاصطناعي من Hugging Face Blog؛ بتحرير Hamidun News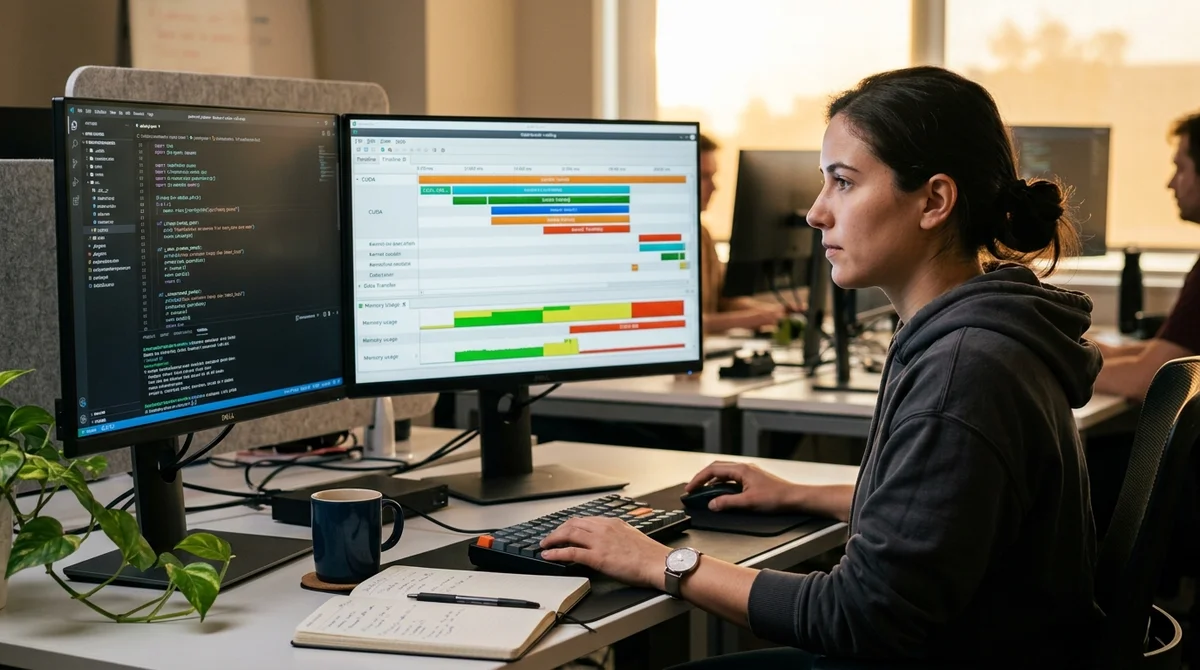
تتضمن PyTorch أداة مدمجة هي torch.profiler لتحليل أداء النماذج. تتتبع الأداة كل عملية على GPU وCPU، ما يساعد على رصد اختناقات الأداء في الحسابات وتحسين زمن التدريب.
لماذا نُجري تحليل الأداء للنماذج
من دون تحليل الأداء، لا يرى المطوّر سوى رقم نهائي واحد: «استغرق تدريب الحقبة ساعتين». لكن لماذا ساعتان؟ وفيمَ ذهب الوقت؟ ربما يكون dataloader بطيئًا؟ أو أن إحدى العمليات على GPU غير فعّالة؟ أو أن GPU يظل خاملًا في انتظار البيانات من CPU؟
محاولة التحسين بشكل أعمى مجرد تخمين. تغيّرون حجم الدفعة (batch size) وسرعة التحميل ودقة الحسابات، لكن النتيجة لا تتحسن، لأنكم تحسّنون اختناقًا ليس هو المشكلة الحقيقية. تُجنّبكم torch.profiler هذا الهدر في الوقت، إذ تعرض التوزيع الدقيق للوقت والذاكرة على العمليات.
كيف تعمل torch.profiler
تتتبع الأداة تنفيذ الشيفرة على مستوى نوى CUDA وخيوط CPU. وتسجّل لكل عملية — مثل ضرب المصفوفات في طبقة Linear أو الالتفاف في Conv2d — وقت البدء والانتهاء والذاكرة المستخدمة. يمكن تصدير النتائج بصيغة متوافقة مع Chrome DevTools وعرضها بصريًا على شكل خط زمني (timeline).
أهم مقاييس المحلِّل:
- Exclusive time — الوقت الذي استغرقته العملية نفسها (من دون العمليات المتداخلة)
- Inclusive time — وقت العملية مع جميع الاستدعاءات المتداخلة
- Memory — الحد الأقصى لاستخدام ذاكرة GPU أثناء العملية
- Sync time — الوقت المهدور في المزامنة بين CPU وGPU (وهو الاختناق الأول)
متى تكشف torch.profiler المشكلات
سيناريو شائع: يتدرب النموذج ببطء، وتظنون أنكم تحتاجون إلى GPU أسرع، لكن المحلِّل يُظهر أن 60% من وقت الحقبة يذهب في انتظار البيانات من dataloader. المشكلة ليست في GPU بل في تحميل البيانات. الحل: زيادة num_workers في DataLoader أو استخدام الذاكرة المثبّتة (pinned memory).
مثال آخر: يتدرب النموذج على نظام موزّع (عدة وحدات GPU)، ويُظهر المحلِّل أن وقتًا كبيرًا يضيع في مزامنة التدرجات (gradients) بين الأجهزة. هذه إشارة إلى ضرورة تحسين مخطط الاتصال أو إعادة النظر في استراتيجية التوازي.
تنبيه مهم: التحليل نفسه يضيف overhead. فإذا شغّلتم المحلِّل على كامل حلقة التدريب، فقد يُبطئ الحسابات بنسبة 10–30%. وللحصول على قياسات دقيقة، من الأفضل تحليل الجزء المعني من الشيفرة فقط (مثلًا مرورًا واحدًا للأمام والخلف forward-backward).
ماذا يعني ذلك
تُعدّ torch.profiler الخطوة الأولى قبل أي تحسين. لا تخمّنوا موضع الاختناق: حلّلوا الأداء، وراجعوا النتائج، وحسّنوا ما يُبطئ العمل فعلًا. سيوفّر ذلك أسابيع من التجارب ويوجّه الجهود إلى حيث تُثمر فعلًا.
بالنسبة إلى مهندسي ML الذين يريدون تسريع تدريب النماذج، هذه أداة أساسية.
- 28 أكتوبر 2026Anthropic تودع وثيقة S-1: إيرادات ربع سنوية بقيمة $11,6 مليار والتزامات بقيمة $780 مليار
- 28 أكتوبر 2026DeepSeek تفتح مصدر DeepInfer: 155 تريليون توكن يوميًا وهامش ربح 80%
- 28 أكتوبر 2026Cline تحصد 11 840 توكن/ث من محطة NVIDIA DGX Station واحدة
- 28 أكتوبر 2026T-Bank يستبدل سرب نماذج LLM بنموذج واحد من فئة 32B ويخفض تكلفة الطلبات بمقدار 2,8–3,9 مرة
أسئلة وأجوبة حول الخبر
ما أبرز التفاصيل حول لماذا نُجري تحليل الأداء للنماذج؟
من دون تحليل الأداء، لا يرى المطوّر سوى رقم نهائي واحد: «استغرق تدريب الحقبة ساعتين». لكن لماذا ساعتان؟ وفيمَ ذهب الوقت؟ ربما يكون dataloader بطيئًا؟ أو أن إحدى العمليات على GPU غير فعّالة؟ أو أن GPU يظل خاملًا في انتظار البيانات من CPU؟ محاولة التحسين بشكل أعمى مجرد تخمين. تغيّرون حجم الدفعة (batch size) وسرعة التحميل ودقة الحسابات، لكن النتيجة لا تتحسن، لأنكم تحسّنون اختناقًا ليس هو المشكلة الحقيقية. تُجنّبكم torch.profiler هذا الهدر في الوقت، إذ تعرض التوزيع الدقيق للوقت والذاكرة على العمليات.
ما أبرز التفاصيل حول كيف تعمل torch.profiler؟
تتتبع الأداة تنفيذ الشيفرة على مستوى نوى CUDA وخيوط CPU. وتسجّل لكل عملية — مثل ضرب المصفوفات في طبقة Linear أو الالتفاف في Conv2d — وقت البدء والانتهاء والذاكرة المستخدمة. يمكن تصدير النتائج بصيغة متوافقة مع Chrome DevTools وعرضها بصريًا على شكل خط زمني (timeline). أهم مقاييس المحلِّل: Exclusive time — الوقت الذي استغرقته العملية نفسها (من دون العمليات المتداخلة) Inclusive time — وقت العملية مع جميع الاستدعاءات المتداخلة Memory — الحد الأقصى لاستخدام ذاكرة GPU أثناء العملية Sync time — الوقت المهدور في المزامنة بين CPU وGPU (وهو الاختناق الأول)
ما أبرز التفاصيل حول متى تكشف torch.profiler المشكلات؟
سيناريو شائع: يتدرب النموذج ببطء، وتظنون أنكم تحتاجون إلى GPU أسرع، لكن المحلِّل يُظهر أن 60% من وقت الحقبة يذهب في انتظار البيانات من dataloader. المشكلة ليست في GPU بل في تحميل البيانات. الحل: زيادة num_workers في DataLoader أو استخدام الذاكرة المثبّتة (pinned memory). مثال آخر: يتدرب النموذج على نظام موزّع (عدة وحدات GPU)، ويُظهر المحلِّل أن وقتًا كبيرًا يضيع في مزامنة التدرجات (gradients) بين الأجهزة. هذه إشارة إلى ضرورة تحسين مخطط الاتصال أو إعادة النظر في استراتيجية التوازي. تنبيه مهم: التحليل نفسه يضيف overhead. فإذا شغّلتم المحلِّل على كامل حلقة التدريب، فقد يُبطئ ا
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
أهم ما في عالم الذكاء الاصطناعي — مرة كل أسبوع
سبع قصص مهمة فعلاً هذا الأسبوع، مختارة بعناية. بلا ضجيج ولا بيانات صحفية.
تم! تحقق من بريدك للتأكيد.