Google تكشف عن TurboQuant: ذاكرة KV-cache بدقة 3 بتات لنماذج LLM، لكن سوق الذاكرة ذُعر مبكرًا
عرضت Google تقنية TurboQuant، وهي طريقة تضغط KV-cache في نماذج LLM إلى 3 بتات وتخفّض استهلاك VRAM بشكل حاد في السياقات الطويلة. تراجع سوق الذاكرة على هذا الخبر، لكن الاستنتاجات جاءت متسرعة: لا توجد شيفرة رسمية حتى الآن، ولم تُدمج الطريقة في أي منظومة إنتاجية، كما أن مؤلفي خوارزمية RaBitQ الأسبق يعترضون فعليًا على جزء من ادعاءات Google. للتقنية إمكانات كبيرة، لكن الطريق ما زال طويلًا قبل أن يظهر تأثيرها الفعلي في الصناعة.
معالج بواسطة الذكاء الاصطناعي من Habr AI؛ بتحرير Hamidun News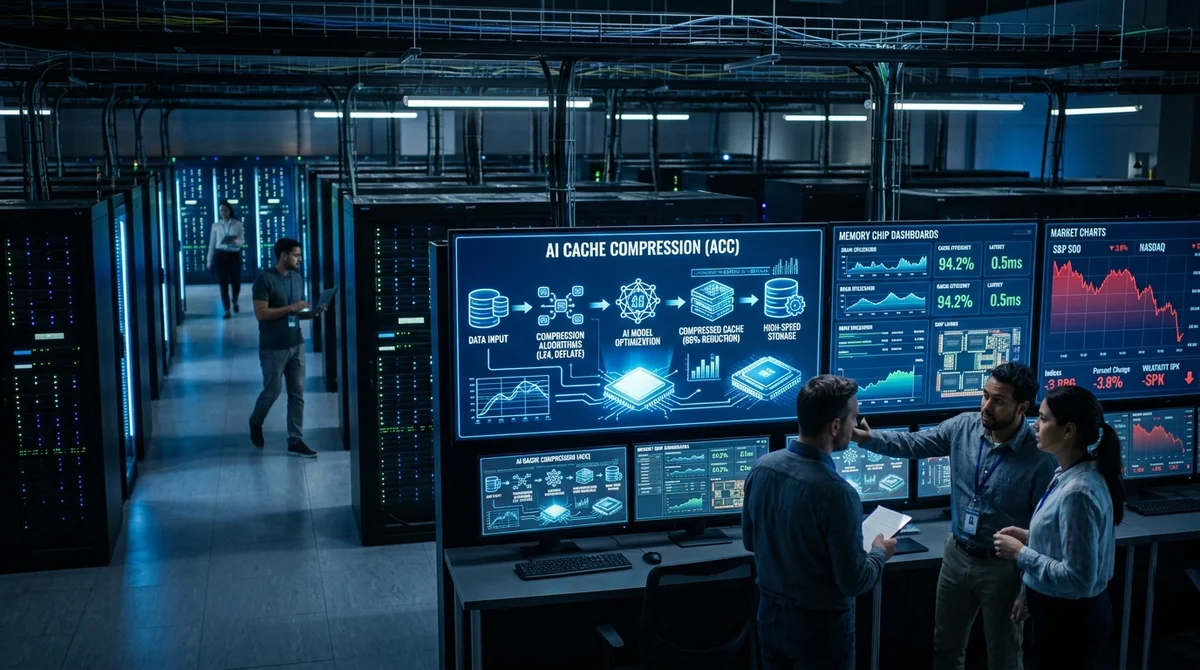
قدّمت Google Research خوارزمية TurboQuant التي تَعِد بضغط KV-cache في نماذج اللغة إلى 3 بتات دون إعادة تدريب وبفقدان شبه معدوم في الجودة. وعلى خلفية هذه الادعاءات، سارع سوق الذاكرة إلى الذعر، مع أن الثورة الحقيقية في مراكز البيانات لا تزال بعيدة.
لماذا اهتز السوق
في 24 مارس 2026 نشرت Google Research مادة عن TurboQuant، وبعد يومين فقط بدأ المستثمرون ببيع أسهم الشركات المرتبطة بالذاكرة. خسرت SK Hynix نسبة 6,23%، وSamsung نسبة 4,8%، فيما تراجعت أسهم Micron وSanDisk في الولايات المتحدة بنحو 5% و8% على التوالي.
بدا منطق السوق مباشرًا: إذا استطاعت النماذج الكبيرة الاكتفاء بحجم ذاكرة أقل بعدة مرات أثناء الاستدلال (inference)، فينبغي أن ينخفض الطلب على HBM وDRAM في مراكز البيانات. لكن هذا التفسير جاء فجًّا أكثر من اللازم، ولم يأخذ في الحسبان الموضع الذي يحقق فيه TurboQuant المكسب فعلًا.
المشكلة التي تستهدفها الخوارزمية لا تتعلق بذاكرة النموذج كلها، بل بـ KV-cache وحده. وهذه تمثيلات مساعدة للرموز (tokens) يخزّنها المحوّل (transformer) أثناء توليد النص كي لا يعيد حسابها في كل خطوة. في السياق القصير لا يشكّل KV-cache عبئًا يُذكر، أما في السياق الطويل فيصبح المستهلك الرئيسي للذاكرة. وبالنسبة للنماذج الكبيرة ذات نوافذ السياق التي تمتد إلى عشرات ومئات الآلاف من الرموز، قد يشغل هذا الكاش عشرات الغيغابايتات ويتحول إلى عنق زجاجة عند الاستدلال على نطاق واسع.
ماذا تفعل TurboQuant
تعلّمت الصناعة منذ زمن طويل تكميم أوزان النماذج، وتتوافر لذلك GPTQ وAWQ ومقاربات أخرى. أما مع KV-cache فالوضع أعقد، لأنه يتشكّل في الزمن الفعلي ويكون فريدًا لكل طلب. لا يمكن إعداد البيانات مرة واحدة ومعايرة المخطط ثم تطبيقه ببساطة في كل مكان. المطلوب طريقة قادرة على ضغط أي متجه جديد بسرعة وبشكل فوري، دون أن تنهار جودة الإجابة في السياقات الطويلة. وهذه هي المهمة التي تحاول TurboQuant حلّها.
يقوم مخطط Google على مرحلتين. في البداية تدير مرحلة PolarQuant المتجه بمصفوفة متعامدة عشوائية، لتصبح توزيعات القيم أكثر انتظامًا وقابلية للتنبؤ. بعد ذلك يمكن تطبيق مكمِّم أمثل محسوب مسبقًا دون الحاجة إلى بيانات معايرة. ثم تأتي مرحلة QJL التي تُرمّز إشارة الخطأ المتبقي ببت واحد، فتقلّل الانحياز المنهجي في الجداءات القياسية. وبهذا لا يتراكم الخطأ بشكل ملحوظ على امتداد التسلسل الطويل من الرموز، ويحافظ النموذج على جودة إجاباته بصورة أفضل.
- تمثيل KV-cache بدقة 3 بتات دون إعادة تدريب النموذج
- حتى 8 أضعاف أسرع في حساب لوغيتات الانتباه على H100 بحسب بيانات المؤلفين
- ما لا يقل عن 6 أضعاف أقل في VRAM المخصصة لـ KV-cache نفسه
- لا تتطلب معايرة إلزامية دون اتصال مخصصة لنموذج بعينه
أين حدود الطريقة
أهم ما يجب الانتباه إليه أن التقنية لا تبدو بعد معيارًا صناعيًا. فقد لاحظ المجتمع التقني أن الضغط العدواني إلى 3 بتات في النماذج الصغيرة، حتى 3B من المعاملات، قد يضر بالجودة بشكل ملحوظ، ويسبب تكرارًا ويُضعف ترابط النص. وفي كثير من السيناريوهات العملية يبقى الوضع بدقة 4 بتات الخيار الأكثر أمانًا.
إضافة إلى ذلك، لم تنشر Google حتى الآن سوى تدوينة ونسخة أولية من الورقة العلمية (preprint). لا توجد تنفيذات رسمية بعد، والخوارزمية غير مدمجة في vLLM وllama.cpp وSGLang اعتبارًا من 29 أبريل 2026.
كما يدور نزاع علمي حول أسبقية الفكرة. فقد صرّح جيانيانغ غاو، أحد مؤلفي خوارزمية RaBitQ الأسبق، بأن TurboQuant قريبة جدًا من نهجهم، وأنها في الوقت نفسه تصف سابقتها بشكل غير دقيق. ومن بين المآخذ التقليل من التشابه المنهجي، ونقد مثير للجدل لنظرية RaBitQ، ومقارنة في ظروف غير متكافئة: فقد اختُبرت TurboQuant على وحدات GPU من طراز A100، بينما اختُبرت RaBitQ في أحد المعايير على Python أحادي المسار. وقد رُفعت الشكوى بالفعل إلى لجنة الأخلاقيات في ICLR، فيما لم تقدّم Google ردًا علنيًا حتى الآن.
ماذا يعني هذا
لا تبدو TurboQuant انهيارًا لسوق الذاكرة، بل تحسينًا قويًا في نقطة ضيقة محددة من استدلال LLM. وإذا أصدرت Google الشيفرة ودخلت الطريقة في الأنظمة القياسية، فستصبح السياقات الطويلة أرخص، وسيغدو تشغيل النماذج الكبيرة على عتاد أكثر تواضعًا أمرًا أقرب إلى الواقع. لكن في الوقت الراهن هي نتيجة بحثية مهمة أكثر منها انقلابًا جاهزًا في الصناعة.
Access Frontier LLMs & Multimodal AI in One Workspace
Discover NomadNet AI (nomadnet.ai) — unified access to frontier language models, research synthesis, and multimodal workflows.
أهم ما في عالم الذكاء الاصطناعي — مرة كل أسبوع
سبع قصص مهمة فعلاً هذا الأسبوع، مختارة بعناية. بلا ضجيج ولا بيانات صحفية.
تم! تحقق من بريدك للتأكيد.