خوارزمية TurboQuant من Google تهوي بأسهم شركات تصنيع الذاكرة بعد نشر البحث
قدمت Google خوارزمية TurboQuant، وهي طريقة لضغط KV-cache في نماذج LLM تقلل استهلاك الذاكرة ستة أضعاف على الأقل ولا تضر بالجودة، بحسب الشركة. وجاء رد فعل السوق خلال ساعات: تراجعت أسهم Micron وWestern Digital وSanDisk لأن المستثمرين أعادوا على الفور حساب الطلب المستقبلي على الذاكرة المخصصة للذكاء الاصطناعي. وإذا ترسخ هذا النهج، فقد تصبح تكلفة الاستدلال (inference) أقل بوضوح.
معالج بواسطة الذكاء الاصطناعي من TNW؛ بتحرير Hamidun News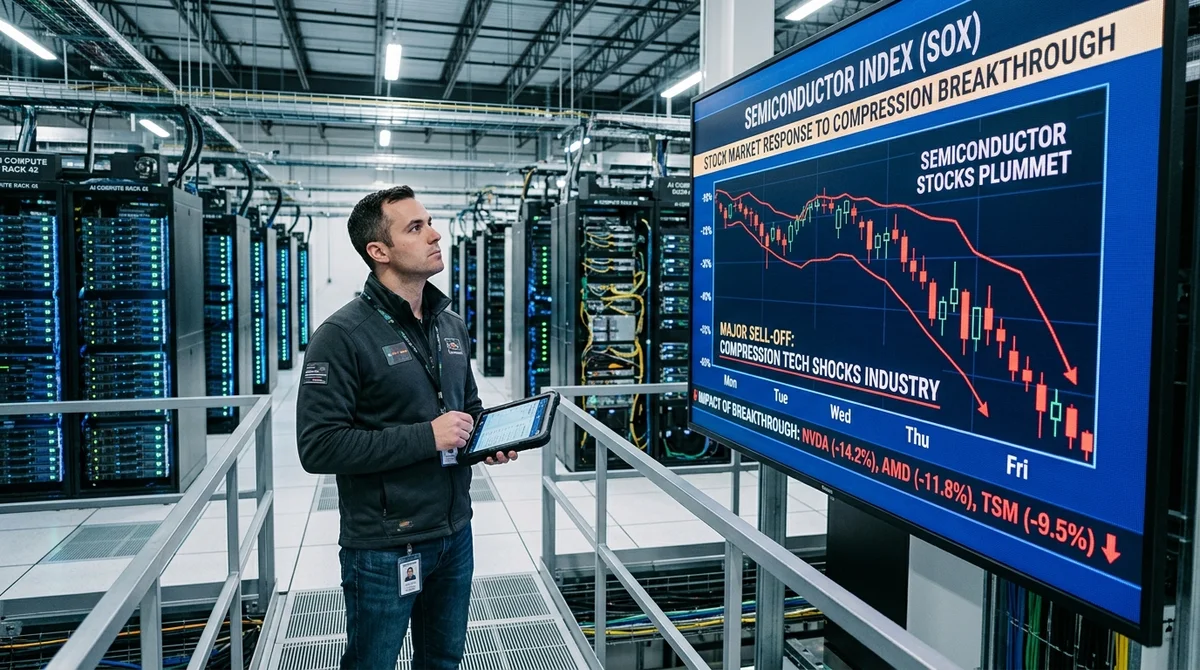
قدمت Google Research خوارزمية TurboQuant لضغط نماذج AI، وهي تقلل حجم الذاكرة العاملة الأساسية ستة أضعاف على الأقل دون خسارة ملحوظة في الجودة. وجاء رد فعل السوق فورياً: فبعد النشر في 24 مارس 2026 بدأ المستثمرون يعيدون النظر في حجم الذاكرة التي ستحتاجها صناعة الذكاء الاصطناعي التوليدي أصلاً.
ماذا عرضت Google
تعالج TurboQuant نقطة ضيقة لكنها مكلفة في استدلال النماذج اللغوية الكبيرة، وهي key-value cache أو KV-cache. وهو مخزن للسياق يتيح للنموذج ألا يعيد حساب الرموز (tokens) التي سبقت معالجتها. وكلما طال الطلب أو المستند أو الحوار، نما هذا الكاش أسرع، وزادت مساحة ذاكرة GPU التي يشغلها.
وبحسب Google، تضغط الطريقة الجديدة KV-cache إلى 3 بت لكل قيمة بدلاً من 16 بت المعتادة، وتخفض استهلاك الذاكرة بمقدار ستة أضعاف على الأقل. وهذا مهم للتطبيق العملي بقدر أهميته للبحث العلمي. فالذاكرة المحررة تتيح خدمة عدد أكبر من الطلبات المتزامنة على العتاد نفسه، أو تشغيل نوافذ سياق أطول، أو استخدام نماذج أكبر دون توسيع أسطول المسرّعات.
ويشير المؤلفون إلى أن TurboQuant لا تتطلب إعادة تدريب أو fine-tuning، وأنها ستُعرض في مؤتمر ICLR 2026. واستُخدمت في الاختبارات نماذج من عائلات Gemma وMistral وLlama، إضافة إلى معايير long-context القياسية.
كيف تعمل الخوارزمية
يقوم TurboQuant على مخطط من مرحلتين. أولاً، تحوّل طريقة PolarQuant المتجهات إلى تمثيل قطبي للتخلص من البيانات الإضافية التي تلتهم عادة جزءاً من مكاسب التكميم التقليدي. ثم تأتي QJL، وهي تقنية ترمّز الخطأ المتبقي ببت إضافي واحد فقط لكل بُعد، وتقلل التشوهات في attention. والنتيجة أن معظم ميزانية البتات يذهب إلى الحفاظ على معنى البيانات الأصلية، لا إلى الكلفة التقنية الزائدة.
تصف
Google الـ KV-cache بأنه «ورقة غش رقمية عالية السرعة» للنموذج.
- ضغط KV-cache من 16 إلى 3 بت
- تقليل الذاكرة ستة أضعاف على الأقل
- تسريع حساب attention حتى 8 أضعاف على Nvidia H100 في وضع 4 بت
- العمل دون تدريب أو fine-tuning
- إمكانية التطبيق لا في LLM فحسب، بل في البحث المتجهي أيضاً
وتؤكد Google أن TurboQuant حافظت في مهام Needle in a Haystack على نتيجة مثالية حتى مع ضغط الكاش ستة أضعاف. وفي LongBench وZeroSCROLLS لم تتخلف الطريقة عن KIVI، وهي إحدى الطرق الأساسية المعروفة لتكميم KV-cache، بل تفوقت عليها. كما اختبرت الشركة TurboQuant في vector search، وحصلت على recall أعلى دون كتب شفرات (codebooks) كبيرة ودون ضبط خاص بمجموعة بيانات بعينها. وهذا يمس مباشرة مجالات البحث والتوصية وأنظمة الإعلانات.
لماذا تفاعل السوق
لم يرَ سوق الأسهم في هذا المنشور تقدماً أكاديمياً، بل إشارة إلى احتمال تراجع الطلب على الذاكرة المخصصة لبنية AI التحتية. فخلال ساعات من صدور المادة، انخفضت أسهم Micron بنسبة 3%، وWestern Digital بنسبة 4,7%، وSanDisk بنسبة 5,7%.
والمنطق بسيط: إذا صار المكون الرئيسي في الاستدلال يحتاج فجأة إلى ذاكرة أقل بأضعاف، فقد لا تبدو مشتريات HBM وDRAM ووحدات التخزين مستقبلاً بالخطية التي افترضها المستثمرون. لكن هذا لا يعني أن الصناعة ستحتاج فجأة إلى عتاد أقل بست مرات. فالذاكرة بند واحد فقط من بنود إنفاق مراكز البيانات، وشهية النماذج للحوسبة تنمو أسرع من أي تحسين محلي. وحتى المحللون يحذرون من الاستنتاجات المباشرة أكثر من اللازم: فخوارزميات الضغط وُجدت من قبل، لكنها لم تُسقط الطلب على البنية التحتية بأكملها. وغالباً ما يُظهر تاريخ الحوسبة الأثر المعاكس: فما إن تصبح الموارد أرخص، حتى تبدأ الشركات ببناء أنظمة أثقل وأوسع انتشاراً بالميزانية نفسها.
ماذا يعني ذلك
لا تشكل TurboQuant سبباً لشطب شركات تصنيع الذاكرة، بل مؤشراً مبكراً على مرحلة جديدة من سباق الكفاءة. فلن يفوز من الآن من يشتري مزيداً من GPU فحسب، بل أيضاً من يستطيع ضغط الاستدلال بقوة أكبر دون خسارة في الجودة. وبالنسبة لمنتجات AI، تمثل الخوارزمية فرصة لخفض كلفة الطلب الواحد؛ أما بالنسبة للسوق، فهي تذكير بأن البرمجيات باتت تؤثر في القيمة السوقية للعتاد.
Access Frontier LLMs & Multimodal AI in One Workspace
Discover NomadNet AI (nomadnet.ai) — unified access to frontier language models, research synthesis, and multimodal workflows.
أهم ما في عالم الذكاء الاصطناعي — مرة كل أسبوع
سبع قصص مهمة فعلاً هذا الأسبوع، مختارة بعناية. بلا ضجيج ولا بيانات صحفية.
تم! تحقق من بريدك للتأكيد.