OpenGrall تقدّم بنية للروبوتات المدعومة بالذكاء الاصطناعي يتولى فيها النموذج اللغوي الاستراتيجية
يقترح OpenGrall عدم إسناد الحركة مباشرة إلى LLM: فالنموذج اللغوي يتخذ القرارات رفيعة المستوى فقط، بينما تتولى حلقة TinyML التنفيذ وردود الفعل الطارئة. تُجمع بيانات الحسّاسات بصورة غير متزامنة وتُوزن بحسب حداثتها وموثوقيتها، وتُخزَّن المواقف المتكررة في ذاكرة مؤقتة. نتيجة ذلك أن الروبوت لا يتجمّد عند كل خطوة، ويمكنه العمل حتى مع نماذج محلية مدمجة.
معالج بواسطة الذكاء الاصطناعي من Habr AI؛ بتحرير Hamidun News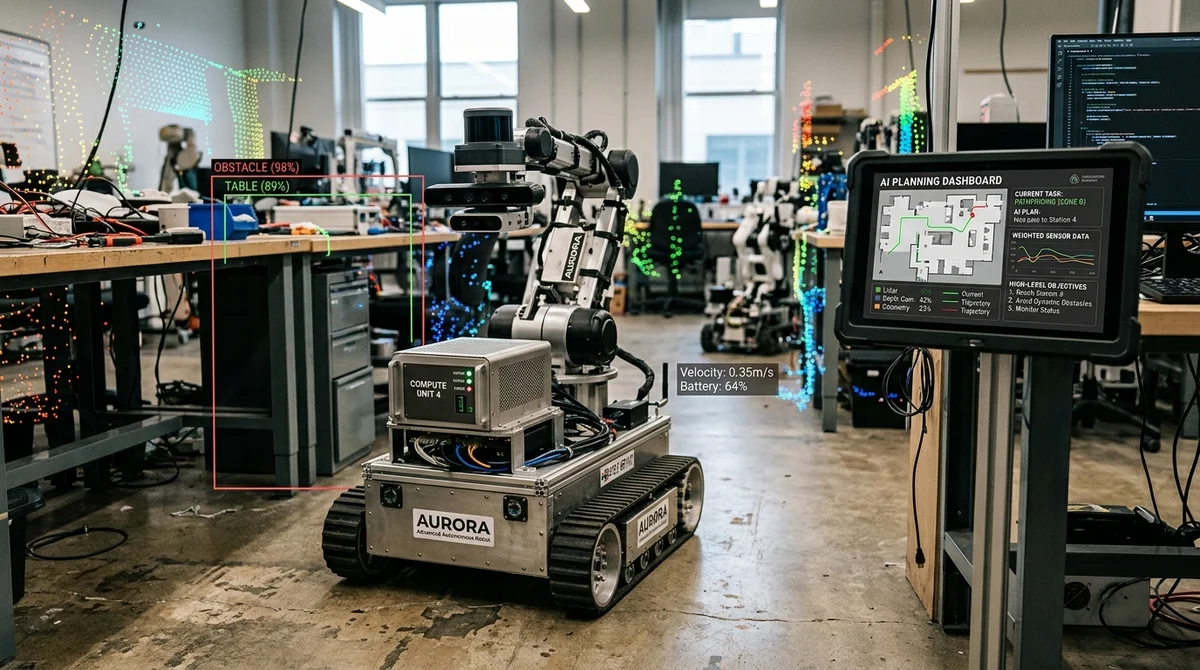
يقترح OpenGrall تحوّلًا بسيطًا لكنه مهم في الروبوتات: لا ينبغي أن يتحكم LLM بالروبوت على مستوى المحركات وردود الفعل اللحظية. فالنموذج اللغوي هنا مسؤول عن المعنى والخطة واختيار الخطوة التالية فقط، أما السلامة والحركة وردود الفعل منخفضة المستوى فقد نُقلت إلى حلقة منفصلة. وبهذا يحاول المشروع إزالة المشكلة الرئيسية في معظم عروض «الروبوتات المعتمدة على GPT»، حيث تتحدث الآلة بطلاقة، ثم تتجمّد عدة ثوانٍ قبل كل إجراء.
يبدأ المؤلفون من أكثر النقاط حساسية، وهي السلامة. فـ LLM غير حتمي: قد يعطي الطلب نفسه إجابات مختلفة، ولذلك فإن الوثوق به في التحكم المباشر بالمحركات أمر خطِر. ولهذا يقدّم OpenGrall مخططًا هجينًا يؤدي فيه نموذج TinyML، أو أي حلقة تنفيذ صارمة أخرى على متحكم دقيق، دور «الحبل الشوكي».
وهذه الحلقة هي التي تعرف فيزياء المنصة المحددة، وتتحكم في نظام التعليق وتجاوز العوائق، وتملك حق النقض (الفيتو) على أي أمر. فإذا طلب المشغّل أو LLM التقدّم إلى الأمام بينما يرصد مقياس المسافة جسمًا على بُعد أقل من 10 سنتيمترات، فلن يُنفَّذ الأمر ببساطة. وزمن الاستجابة المعلن للإيقاف الطارئ أقل من 10 ميلي ثانية.
والمنطق هنا عملي إلى أقصى حد: LLM يفكّر، والوحدة التنفيذية تفعل، ويمكنها في أي لحظة إيقاف إجراء خطِر.
أما نقطة القوة الثانية في OpenGrall فهي النمطية. فالمشروع يفصل بين «التفكير» و«التنفيذ» بحيث يمكن تغيير كل جزء بصورة مستقلة. ويمكن أن يؤدي دور العقل LLM محلي، أو VLM، أو نموذج سحابي إذا لزمت مهمة أعقد مثل خطة متعددة الخطوات أو البحث على الويب.
ويمكن أن يؤدي دور المنفّذ TinyML، أو نموذج VLA، أو حتى خوارزمية صارمة تقليدية إذا كانت المنصة بسيطة. ويرتبط النظام كله عبر خادم WebSocket، وتتصل الأجهزة به كعملاء عاديين بأدوار مثل agent وoperator وlidar وesp. وهذا يتيح إضافة حسّاسات جديدة دون إعادة كتابة النواة، بل وبناء مخطط يعمل فيه وكيل واحد مع عدة أجسام في آن واحد، مثل منصة بعجلات وطائرة مسيّرة.
وبالنسبة لمشروع مفتوح المصدر يعمل على عتاد ضعيف، فهذه نقطة بالغة الأهمية: فالبنية غير مرتبطة بنوع واحد من الروبوتات ولا بنموذج واحد بعينه.
الوحدة الهندسية المحورية هي الثنائي SensorMemory وWeightCalculator. فبدلًا من إرسال جميع التدفقات الخام إلى LLM دون تمييز، يجمع النظام البيانات بصورة غير متزامنة، ويقيّم حداثتها ومستوى الثقة بها، ثم يحوّلها إلى موجّه (prompt) قصير. وإذا اتسخ الليدار أو أُعميت VLM بضوء الشمس، ينخفض وزنهما قبل لحظة اتخاذ القرار. وإذا كان أحد الحسّاسات بطيئًا فلا يعطّل بقية الحسّاسات. ويورد المقال مثالًا موضّحًا: تُطوى سحابة نقاط الليدار في ثمانية قطاعات، وتُوصف الأجسام القريبة عبر الزاوية والمسافة والحجم والسرعة. وهكذا لا تكون هذه البيانات ضجيجًا بالنسبة لـ LLM، بل موقفًا منظّمًا.
وثمة فارق مهم: لا يحاول OpenGrall كتابة قواعد معقدة لدمج البيانات يدويًا. فالحَكَم هو LLM نفسه، الذي يرى مصدر كل إشارة وعمرها ووزنها، ويختار على هذا الأساس الإجراء بصيغة JSON. كما يُدمج موجّه النظام في النموذج مسبقًا، مثلًا عبر Ollama، ولذلك لا يُرسل في الحلقة العاملة سوى الجزء التشغيلي «العاري» من الطلب. وبحسب تقدير المؤلف، يقلّص ذلك الموجّه من نحو 450 إلى نحو 150 رمزًا (token).
ويركّز المقال بصورة منفصلة على مكافحة «البطء». ففي كثير من الأطر الكلاسيكية ينتظر الروبوت أبطأ حسّاس، وبسبب ذلك تظل القياسات عن بُعد السريعة معطّلة فعليًا. ويتخلى OpenGrall عن هذا النوع من المزامنة: فالليدار وVLM وقياس المسافة المقطوعة (odometry) تكتب بياناتها في الذاكرة بصورة مستقلة، ويأخذ الوكيل أحدث القيم وأكثرها موثوقية في اللحظة الراهنة. ومع ذلك يظل LLM يفكّر مئات الميلي ثانية، ولذلك أُضيفت على جانب ESP32 حركة بالقصور الذاتي: إذا لم يصل أمر جديد بعد، فلا يتجمّد الروبوت في مكانه، بل يواصل بسلاسة آخر إجراء آمن مع تخميد تدريجي للسرعة.
وهناك طبقة تحسين أخرى هي تخزين القرارات مؤقتًا بحسب تجزئة (hash) السياق. فإذا واجه الروبوت الممر الفارغ نفسه مجددًا، فلا يستدعي النموذج من جديد، بل يأخذ قرارًا سبق التحقق منه من الذاكرة المؤقتة. وتتطور هذه الفكرة لاحقًا نحو عادات وردود فعل عالية المستوى: فالاستراتيجيات الناجحة يمكن أن تُنفَّذ دون LLM، وتعزّز ملاحظات الإنسان وزنها. وإضافة إلى ذلك، يحتفظ المشروع بذاكرة عَرَضية لتعليمات الإنسان، بل ويتيح تحديد الأهداف ذاتيًا، حيث يختار الروبوت في وقت الخمول بنفسه ما يستكشفه أو ما يحفظه أو مع من يبدأ حوارًا.
وإذا نظرنا إلى الصورة الأوسع، فإن OpenGrall مثير للاهتمام لا بوصفه محاولة أخرى لـ«ربط GPT بروبوت»، بل كمحاولة للارتقاء بروبوتات LLM إلى بنية أكثر نضجًا. فلا وعد هنا بعقل شامل سحري، لكن هناك توزيعًا واضحًا للمسؤوليات، وعملًا على عتاد محدود، وحماية من الإجراءات الخطرة، ومسارًا نحو تعلّم تدريجي دون إعادة تدريب شاملة للنظام بأكمله. وبالنسبة للمطورين، يعني ذلك طريقة أكثر واقعية لبناء الروبوتات على أساس النماذج الحديثة: استخدام LLM حيث يتفوّق، وعدم إجباره على ما تناسبه أكثر حلقة تنفيذ صغيرة وسريعة ويمكن التنبؤ بسلوكها.
- 31 أكتوبر 2026وكلاء الذكاء الاصطناعي يعدّلون نشرات الاكتتاب العام وفق ملاحظات SEC: التعلّم أضاف 3,7 نقطة مئوية
- 31 أكتوبر 2026Mirendil تعلن Fern 0.1: سياق بطول 10 ملايين توكن، لكن أداء الوكيل ضعيف
- 30 أكتوبر 2026Mistral تفتح أوزان Large 4: قوي في البرمجة، لكن النماذج الصينية تسجل 32 نقطة مقابل 26
- 30 أكتوبر 2026128 وكيل ذكاء اصطناعي بلا قائد اجتازوا اختبارات أكثر بنسبة 49% من وكيل واحد
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
أهم ما في عالم الذكاء الاصطناعي — مرة كل أسبوع
سبع قصص مهمة فعلاً هذا الأسبوع، مختارة بعناية. بلا ضجيج ولا بيانات صحفية.
تم! تحقق من بريدك للتأكيد.