MarkTechPost تستعرض دورة تدريب النماذج اللغوية الكبيرة كاملةً: من البيانات إلى النشر
النموذج اللغوي الكبير الحديث ليس نتاج عملية تدريب واحدة ضخمة، بل خط إنتاج طويل يضم التدريب المسبق وSFT وLoRA/QLoRA وRLHF وتحسين الاستدلال والنشر. يبيّن تحليل MarkTechPost أن القدرات الأساسية للنموذج تتشكل في مرحلة العمل على البيانات الخام. أما فائدته العملية فتظهر لاحقًا، حين يُدرَّب النموذج على مهمة محددة، ويُواءَم مع توقعات البشر، ويُجهَّز للعمل تحت الأحمال الفعلية.
معالج بواسطة الذكاء الاصطناعي من MarkTechPost؛ بتحرير Hamidun News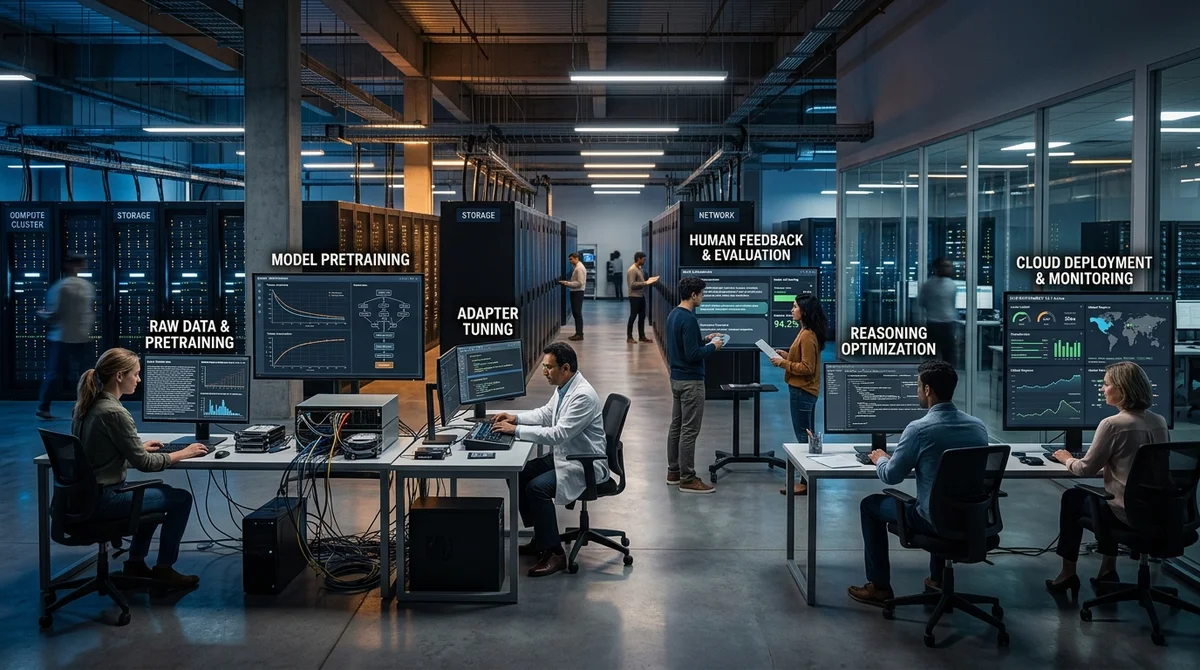
لا يولد النموذج اللغوي الكبير من مرور واحد على البيانات، بل هو سلسلة هندسية طويلة، وأي خطأ في أي مرحلة منها ينعكس على الجودة والأمان وتكلفة التشغيل. يصف التحليل التقني الذي نشره MarkTechPost المسار الكامل للنموذج اللغوي الكبير الحديث، من التدريب المسبق إلى النشر في بيئة الإنتاج، ويوضح لماذا قد يتصرف نموذجان متقاربان في الحجم بشكل مختلف تمامًا. ولا تصنع هذا الفارق البنية المعمارية وحدها، بل جودة خط الإنتاج بأكمله: البيانات، وضبط السلوك، والمواءمة، والبنية التحتية.
المرحلة الأولى هي التدريب المسبق. في هذه المرحلة يتلقى النموذج مجموعات ضخمة من البيانات الخام: كتبًا ومواقع إلكترونية ووثائق تقنية وشيفرات برمجية ومدونات نصية أخرى. ولا يُدرَّب النموذج هنا على مهمة تجارية بعينها، بل يتعلم الأنماط العامة للغة، والروابط بين المفاهيم، وبنية الحجة، وأنماط الاستدلال الأساسية. والهدفان المعتادان في هذه المرحلة هما التنبؤ بالرمز التالي (token) أو استعادة الكلمات المحذوفة. وهذا التدريب المسبق تحديدًا هو ما يحوّل شبكة عصبية مهيأة عشوائيًا إلى نظام قادر على مواصلة النص بمعنى متماسك والاحتفاظ بالسياق. وإذا كان هذا الأساس ضعيفًا، فلن تمنح التحسينات اللاحقة نتيجة قوية حقًا.
تأتي بعد ذلك مرحلة الضبط الدقيق الخاضع للإشراف، أي supervised fine-tuning أو SFT. هنا لم يعد النموذج يُغذّى بكتلة نصية خام فحسب، بل يبدأ التدريب على أزواج «مدخل-مخرج» موسومة. وهذا يتيح تكييفه مع تعليمات محددة وأسلوب الإجابة ونبرة التواصل والقواعد الخاصة بالقطاع. ويظهر الفرق بوضوح في مثال بسيط: قد يرد النموذج الأساسي على شكوى المستخدم بإجابة جافة وموجزة، أما بعد SFT فيقدّم إجابة منظمة ومهذبة ومفيدة بخطوات واضحة. وفي هذه المرحلة تحديدًا تُدمج في النموذج الخبرة المتخصصة ومتطلبات الشركة وصيغة التواصل المطلوبة. أي أن التدريب المسبق يجيب عن سؤال «ما الذي يستطيع النموذج فعله أصلًا»، بينما يجيب SFT عن سؤال «كيف ينبغي أن يتصرف تحديدًا في السيناريو التطبيقي».
غير أن الضبط الكامل للنماذج الكبيرة باهظ التكلفة، ولذلك تُستخدم في الواقع العملي طرق تكيّف اقتصادية على نطاق واسع. ويخص MarkTechPost بالذكر تقنيتي LoRA وQLoRA. ففي LoRA تُجمَّد الأوزان الأساسية للنموذج، ويجري التدريب فقط عبر مصفوفات صغيرة منخفضة الرتبة تُدمج في بعض الطبقات.
وهذا يقلل بشكل حاد عدد المعاملات القابلة للتدريب، والحمل على الذاكرة، ووقت التدريب. أما QLoRA فتمضي أبعد من ذلك: فهي تجمع النهج نفسه مع تكميم النموذج الأساسي، مثلًا إلى 4 بت، ما يتيح تكييف نماذج كبيرة جدًا دون متطلبات مفرطة من البنية التحتية. والمغزى العملي بسيط: لم يعد من الضروري أن تلجأ الشركة إلى إعادة تدريب كاملة (retrain) لكل مهمة جديدة.
فيمكنها أخذ نموذج أساسي قوي وضبطه بتكلفة منخفضة نسبيًا للمحامين أو الدعم الفني أو المحللين أو المساعد الداخلي.
بعد ذلك تأتي المواءمة. فحتى لو كان النموذج واسع المعرفة ويتبع التعليمات بشكل جيد، فقد يظل يجيب بحدة زائدة أو بطريقة غير آمنة، أو ببساطة بما يخالف توقعات المستخدم. ولهذا يُستخدم RLHF، أي التعلم المعزز من التغذية الراجعة البشرية.
يقارن البشر بين عدة إجابات للنموذج ويرتبونها، وعلى هذا الأساس يُدرَّب نموذج مكافأة (reward model)، ثم يُحسَّن النموذج اللغوي نفسه ليقدّم الإجابات المفضلة بوتيرة أعلى. ويذكر النص أيضًا GRPO، وهو نهج أحدث يستهدف تحسين الاستدلال (reasoning) والحلول متعددة الخطوات. هنا يولّد النموذج عدة صيغ للإجابة عن الطلب الواحد، ثم يجري التدريب وفق المقارنة داخل المجموعة، لا وفق تقييم مطلق لكل إجابة.
وتفيد هذه الآلية خصوصًا حيث لا تقتصر الأهمية على الجواب النهائي، بل تشمل جودة سلسلة الاستدلال: الرياضيات والمسائل المنطقية والشروحات المتسلسلة.
المرحلة الأخيرة هي النشر (deployment)، وفيها يتحول النموذج البحثي إلى منتج. ففي بيئة الإنتاج لا تهم قيمة الخسارة (loss) ولا جودة مجموعة البيانات في حد ذاتها، بل زمن الاستجابة وتكلفة الاستدلال وسعة المعالجة وتحميل وحدات GPU والثبات تحت الحمل الفعلي. ولذلك تُحسَّن النماذج إضافةً إلى ذلك: تُكمَّم، وتُشغَّل عبر محركات استدلال متخصصة مثل vLLM وTensorRT-LLM وSGLang، وتُغلَّف بواجهة API، وتُستضاف إما في السحابة وإما في بيئة مستضافة ذاتيًا (self-hosted) عندما يكون التحكم في البيانات والجدوى الاقتصادية عاملين مهمين. وفوق ذلك تُبنى منظومة المراقبة: رصد زمن الاستجابة (latency) والإنتاجية (throughput) واستهلاك الذاكرة، مع التوسع التلقائي. ومن دون ذلك يتحول حتى النموذج القوي سريعًا إلى خدمة مكلفة وغير مستقرة.
الخلاصة الرئيسية من تحليل MarkTechPost أن جودة النموذج اللغوي الكبير لا تحددها مرحلة «سرية» واحدة، بل مجموعة القرارات على امتداد المسار كله. فالتدريب المسبق يمنح المادة الأولية للذكاء، وSFT يجعل النموذج مفيدًا لمهمة محددة، وLoRA وQLoRA تخفضان تكلفة التكيّف، وRLHF وGRPO تصقلان السلوك والمنطق، بينما يحسم النشر ما إذا كان النظام بأكمله قادرًا على العمل فعليًا، بسرعة وبشكل يمكن التنبؤ به. وهذه إشارة مهمة للسوق: فالمنافسة بين منتجات الذكاء الاصطناعي تنتقل أكثر فأكثر من حجم النموذج بحد ذاته إلى جودة المنظومة الهندسية المحيطة به.
- 2 نوفمبر 2026Steering vectors أثناء ضبط LLM تحسّن SFT والتقطير على ثلاث بذور عشوائية
- 2 نوفمبر 2026EDU-Jev 4B يقيّم أعمال الطلاب بدقة 67,6% ويتفوق على واجهات API التجارية بـ9,4 نقطة مئوية
- 28 أكتوبر 2026Anthropic تكشف كيف تبني Claude بواسطة Claude: الدماغ منفصل عن الأيدي
- 28 أكتوبر 2026Bayer تطلق محركًا متعدد الوكلاء على AgentCore: 80% من الأسئلة دون مهندسين
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
أهم ما في عالم الذكاء الاصطناعي — مرة كل أسبوع
سبع قصص مهمة فعلاً هذا الأسبوع، مختارة بعناية. بلا ضجيج ولا بيانات صحفية.
تم! تحقق من بريدك للتأكيد.