Habr AI
Source d'actualités IA. Les articles sont sélectionnés et adaptés par la rédaction de Hamidun News.
Dernières publications
GPTunneL et la tendance Forbes : pourquoi les super-apps d'IA deviennent le nouveau moteur de croissance du marché
GPTunneL, qui compte désormais 2 millions d'utilisateurs, explique comment les super-apps d'IA transforment les usages, la demande des entreprises et l'économie du marché, de la Chine et des États-Unis à la Russie.
Sur Habr, un tutoriel montre comment entraîner un mini-LLM en C# avec ILGPU et un GPU AMD intégré
Un article de Habr explique comment construire et entraîner un LLM minuscule en C# avec ILGPU et OpenCL, l'exporter en GGUF et le lancer dans LM Studio, même sur un GPU AMD intégré.
Anthropic dévoile Claude Mythos Preview par une system card de 244 pages plutôt qu'un lancement
Anthropic a présenté Claude Mythos Preview non par un lancement classique, mais par une system card de 244 pages détaillant les capacités du modèle, ses risques et les raisons d'un accès limité.
OpenAI et Anthropic changent le calcul du coût des modèles de langage : en 2026, c'est le prix de la tâche qui compte
OpenAI et Anthropic changent les règles de tarification des LLM : en 2026, il ne suffit plus aux entreprises de suivre le prix du token ; il faudra calculer le coût complet d'une tâche résolue.
Claude Code devient un analyste IA fondé sur BABOK : il mène les entretiens et recueille les exigences
Un assistant d'analyse métier bâti sur Claude Code suit BABOK v3 : il aide à mener des entretiens, recueillir des exigences, ne sauter aucune étape et produire des livrables.
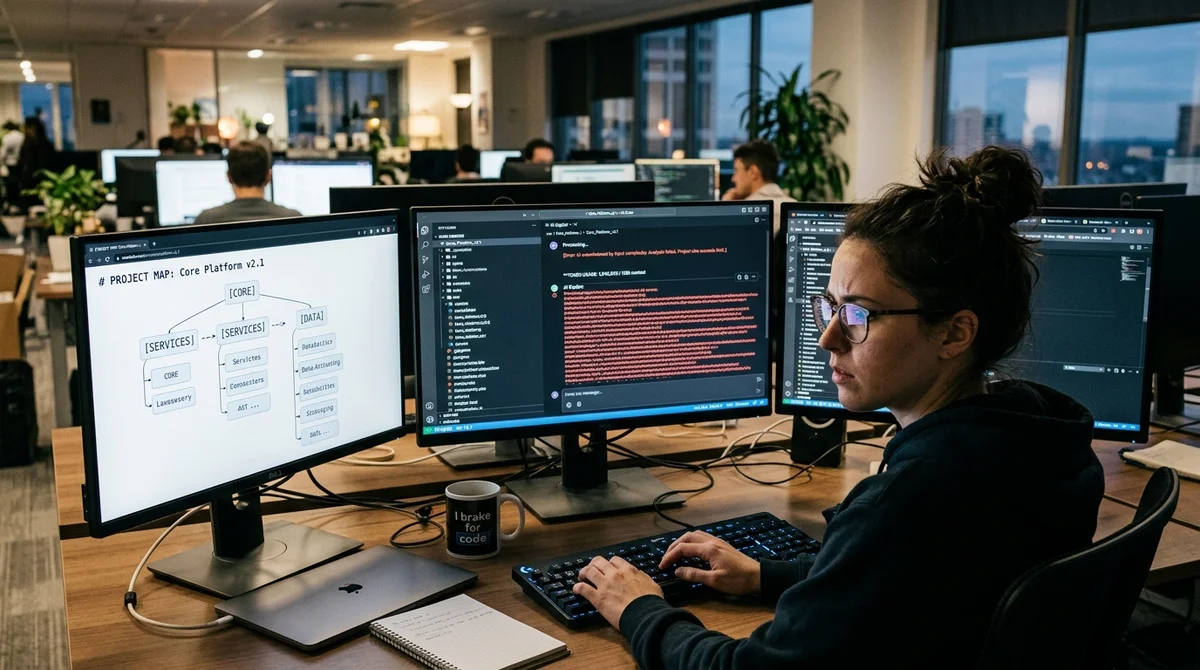
Claude Code et Codex : réduire le gaspillage de tokens avec trois fichiers markdown
Claude Code et Codex consacrent souvent l'essentiel de leur contexte à re-explorer les projets ; une hiérarchie carte globale, CLAUDE.md et mémoire des sessions règle le problème.
LM Studio et Qwen : comment les LLM locaux se débrouillent en code sur un MacBook M4 Pro
L'auteur a testé des modèles locaux Qwen, Gemma et d'autres pour coder via LM Studio sur un MacBook M4 Pro : en chat, ils sont déjà viables, mais en mode agent, ils restent nettement derrière le cloud.
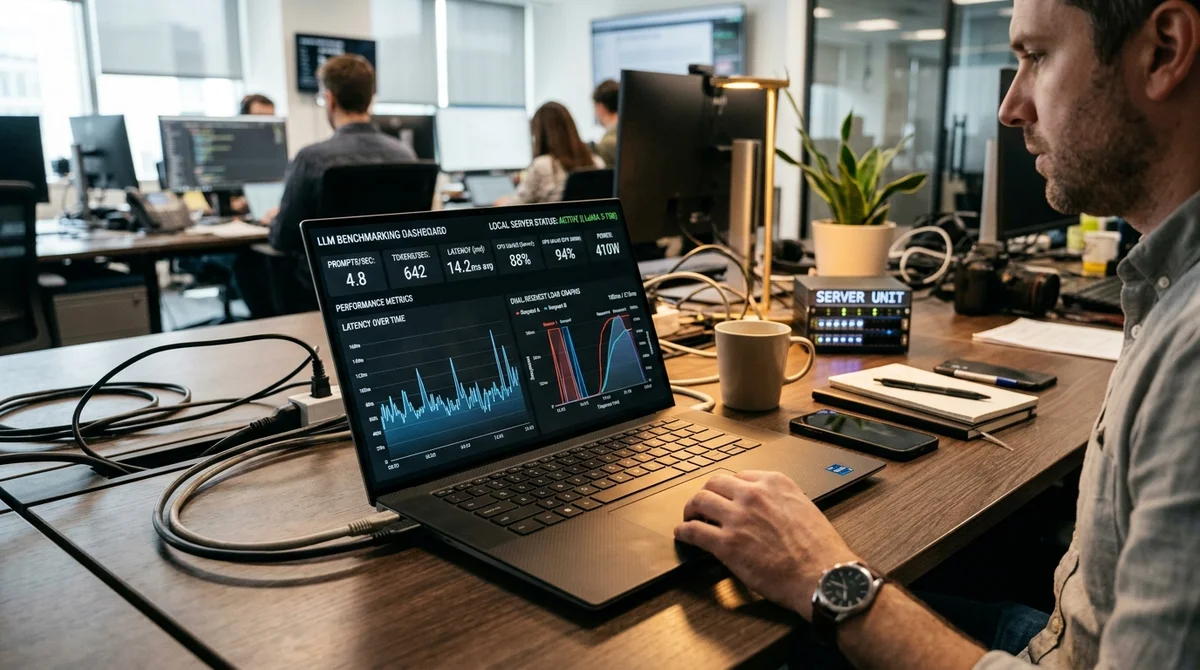
Qwen 3.5 sur MacBook Pro : huit serveurs locaux comparés pour le travail en équipe
L'auteur a testé huit serveurs MLX sur un MacBook Pro M2 Max avec Qwen 3.5 35B : face à des requêtes parallèles, presque tous perdent brutalement en vitesse.
Selectel : l'IA ne supprime pas le travail, mais rend l'entrée dans le métier nettement plus difficile
Selectel décrit un nouveau marché du travail autour de l'IA : les postes ne disparaissent pas, mais les juniors peinent à entrer, tandis que demande et salaires se déplacent vers ceux qui savent travailler avec les modèl
Habr AI publie un guide sur ChatGPT, Claude et MCP pour les débutants
Habr AI explique sans théorie superflue ce qui distingue modèles locaux et cloud, pourquoi payer un abonnement, comment fonctionnent les agents et pourquoi MCP s'impose comme standard.
Yoshua Bengio et LawZero : pourquoi la peur de l'IA de demain détourne des menaces d'aujourd'hui
Un texte sur le « pari de Pascal » appliqué à l'IA soutient que la peur d'une superintelligence hypothétique détourne l'attention de menaces bien réelles : surveillance, pouvoir des entreprises et pression sur les salari
Claude Opus 4.7 d'Anthropic consomme plus de tokens que annoncé
Des mesures du nouveau tokenizer de Claude Opus 4.7 montrent une hausse de 45–47 % de la consommation, contre 0–35 % promis par Anthropic, avec des effets sur quotas, cache et plan Max.
OpenAI lance GPT-Rosalind en biologie : ce que sait faire le nouveau modèle et où sont ses limites
OpenAI lance GPT-Rosalind pour les sciences du vivant et le relie à un module de recherche de Codex, en promettant d'accélérer hypothèses et expériences sans assembler à la main des dizaines de services.
Un audit de Cursor met au jour quatre failles dans la protection de l'éditeur de code, sans parvenir à contourner l'autorisation
L'audit technique de Cursor révèle une prototype pollution, un champ dev caché et des fuites d'architecture interne, mais confirme que l'abonnement et l'accès aux modèles premium restent vérifiés côté serveur.
Anthropic sort Opus 4.7, et OpenAI transforme Codex en agent qui pilote l'ordinateur
Semaine chargée dans l'IA : Anthropic passe à Opus 4.7, OpenAI donne à Codex le contrôle de l'ordinateur, Google et Baidu ouvrent de nouveaux modèles de voix et d'image.
ChatGPT a trouvé le bon diagnostic dans les cinq cas médicaux, mais a pris du retard sur le plan d'action
Dans une comparaison de cinq cas médicaux, ChatGPT ne s'est jamais trompé sur le diagnostic principal, mais il a nettement reculé sur les recommandations pratiques, les examens et le parcours du patient.
Pourquoi les services LLM ignorent vos instructions, et comment reprendre vraiment le contrôle
Même un prompt détaillé ne garantit pas une réponse docile : pourquoi les LLM cassent le format, cèdent aux injections et exigent des garde-fous d'ingénierie en plus du texte.
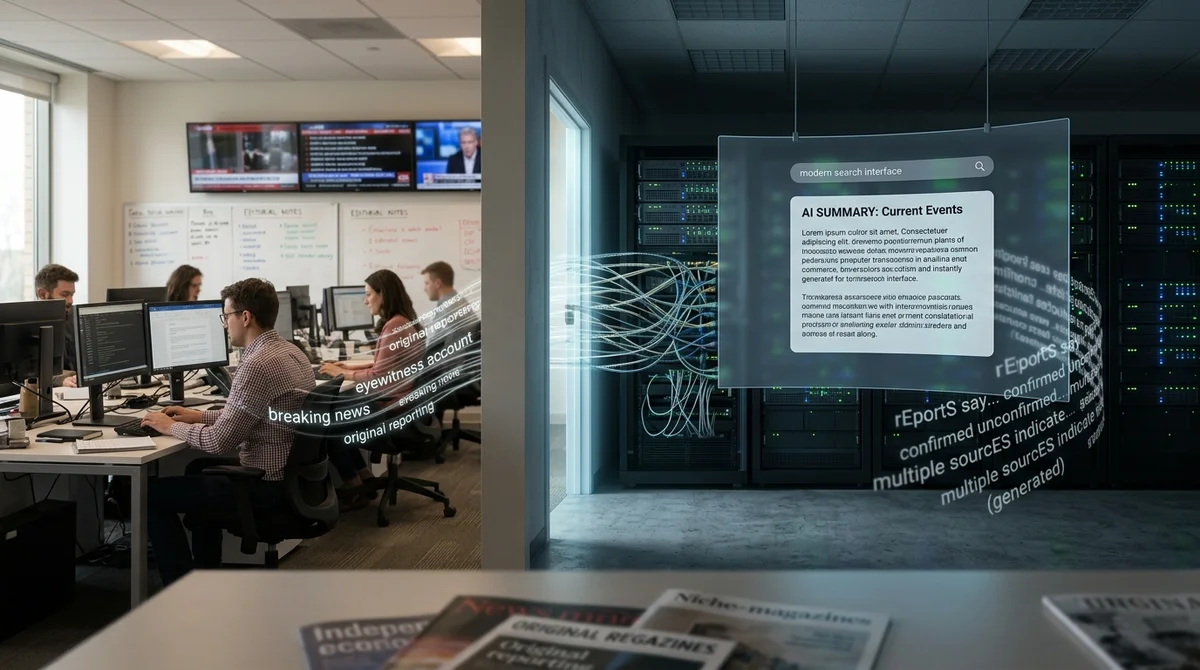
Google et OpenAI se heurtent à une limite : que se passe-t-il quand le web manque de texte humain ?
L'IA générative ne se contente pas de siphonner le trafic des sites avec ses résumés : elle sape aussi sa propre base d'entraînement. Moins écrire rapporte, plus le web et les futurs modèles s'appauvrissent.
Comment Moscow Credit Bank illustre l'évolution de la formation bancaire, des commis à l'IA
Moscow Credit Bank retrace la façon dont les banques ont formé leurs employés, du contrôle des pièces et de la correspondance commerciale à l'onboarding personnalisé, à la conformité et aux assistants d'IA.
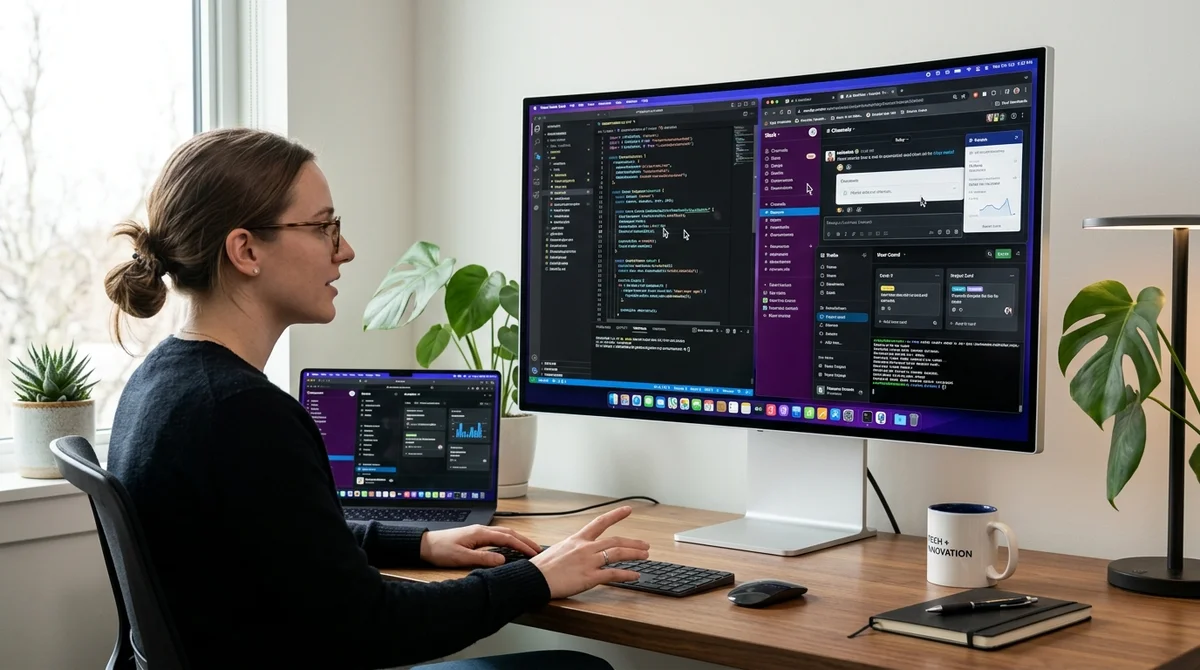
OpenAI intègre la technologie de Sky à Codex pour Mac et renforce le contrôle des applications en arrière-plan
OpenAI a transposé les travaux de Sky dans Codex pour Mac : l'agent pilote plusieurs applications en arrière-plan, utilise ses propres curseurs et exécute plus précisément les tâches routinières.
Habr AI explique comment la recherche de solutions pilotée par les données change l'architecture client-serveur
Un article de Habr AI détaille comment les systèmes experts à recherche de solutions pilotée par les données doivent organiser l'interaction avec l'utilisateur : en local, sur réseau local et via internet.
Seedance 2.0 attire l'attention par sa génération hyperréaliste de personnes et de scènes
Le système multimodal Seedance 2.0 accepte texte, images, audio et vidéo et produit des clips quasi cinématographiques, qui nourrissent déjà le débat sur les risques de deepfakes.
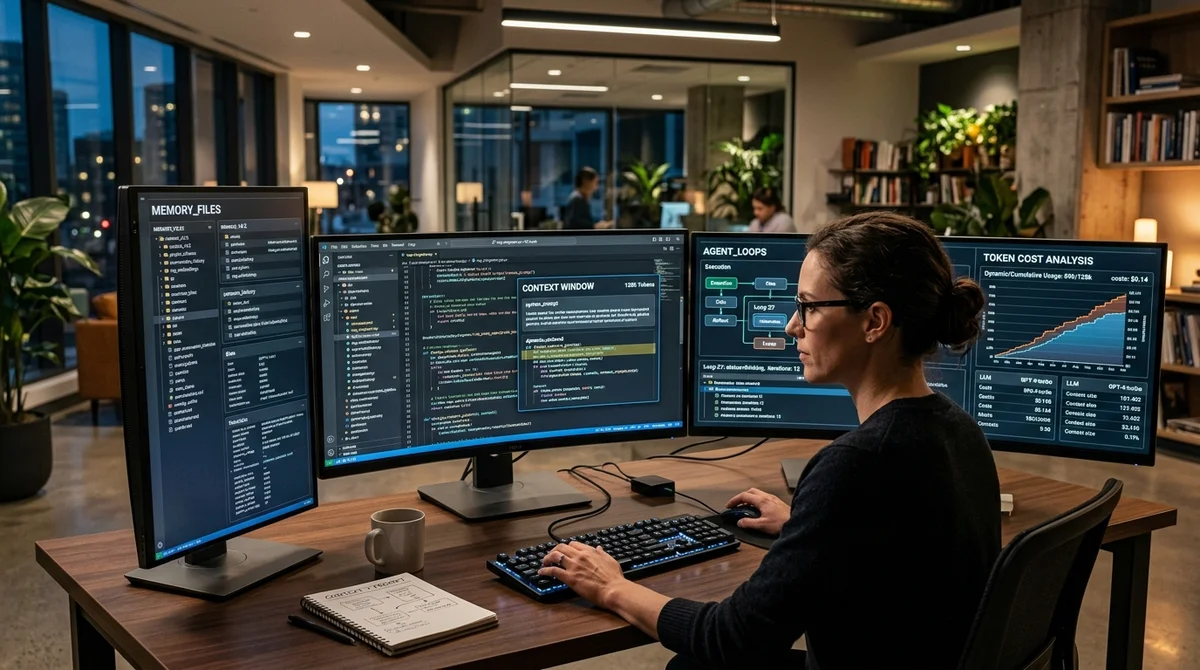
Claude Code et Codex changent la donne : l'ingénierie de contexte supplante le prompt
Une analyse sur le Context Engineering montre que dans Claude Code, Codex et les IDE agentiques, ce n'est plus le prompt qui tranche, mais la mémoire, les instructions système, les outils et l'assemblage du contexte.
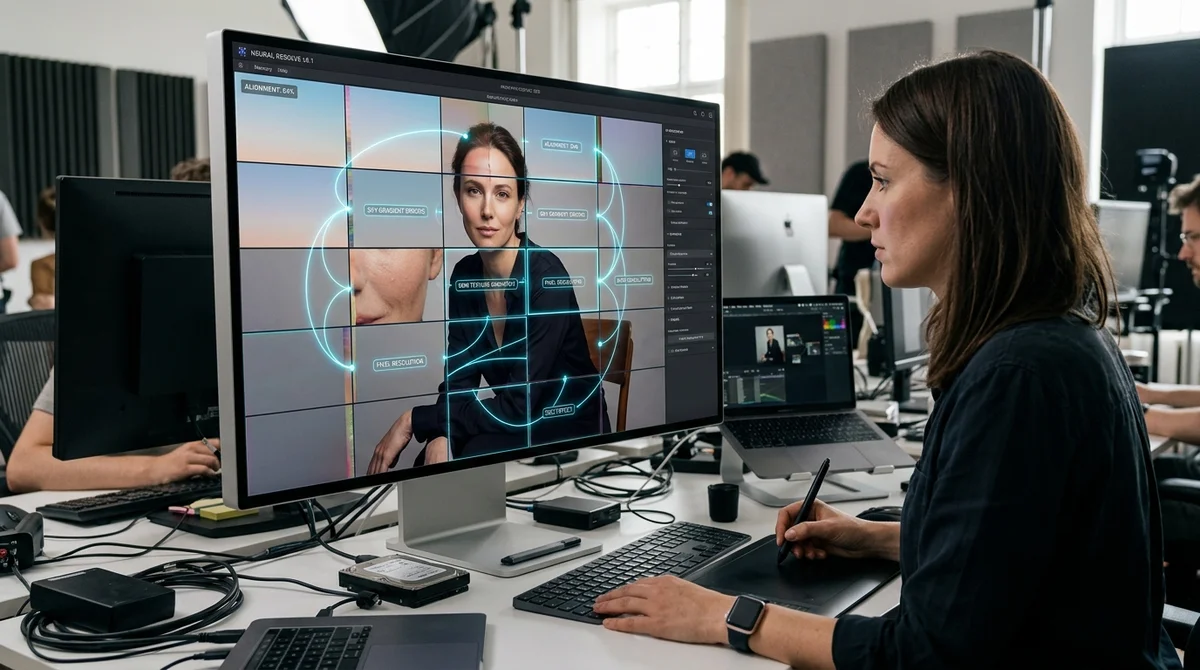
Pourquoi les modèles de diffusion laissent des coutures sur les photos de 40 mégapixels et comment donner une mémoire aux tuiles
Pourquoi le tiling brise les images de 40 à 150 mégapixels dans les modèles de diffusion, et quels mécanismes de mémoire de la diffusion vidéo pourraient être transposés à la photo.
Lyubomir Gorbatko présente Sessa, une alternative aux transformers et à Mamba
Un article sur Habr décortique Sessa, une architecture qui cherche à combiner les atouts de Transformer et de Mamba pour gérer les contextes longs sans perdre une mémoire contrôlable.
Harvard Business Review : quand l'usage intensif de l'IA fait « surchauffer » le cerveau
Harvard Business Review décrit l'« AI brain fry » : plus les salariés s'appuient sur Claude, Gemini et les agents, plus le risque de fatigue cognitive, de confusion et de décisions dégradées augmente.
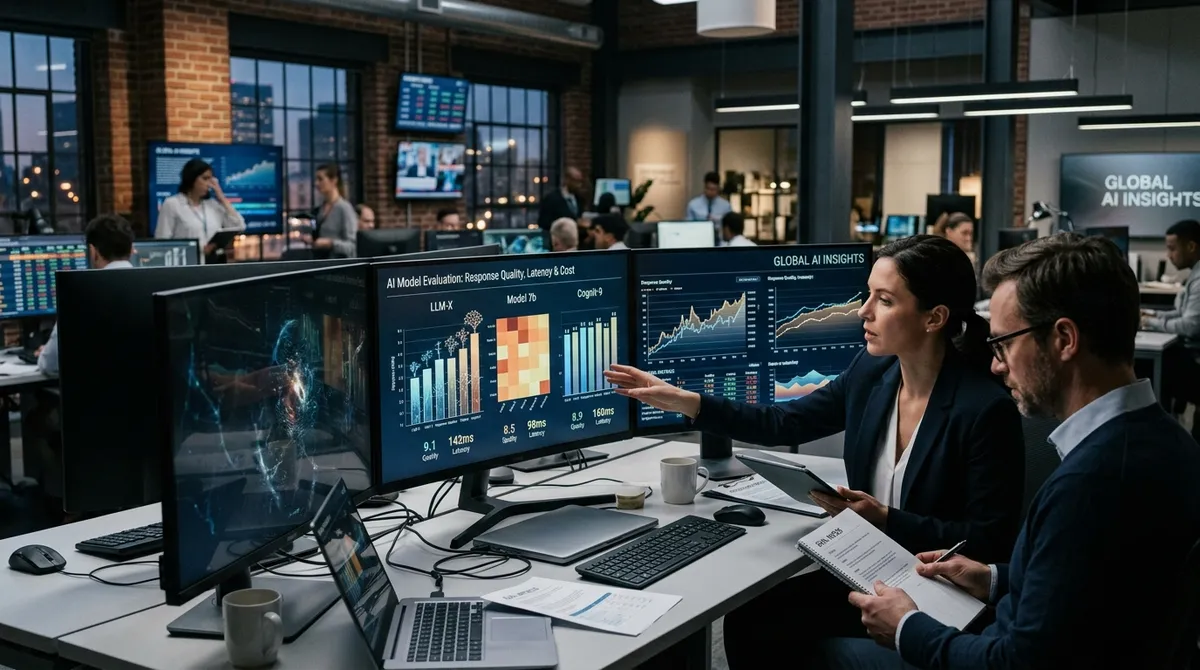
Flag Soft : le benchmark « Épreuve de Dalí » a aidé à choisir un LLM selon la qualité, la vitesse et le prix
Le benchmark « Épreuve de Dalí » compare des LLM selon trois critères décisifs pour les intégrer à un produit : qualité des réponses, vitesse et coût final.
Habr AI : plutôt que des pipelines d'agents complexes, on conseille aux développeurs markdown, git et mémoire de sessions
Un manifeste publié sur Habr s'attaque aux pipelines d'agents surchargés : selon son auteur, sessions, rôles, règles et git comptent plus que LangChain et les bases vectorielles.
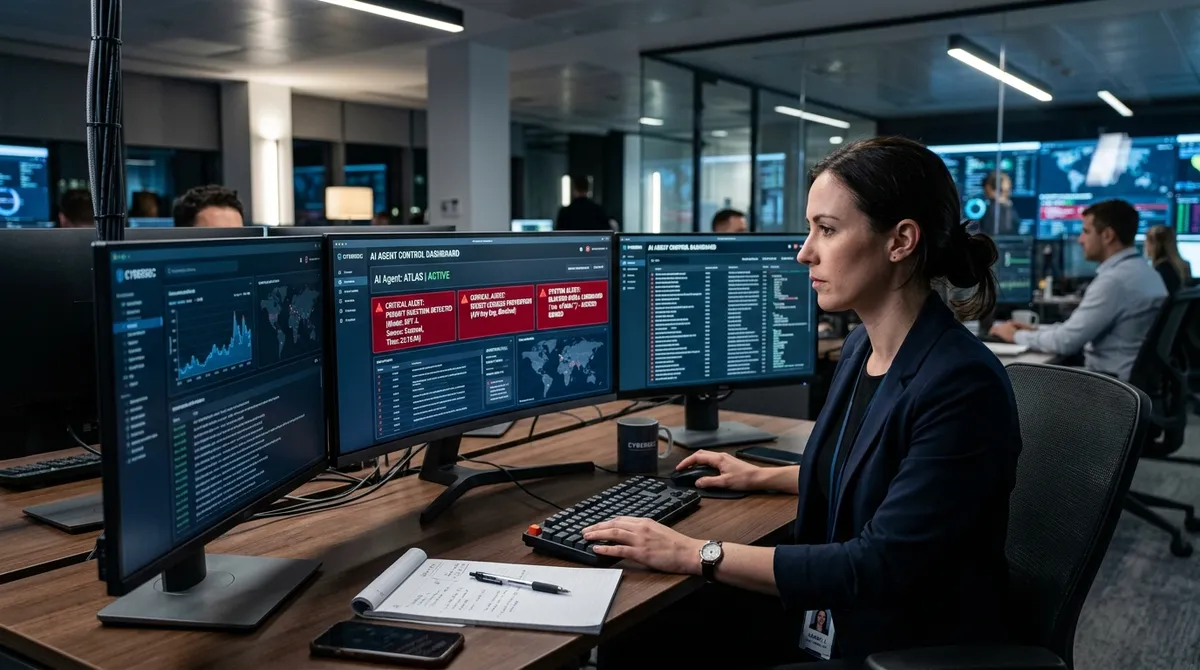
Le plugin opencode-policy ajoute 309 règles pour protéger les agents IA contre les injections et les fuites
Pour opencode, un filtre déterministe de 309 règles regex intercepte les prompt injections et les appels d'outils dangereux avant qu'ils n'atteignent le shell, les fichiers ou les secrets.
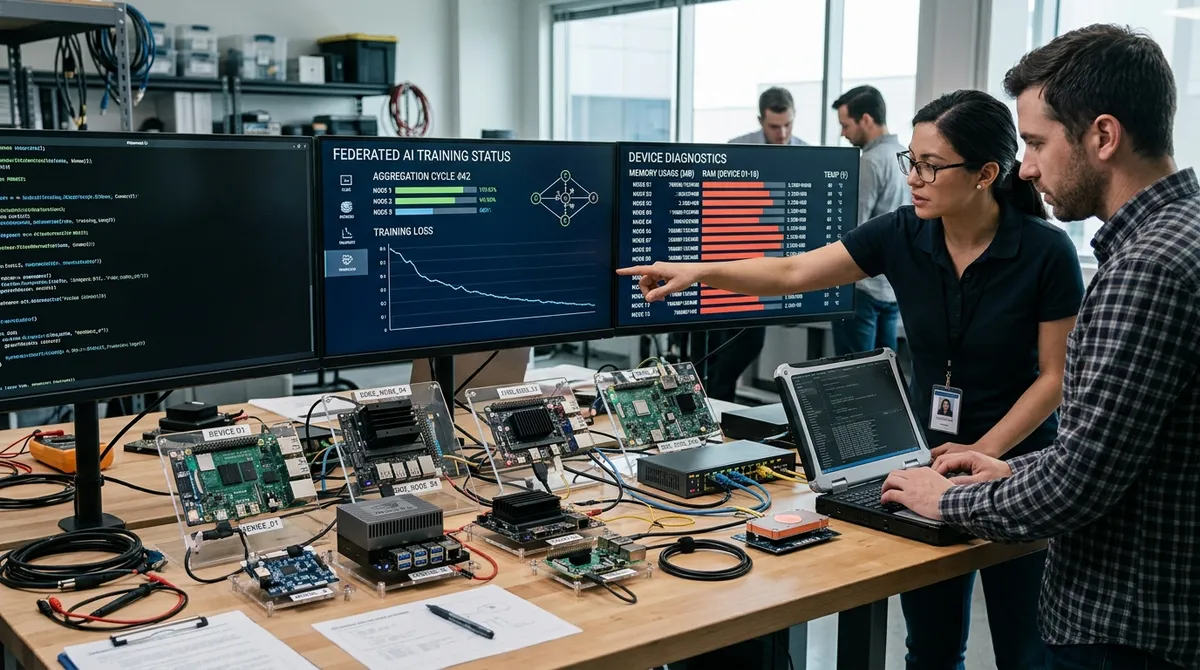
Un ingénieur d'Eltex explique comment faire tourner l'apprentissage fédéré sur des appareils edge dotés de 256 Mo de mémoire
Un ingénieur d'Eltex, à partir d'une intervention à l'AiConf, détaille comment appliquer l'apprentissage fédéré sur des appareils edge disposant de moins de 256 Mo de RAM, où la mémoire est la principale contrainte.