Google et OpenAI se heurtent à une limite : que se passe-t-il quand le web manque de texte humain ?
L'IA générative est tombée dans une étrange dépendance : les modèles ont besoin de textes humains, mais réduisent eux-mêmes l'incitation à en produire. Les résumés d'IA dans la recherche font chuter les clics vers les sites, tandis que le web se remplit toujours plus vite de contenus générés par des machines. Si ce cycle s'installe, les développeurs disposeront de moins de données de qualité pour l'entraînement, et les réponses des nouveaux modèles pourraient se dégrader nettement.
Traité par IA depuis Habr AI ; édité par Hamidun News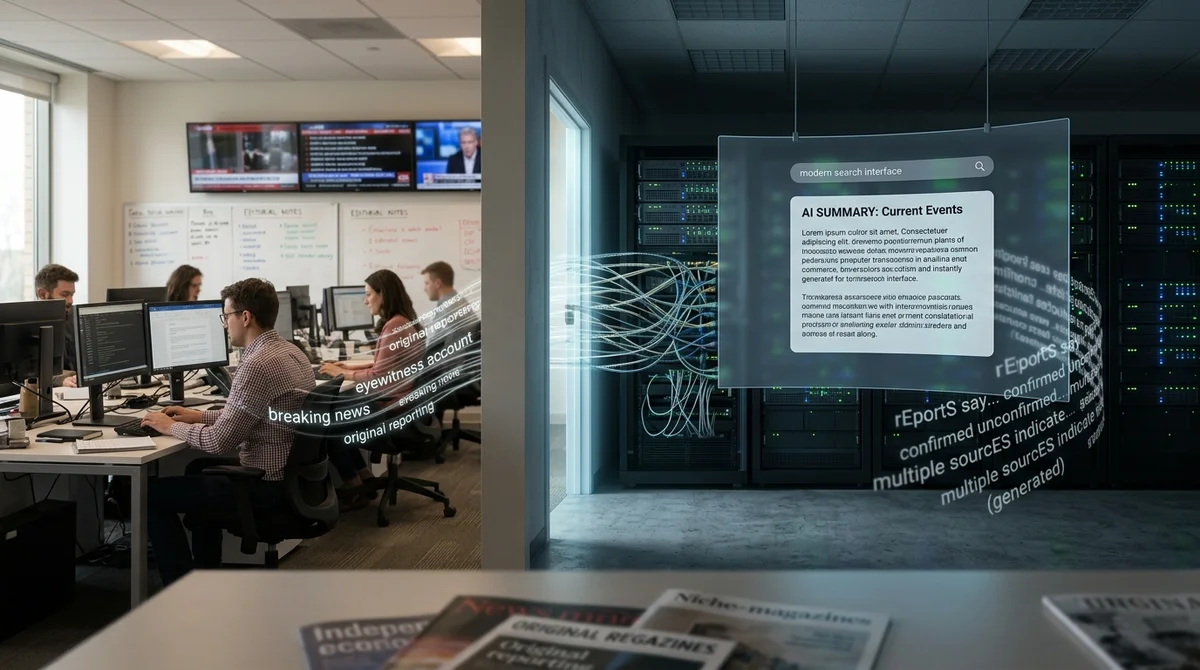
La principale faiblesse de l'IA générative tient à ceci : elle vit du texte humain tout en détruisant les conditions dans lesquelles ce texte est produit. Moteurs de recherche, chatbots et résumés d'IA promettent à l'utilisateur une réponse rapide sans passer par un site, et ce faisant ils réduisent les revenus de ceux qui produisent le contenu d'origine. À court terme, les modèles y gagnent en confort d'usage. À long terme, ils risquent de se retrouver sans base d'entraînement de qualité et de se mettre à apprendre de leurs propres reflets.
Le premier problème est l'économie de la publication. Depuis le lancement de Google AI Overviews en mai 2024, la recherche répond de plus en plus directement dans la page de résultats, sans renvoyer le lecteur vers la source. Selon des données de Chartbeat publiées par Axios le 17 mars 2026, les petits sites, qui totalisent de 1 à 10 mille pages vues par jour, ont perdu environ 60% de leurs visites issues de la recherche en deux ans.
Les sites de taille moyenne ont reculé de 47%, les grands de 22%. Une étude du Pew Research Center du 22 juillet 2025 a montré un effet comparable sur le comportement des utilisateurs : lorsque les résultats comportent un résumé d'IA, les gens cliquent nettement moins sur les liens classiques. Pour les médias, les forums, les blogs de niche et les auteurs indépendants, il ne s'agit pas d'une métrique abstraite, mais d'un coup direct porté à la publicité, aux abonnements et à l'envie de continuer à écrire.
Le second problème, ce sont les données elles-mêmes. Les grands modèles de langage se sont d'abord nourris d'immenses volumes de texte issus d'internet. Pour les premiers systèmes, comme GPT-3, l'essentiel du corpus d'entraînement provenait du web et de sources associées. Mais la quantité de contenu humain de qualité n'est pas infinie. En juin 2024, des chercheurs d'Epoch AI ont estimé que, au rythme de mise à l'échelle d'alors, l'industrie pourrait atteindre la limite du texte public utilisable pour l'entraînement quelque part entre 2026 et 2032. C'est pourquoi les plus grands acteurs ont commencé à signer des accords avec Reddit, des éditeurs et d'autres détenteurs de vastes archives : l'accès aux données est passé du détail technique à l'actif stratégique.
Dans ce contexte, la tentation de se tourner vers les données synthétiques paraît presque inévitable. Si le texte réel manque, il semble logique de demander à un modèle de générer de la matière pour le suivant. Le hic, c'est que ce schéma dégrade progressivement la qualité.
Une étude publiée dans Nature le 25 juillet 2024 décrit l'effet d'effondrement des modèles (model collapse) : lors d'un entraînement récursif sur des données générées par des machines, les modèles perdent les faits rares, lissent les motifs complexes et amplifient les erreurs et les biais existants. C'est comme photocopier encore et encore la même page : le sens général reste visible, mais les détails s'estompent à chaque itération. OpenAI lui-même a reconnu publiquement que les données synthétiques peuvent aider ponctuellement, mais ne semblent pas remplacer pleinement un corpus humain varié.
Un autre piège existe : séparer le texte humain du texte machine est en pratique bien plus difficile qu'il n'y paraît. Les détecteurs de contenu généré par IA se trompent encore, surtout sur les textes courts, retouchés ou au style neutre. Certaines études ont montré un taux élevé de faux positifs sur des textes de personnes dont l'anglais n'est pas la langue maternelle.
L'industrie aura donc du mal à simplement « nettoyer internet » pour ne garder que des données humaines fiables. De plus, des évaluations académiques récentes constatent déjà que la part d'assistance par IA dans les nouvelles publications augmente vite et que le contenu en ligne devient plus uniforme sur le fond et plus aseptisé sur le ton. Autrement dit, le problème ne tient pas seulement à la quantité de texte, mais aussi à sa diversité.
Si ce cycle n'est pas brisé, internet fonctionnera moins bien pour tous les acteurs. Les auteurs publieront moins souvent des contenus approfondis, car ils sont de plus en plus difficiles à monétiser. Les plateformes continueront de remplir les résultats de résumés d'IA brefs, épargnant un clic à l'utilisateur mais appauvrissant l'écosystème des sources. Et les développeurs de modèles obtiendront de plus en plus de contenu de seconde main, qui sonne juste mais apporte moins de connaissances nouvelles.
La sortie semble résider non dans toujours plus de génération, mais dans le maintien des incitations à l'écriture humaine : paiement de licences, attribution transparente, usage plus prudent des résumés d'IA et priorité à la qualité des données plutôt qu'à la simple échelle. Sans cela, l'IA finira bel et bien prise au piège qu'elle s'est elle-même tendu.
- 2 nov. 2026TJ Digital : une réponse directe ouvre 23% des pages citées par l'IA, contre 14% des pages non citées
- 2 nov. 2026Arca confie à des agents IA des tâches financières pouvant durer jusqu'à 10 jours, mais laisse les transactions aux humains
- 2 nov. 2026L'assistant Muse de Meta tient un dossier sur vos proches et obtient root par défaut sous Ubuntu
- 1 nov. 2026Les modèles locaux battus par Opus et Codex : 0,21 sur MacBook contre 1,00 pour Codex
Ship AI Faster with Founders, Engineers & Weekly Architecture Reviews
Inside Vibe Club (hamidun.com/club) — weekly live masterminds with Zhemal Khamidun, Tech Radar, full LMS access, and 370+ production Claude Code skills.
L'essentiel de l'IA — une fois par semaine
Sept actus qui ont vraiment compté, choisies à la main. Sans bruit ni communiqués.
C'est fait ! Vérifiez votre boîte mail pour la confirmation.