Un ingénieur d'Eltex explique comment faire tourner l'apprentissage fédéré sur des appareils edge dotés de 256 Mo de mémoire
L'ingénieur d'Eltex Alexander Loshkarev a publié un article sur l'apprentissage fédéré sur des appareils edge disposant de moins de 256 Mo de mémoire vive. Il ne s'agit pas de théorie du FL, mais de son aspect pratique : comment faire tenir le modèle, l'entraînement local et l'échange de mises à jour dans un profil de ressources très restreint. La première partie pose clairement le cadre du problème pour les équipes embarquées et ML.
Traité par IA depuis Habr AI ; édité par Hamidun News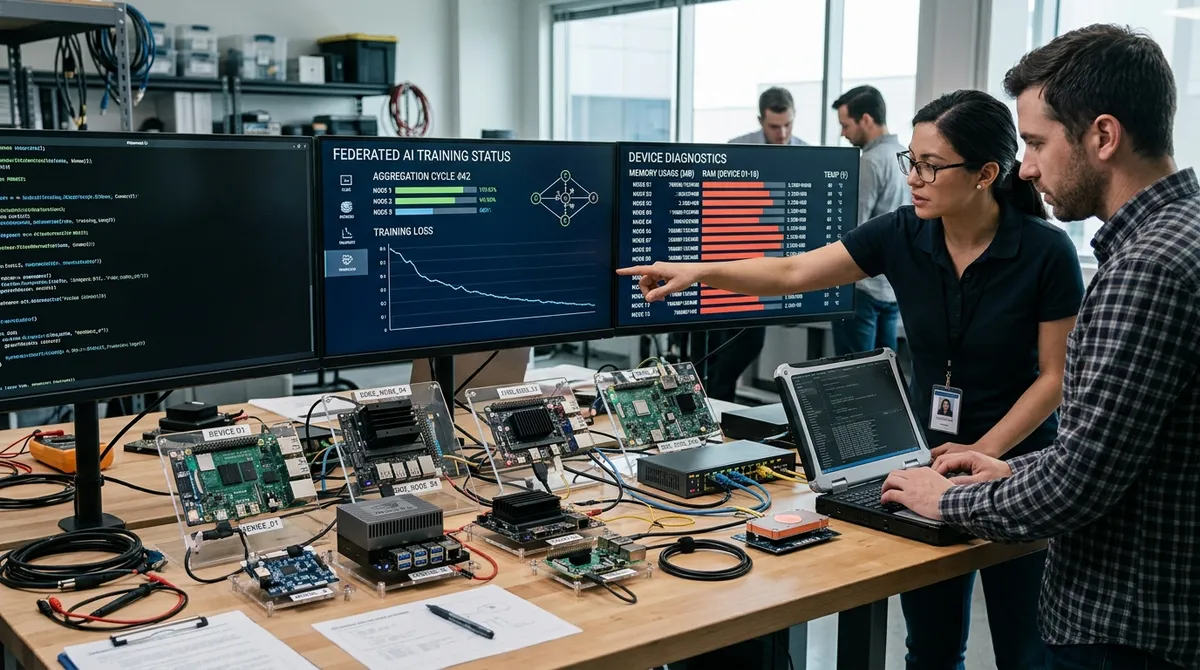
L'apprentissage fédéré est généralement évoqué à propos des smartphones, des voitures et des grands réseaux IoT, mais en pratique, le principal obstacle est souvent bien plus prosaïque : l'appareil manque tout simplement de mémoire. C'est l'angle de l'article de l'ingénieur d'Eltex Alexander Loshkarev, rédigé à partir de son intervention à l'AiConf.
Le sujet semble étroit, mais il concerne en réalité presque tout projet qui doit faire passer le ML du cloud à la périphérie du réseau et le faire fonctionner sur du matériel aux ressources très modestes. Il s'agit de scénarios où l'appareil edge dispose de moins de 256 Mo de mémoire vive. Pour les équipes serveurs, cela ressemble à une limite presque extrême, mais pour l'électronique industrielle, les passerelles, les équipements télécoms, les systèmes embarqués et les contrôleurs spécialisés, cette configuration est tout à fait réaliste.
Dans ces conditions, la tâche ne se résume plus à prendre un modèle prêt à l'emploi et à le charger en mémoire. Il faut faire tenir en même temps le modèle lui-même, les données, les tampons, les processus système et la logique d'échange des mises à jour, sans perdre en stabilité sur l'appareil.
Dans ce contexte, l'apprentissage fédéré est intéressant car il permet d'entraîner ou d'affiner des modèles sans transfert centralisé des données brutes. Les calculs sont exécutés localement, et seuls les paramètres ou leurs variations sont envoyés à l'extérieur. Cette approche aide à mieux contrôler la confidentialité, réduit la dépendance à une liaison réseau permanente et rend les scénarios edge plus viables. Mais elle a un revers : le client FL local exige lui-même de la mémoire, du calcul et un pipeline soigneusement organisé. Plus l'appareil est faible, plus il faut économiser chaque mégaoctet.
D'après la description de la première partie, l'article traite justement du versant ingénierie de ce problème, et non de la théorie abstraite. Pour les équipes qui déploient du ML en périphérie, c'est le point le plus douloureux : un modèle peut être précis en laboratoire mais inutilisable en production s'il ne tient pas en mémoire ou s'il dégrade les autres services. Sur ces appareils, ce n'est pas seulement la taille des poids qui compte, mais aussi les pics temporaires de consommation mémoire pendant l'inférence, la préparation des batchs, la sérialisation des mises à jour et les échanges réseau. Même si un modèle paraît compact en statique, son comportement à l'exécution peut rendre le déploiement impossible.
En ce sens, la formulation sur un appareil pour lequel 1 Go sonne comme un luxe décrit assez justement l'écart entre la pile ML classique et le monde embarqué réel. De nombreux outils et pratiques courants côté serveur cessent de fonctionner ici sans adaptation. On ne peut pas augmenter indéfiniment la taille de batch, conserver des copies superflues de tenseurs ni compter sur une large marge de mémoire système. Toute erreur d'estimation du profil de ressources se traduit vite par des redémarrages, des blocages ou l'abandon de la fonction pour laquelle le modèle avait été déployé.
Il est aussi important de noter qu'il ne s'agit pas seulement d'exécuter de l'inférence sur un petit appareil, mais bien d'apprentissage fédéré. C'est un mode plus complexe : le système doit recevoir périodiquement le modèle global, exécuter localement des étapes d'entraînement, stocker des états intermédiaires et renvoyer le résultat. Quand la mémoire est comptée, il faut revoir littéralement tout : la taille du modèle, le format de représentation des données, la fréquence de synchronisation, la durée des sessions locales et parfois l'architecture même du client.
L'annonce montre que l'auteur pose la bonne question : avant de discuter de la qualité du modèle, il faut déterminer s'il est possible de le faire fonctionner sur du matériel edge réel sans incidents ni compromis permanents sur la fiabilité.
C'est un signal important pour le marché. L'intérêt pour l'IA en périphérie de réseau grandit, mais le déploiement réel se heurte non pas à de belles démos, mais aux limites de mémoire, d'énergie et de robustesse. Ces contenus sont donc utiles non seulement aux ingénieurs ML, mais aussi aux équipes backend, embarqué et produit : ils ramènent la discussion du niveau des promesses à celui de l'ingénierie système.
Si la première partie pose le cadre du problème, la conclusion principale est déjà claire : en ML edge, ce n'est pas le modèle le plus à la mode qui l'emporte, mais celui que l'appareil est réellement capable de supporter.
Ship AI Faster with Founders, Engineers & Weekly Architecture Reviews
Inside Vibe Club (hamidun.com/club) — weekly live masterminds with Zhemal Khamidun, Tech Radar, full LMS access, and 370+ production Claude Code skills.
L'essentiel de l'IA — une fois par semaine
Sept actus qui ont vraiment compté, choisies à la main. Sans bruit ni communiqués.
C'est fait ! Vérifiez votre boîte mail pour la confirmation.