Habr AI explique comment la recherche de solutions pilotée par les données change l'architecture client-serveur
Les systèmes experts à recherche data-driven exigent plus qu'une base de connaissances : ils demandent un dialogue stable avec l'utilisateur à chaque étape. Une nouvelle analyse montre ce qui distingue l'exécution locale, le travail sur réseau local et l'accès via internet, les limites de chaque modèle et pourquoi l'architecture doit se choisir selon le scénario d'usage, pas selon la mode. L'approche ne fonctionne que si le système sait guider l'utilisateur en continu à travers une chaîne de précisions. L'architecture pèse donc autant que la base de connaissances elle-même. La conclusion principale : pour la recherche data-driven, l'architecture n'est pas une enveloppe autour de l'algorithme, mais une partie du produit lui-même.
Traité par IA depuis Habr AI ; édité par Hamidun News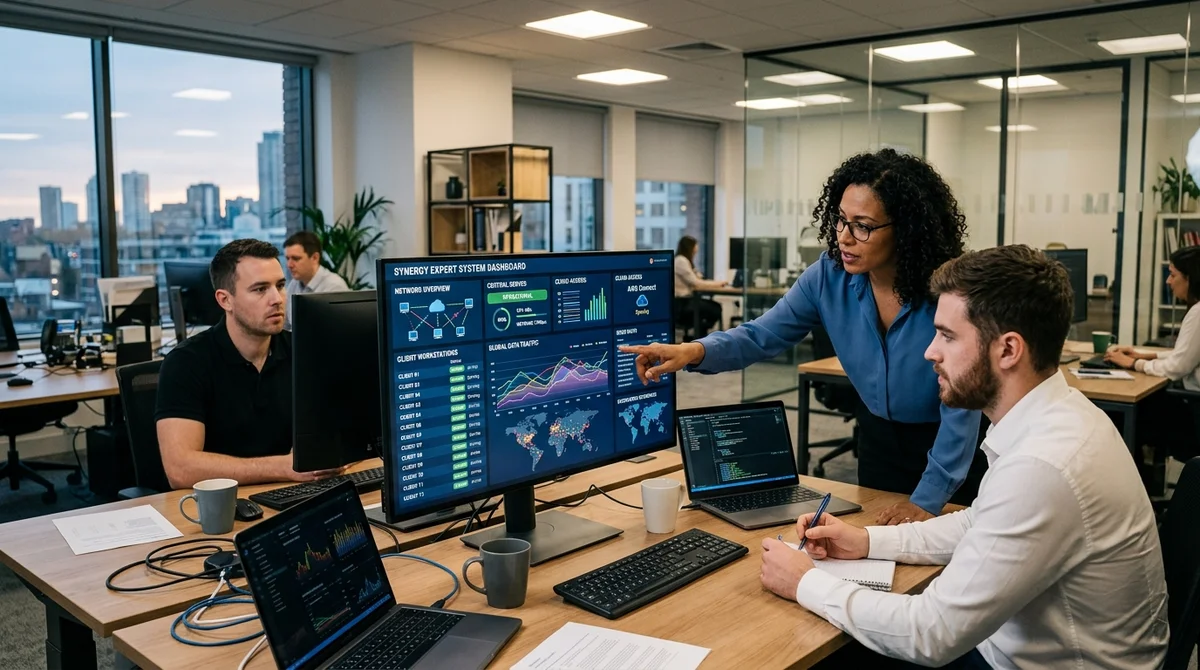
La recherche de solutions pilotée par les données ne fonctionne que si le système sait guider l'utilisateur en continu à travers une chaîne de précisions. L'architecture compte donc ici autant que la base de connaissances elle-même. L'enjeu n'est pas l'interface en tant que telle, mais la manière d'organiser un dialogue vivant entre l'humain et le système expert lorsqu'il doit servir plusieurs postes de travail à la fois sans perdre la cohérence des données.
L'intérêt de l'approche data-driven est que le système ne se contente pas de renvoyer une réponse préparée à l'avance pour une seule requête. Il confronte les données d'entrée, pose des questions de précision, vérifie les contraintes et réduit peu à peu l'éventail des options. La qualité du résultat dépend donc non seulement des règles de la base de connaissances, mais aussi de la fiabilité de la transmission des réponses de l'utilisateur, de la rapidité de réaction du système et de sa capacité à poursuivre le dialogue sans perdre le contexte lorsque plusieurs personnes ou plusieurs appareils interviennent.
L'analyse de Habr AI s'appuie sur trois modèles d'interaction de base : l'exécution locale sur un seul ordinateur, le fonctionnement au sein d'un réseau local et l'accès via internet. À première vue, les différences peuvent sembler techniques, mais en pratique elles modifient le scénario d'usage lui-même.
Si le système expert est installé en local, il est plus simple à déployer, ne dépend pas du réseau et convient aux environnements isolés. Ce schéma est pratique pour les pilotes, les tâches professionnelles pointues et les situations où l'autonomie et la prévisibilité comptent. Mais ses limites apparaissent vite : les mises à jour divergent d'un poste à l'autre, l'historique de travail s'éparpille et la base de connaissances unique devient un ensemble de copies.
Le réseau local apporte le niveau de maturité suivant. Lorsque plusieurs utilisateurs se connectent à une base de connaissances commune et à un même moteur de recherche de solutions, le système fonctionne comme un outil d'entreprise plutôt que comme un programme isolé. Il est plus facile de contrôler les versions, d'administrer les changements et d'imposer des règles de décision uniformes. De nouvelles exigences apparaissent toutefois : il faut penser au travail concurrent, à la séparation des droits d'accès, à l'enregistrement des sessions utilisateur, à la journalisation des actions et à la robustesse du serveur. Sinon, même une bonne logique de recommandation se heurte vite à des défaillances organisationnelles.
L'accès web via internet rend le système encore plus souple, car des filiales, des spécialistes distants, des partenaires et des utilisateurs mobiles peuvent s'y connecter. Mais c'est précisément là qu'on voit le mieux que le débat sur l'architecture ne se réduit pas au choix d'une stack à la mode. Ce qui compte, ce ne sont pas seulement les pages, les API ou le transport des messages, mais l'endroit où l'état du dialogue est stocké, la manière dont la session est rétablie après une coupure de connexion, la protection des données sensibles et la rapidité du retour fait à l'utilisateur à chaque étape.
Pour les systèmes où la recherche d'une solution se déroule en série de précisions, les latences, la perte de contexte ou la divergence des versions peuvent être plus critiques que pour un simple référentiel de consultation.
Il faut aussi souligner que le texte évite volontairement les détails d'une implémentation précise. Il n'y est question ni de REST ou de SPA, ni de long polling ou de WebSocket, ni de server-side session ou d'event sourcing. C'est une force de l'approche : définir d'abord le modèle d'interaction entre l'utilisateur et le système expert, puis choisir seulement les outils de développement. Sinon, l'équipe risque de commencer par les technologies sans répondre à une question plus importante : où doit vivre exactement la logique de décision, comment la base de connaissances passera à l'échelle et qui garantit l'intégrité de l'expérience utilisateur quand plusieurs clients travaillent simultanément.
La conclusion principale est simple : pour la recherche data-driven, l'architecture n'est pas une enveloppe posée sur un algorithme, mais une partie du produit lui-même. Le choix entre modèle local, réseau et web détermine la vitesse de déploiement, le coût de maintenance, le contrôle des versions, la sécurité et le confort de l'utilisateur. Plus tôt on en tient compte dans la conception du système expert, moins on risque de devoir reconstruire de zéro un prototype réussi lorsqu'il deviendra un outil pour une équipe, un service ou toute l'entreprise.
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
L'essentiel de l'IA — une fois par semaine
Sept actus qui ont vraiment compté, choisies à la main. Sans bruit ni communiqués.
C'est fait ! Vérifiez votre boîte mail pour la confirmation.