Pourquoi les modèles de diffusion laissent des coutures sur les photos de 40 mégapixels et comment donner une mémoire aux tuiles
Les modèles de diffusion se débrouillent bien avec les images ordinaires, mais sur des clichés professionnels de 40 à 150 Mpx, le tiling laisse presque inévitablement des coutures, une couleur qui flotte et des textures rompues. L'article explique pourquoi les modèles photo ne savent pas garder de mémoire entre tuiles voisines, et quelles idées de la diffusion vidéo, de FramePack à AnimateDiff, pourraient aider à corriger cela. Selon l'auteur, la limite ne tient pas seulement au matériel ou à la taille de l'image, mais à l'architecture même de la diffusion photo.
Traité par IA depuis Habr AI ; édité par Hamidun News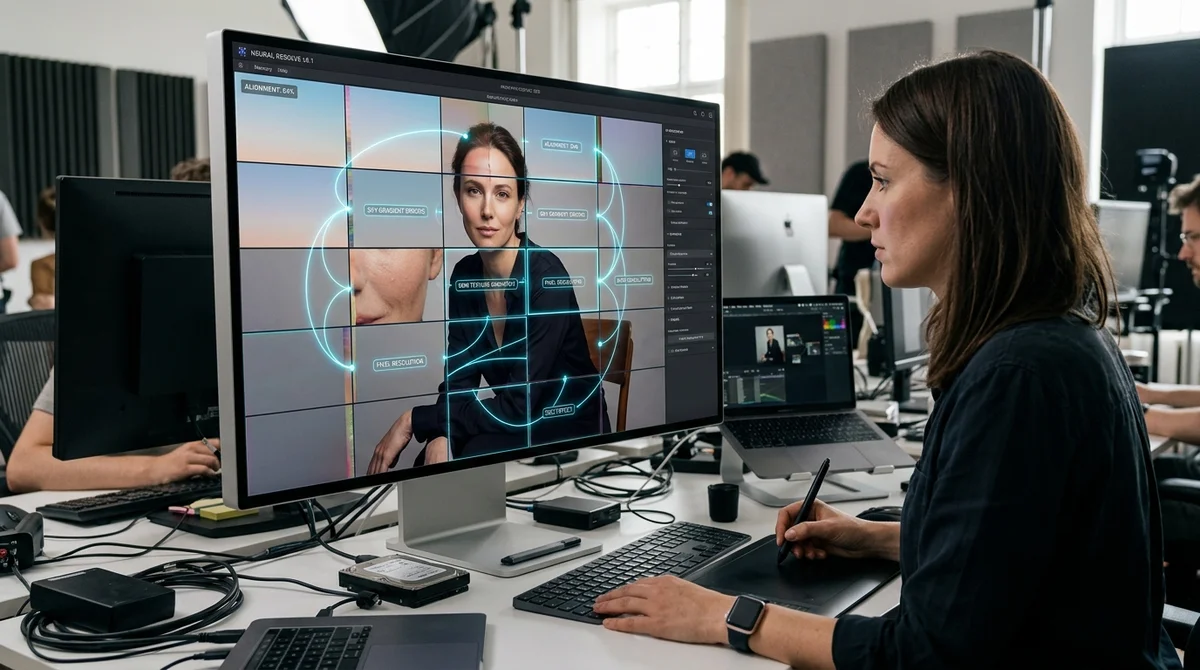
La cause principale des coutures sur les images géantes n'est pas un mauvais assemblage, ni seulement un manque de mémoire vidéo. Le problème est plus profond : les modèles de diffusion photo ne conservent pas de mémoire entre des fragments voisins de l'image. Quand un cliché de 40 à 150 mégapixels est découpé en dizaines ou en centaines de tuiles, le modèle prend chaque décision de zéro. Il ignore quelle teinte de ciel, quel ton de peau ou quelle échelle de texture il a déjà choisis juste à côté. C'est ce qui produit des marches dans les dégradés, une couleur qui flotte et des raccords visibles, particulièrement gênants en retouche professionnelle.
L'auteur aborde le sujet par la pratique, non par la théorie : vingt ans de retouche derrière lui, et quatre ans passés à tenter d'adapter les modèles de diffusion à la production. En photo de studio, de publicité et de magazine, la haute résolution n'est pas un luxe mais un standard de travail, et ces clichés tiennent rarement en une seule passe de génération ou d'édition. L'industrie en revient donc toujours à la même astuce : diviser l'image en 100 fragments ou plus, les traiter séparément, puis les réassembler. Sur les petits détails, cela peut passer, mais sur la peau, les tissus, les fonds et les transitions de lumière, les artefacts sont presque inévitables.
La racine du problème est que le tiling classique préserve le détail local mais brise la cohérence globale. Chaque tuile ne voit que son morceau de scène et ne sait pas ce qui se passe à gauche, à droite, au-dessus et en dessous. Même quand les zones voisines se recouvrent, le modèle peut légèrement décaler la balance des couleurs, interpréter le grain autrement, ajouter des pores qui ne correspondent pas ou construire un autre rythme de texture.
Le blending et les masques cachent une partie des défauts sans en supprimer la cause : le modèle photo n'a aucun mécanisme qui relie les décisions entre voisines. C'est pourquoi un assemblage parfait sur de très grands clichés reste plus une exception qu'une norme.
L'article propose de regarder du côté de la diffusion vidéo, où la cohérence est depuis longtemps au cœur de l'architecture. Un modèle vidéo doit se souvenir de l'aspect d'un objet dans l'image précédente pour ne perdre ni le visage, ni la lumière, ni la texture, ni la position des détails pendant le mouvement. L'auteur passe en revue huit classes de cette mémoire, de BCLA dans SANA-Video et FramePack à SVD reshape, AnimateDiff et d'autres approches, et évalue ce qui peut être transposé aux tuiles et ce qui ne le peut pas.
La question clé n'est pas le nom de la méthode mais le principe : peut-on faire en sorte qu'un modèle photo transmette au fragment voisin un contexte compact, un état caché ou une structure de scène commune, pour que les décisions ne soient pas prises dans le vide ?
Trois grandes idées pratiques en découlent. La première est l'échange de contexte entre tuiles voisines : le modèle reçoit non seulement le fragment courant, mais aussi des informations compressées sur les zones déjà traitées. La deuxième est une mémoire partagée au niveau des latents ou des mécanismes d'attention, qui maintient une couleur, un éclairage et un caractère de surface uniformes sur toute l'image.
La troisième est un schéma en plusieurs étapes, où l'on construit d'abord une représentation globale grossière de toute la scène, puis où les tuiles locales ne font qu'affiner les détails, sans briser l'ensemble. Pour l'impression, l'affichage extérieur, la retouche beauté et la photo commerciale, c'est crucial : toute rupture de texture ou tout saut de ton y saute immédiatement aux yeux.
La conclusion principale est simple : la limite ne tient pas seulement au matériel ni seulement à la taille de l'image, mais à l'architecture même de la diffusion photo. Tant que le modèle n'aura pas appris à se souvenir de ce qui s'est passé à côté, le traitement de clichés de 40 mégapixels et plus restera un compromis entre détail et intégrité. Si les mécanismes de mémoire de la vidéo parviennent à être adaptés aux tuiles, les modèles de diffusion feront un pas notable des démos spectaculaires vers un véritable outil professionnel de retouche et de post-production.
- 12 nov. 2026MiniMax ouvre les poids de H3-Image : images 4K en 10–16 secondes et 16 références
- 9 févr. 2026Modèles de diffusion : analyse approfondie et perspectives d'évolution
- 23 avr. 2026Richard Tice, de Reform UK, a publié une photo aux signes de manipulation par IA, selon des experts
- 31 janv. 2026La Lune venue d'un réseau de neurones : pourquoi votre smartphone ne sait plus prendre de photos
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
L'essentiel de l'IA — une fois par semaine
Sept actus qui ont vraiment compté, choisies à la main. Sans bruit ni communiqués.
C'est fait ! Vérifiez votre boîte mail pour la confirmation.