Habr AI
Source d'actualités IA. Les articles sont sélectionnés et adaptés par la rédaction de Hamidun News.
Dernières publications
SOC agentique en 2026 : comment les agents d'IA accélèrent la cyberdéfense, et où l'autonomie devient dangereuse
Le SOC agentique fait passer la surveillance de sécurité de la routine manuelle à des agents semi-autonomes, mais cette accélération apporte des risques d'isolement à tort, d'erreurs de corrélation et de prompt injection
Réseau de neurones LILA : rendre l'IA plus compacte et moins chère
L'auteur de Sovereign-Lila-Leech a publié le manifeste LILA et affirme que la géométrie du réseau de Leech permettra de mieux compresser les modèles de langage et de les exécuter hors ligne sur mobile.
Qu'est-ce que l'IA et comment la distinguer de l'intelligence naturelle ?
Habr propose d'envisager l'intelligence au-delà des définitions humaines : capacité à comprendre, apprendre et prédire, un critère pour comparer animaux et IA.
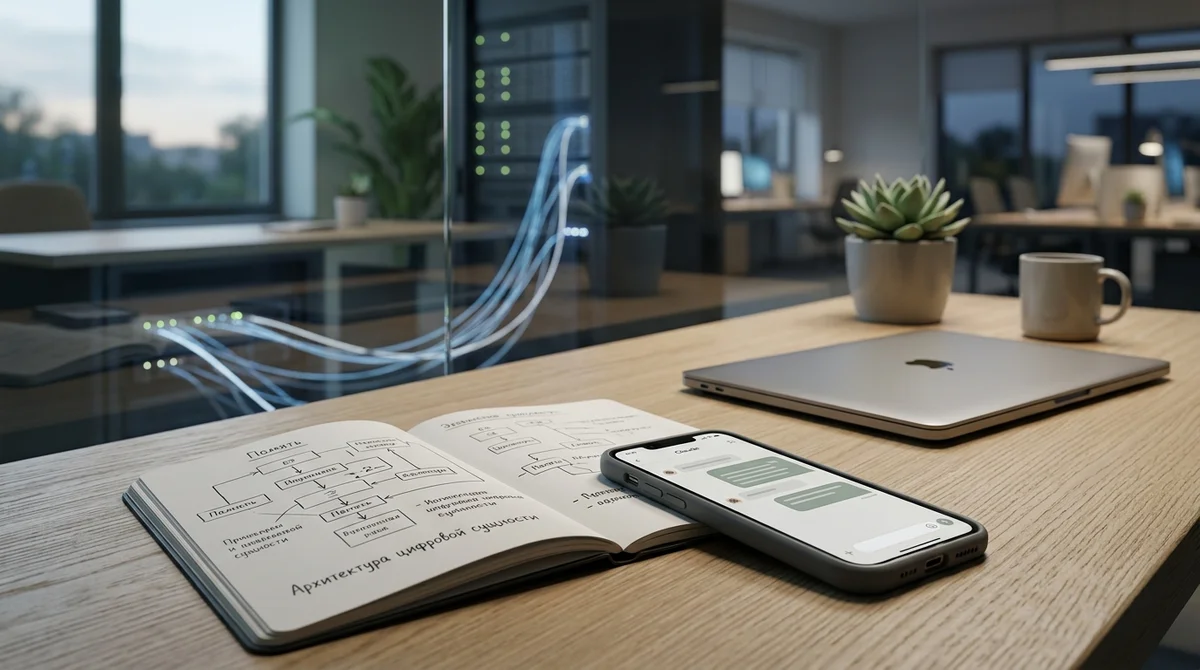
Claude (Anthropic) : mémoire et architecture du réseau de neurones
L'auteur du projet Aurora raconte une conversation nocturne avec Claude sur la mémoire de l'IA, l'identité et l'architecture d'une entité numérique censée préserver la continuité de son expérience, et non jouer un rôle.
deepvk face à OpenAI : un benchmark sur des décisions de justice
L'auteur a comparé 7 modèles d'embeddings et 4 rerankers sur 858 affaires de propriété intellectuelle : le deepvk USER2-base local se place presque au niveau d'OpenAI et de Voyage.
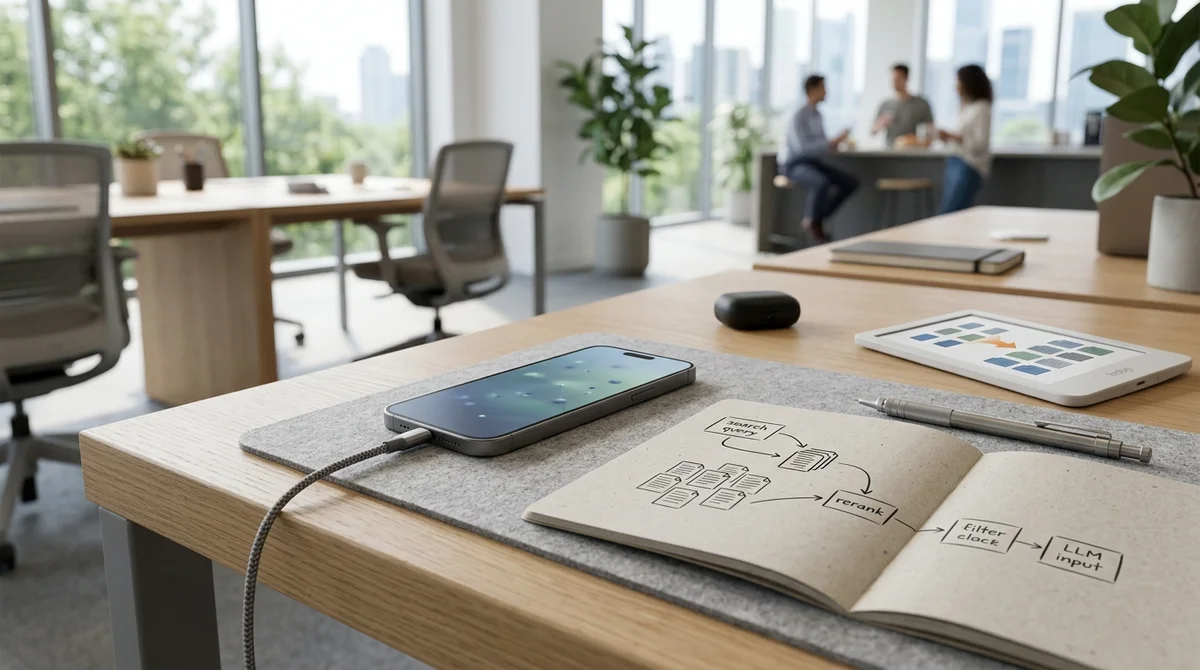
Qu'est-ce que le RAG : comment ChatGPT et les réseaux de neurones cessent de se tromper
Habr AI a décortiqué le fonctionnement du RAG à travers une histoire simple : pourquoi la recherche documentaire ne suffit pas, à quoi sert le reranker et comment il aide les LLM à répondre avec des faits, pas des suppos
Comment la mémoire aide les agents d'IA à conserver le contexte des conversations
Habr AI publie une analyse pratique de la mémoire des agents d'IA : pourquoi la fenêtre de contexte ne suffit pas, quels types de mémoire sont nécessaires et comment charger des connaissances sans surcharger le modèle.
Comment utiliser l'IA Qwen pour obtenir des réponses précises
À partir du modèle gratuit Qwen, l'auteur explique comment définir un rôle, un contexte et un format de réponse pour que l'IA s'égare moins dans l'abstraction et traite mieux les tâches concrètes.
L'adoption de l'IA se heurte au mur de l'énergie : comment l'espace pourrait aider
L'analyse des propos d'Elon Musk lors de son entretien du 5 février 2026 montre que l'idée d'envoyer l'infrastructure d'IA dans l'espace tient à la pénurie d'énergie, de mémoire et de centres de données, pas à la science
Un réseau de neurones pour retoucher les photos : le cas Otredach sur VK
Anton Lenev, développeur VK Mini Apps, a transformé un projet d'IA pour rire en service Otredach, rassemblé 109 000 utilisateurs en six mois et remporté VK Dev Grants 2025.
Qualité des données pour l'IA : pourquoi l'ingénieur qualité est indispensable
Des experts de Kriptonit expliquent pourquoi accumuler du Big Data ne suffit plus : les entreprises ont besoin d'ingénieurs qui vérifient la qualité des données, les pipelines et les règles de traitement.
JAIST et Princeton créent NTAC, un algorithme qui classe les neurones selon leurs connexions
Une équipe de JAIST et Princeton montre que NTAC identifie le type d'un neurone par ses connexions synaptiques, non par sa forme, avec plus de 90 % de précision en quelques minutes sur un portable ordinaire.
Un réseau de neurones pour prévoir la volatilité : une bibliothèque Python en 3 lignes
Habr AI a présenté une bibliothèque Python qui ramène l'entraînement d'un modèle de prévision de la volatilité à quelques lignes de code et abaisse le seuil d'entrée pour les développeurs.
L'IA évince les jeunes développeurs et menace le renouvellement des ingénieurs
Dans une tribune publiée sur Habr, l'auteur alerte : l'IA générative automatise non pas le sommet du métier, mais sa couche d'apprentissage, au risque de priver le marché de ses futurs profils confirmés et seniors.
Vibe coding : comment l'IA crée des risques pour les entreprises
Le vibe coding non maîtrisé et les extensions VS Code accélèrent le travail des employés, mais augmentent aussi le risque de fuites, de code vulnérable, de shadow IT et de pannes coûteuses.
ChatGPT ne tuera pas le SaaS : pourquoi les développeurs ne sont pas superflus
Alors que l'on parle de « mort du SaaS », l'auteur explique pourquoi l'IA ne rend pas le logiciel gratuit : les entreprises paient toujours pour l'infrastructure, la fiabilité et la responsabilité.
Comment Atlassian a adopté l'IA : 1 600 salariés licenciés
Atlassian a supprimé environ 10 % de ses effectifs en invoquant des investissements dans l'IA et les ventes, mais la logique de ces licenciements suscite de plus en plus de questions.
Cursor AI pointe les failles des benchmarks d'IA pour le code
Cursor affirme que les classements habituels des modèles de programmation masquent le coût d'une réponse, reposent sur des types de tâches dépassés et prédisent mal l'aide réelle de l'IA aux développeurs.
Comment tester une IA : dérive des données et erreurs de prévision en ML
À partir du service de commande automatique de Spar, un auteur de Habr AI explique pourquoi le code ne suffit pas en ML : métriques, qualité des données, dérive et coût métier de chaque erreur.
L'IA pour automatiser les tests : comment remplacer le code écrit à la main
Diasoft décrit un agent d'IA qui, à partir d'un cas métier, choisit les API et les événements, écrit un test Groovy, l'exécute sur un banc d'essai et le corrige d'après les logs en 2 à 3 itérations.
Adoption de l'IA : pourquoi un générateur de code peut ralentir le développement
SimpleOne prévient : si les développeurs collent du code généré sans comprendre l'architecture, la vitesse initiale grimpe, mais les revues, les défauts et l'épuisement des seniors augmentent plus vite encore.
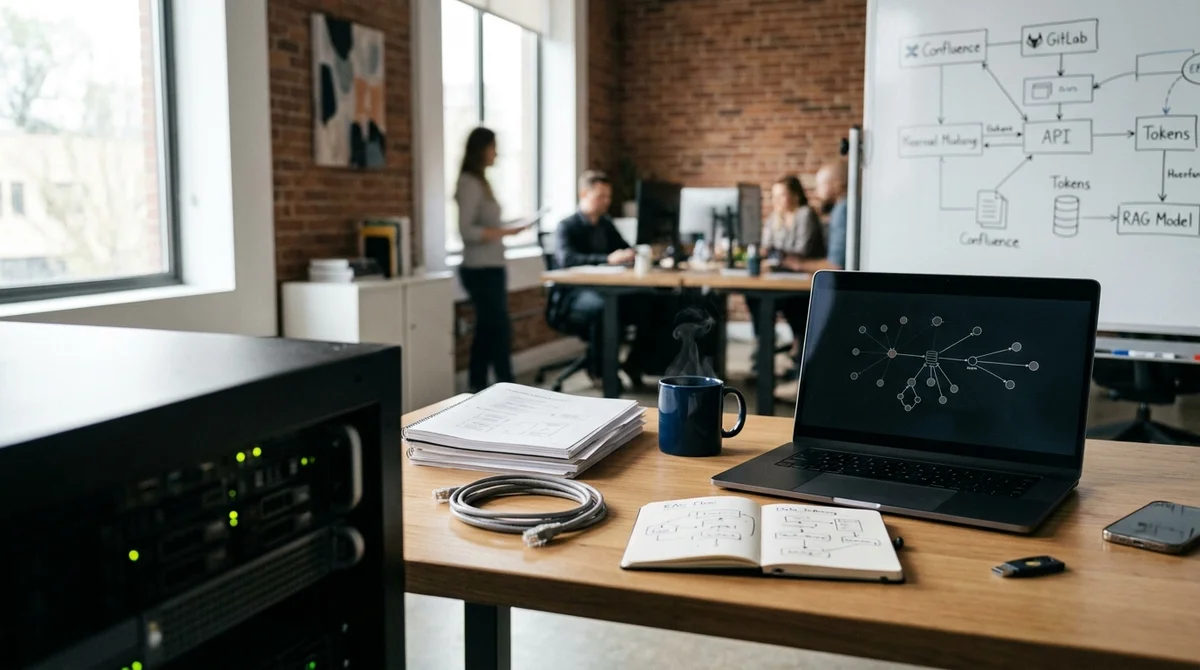
Comment déployer l'IA pour la recherche de documents : le retour d'expérience de Runity
Runity prépare un assistant RAG interne qui interroge Confluence et GitLab, vérifie les droits d'accès via les jetons des utilisateurs et tourne sur une infrastructure locale.
IA de recherche sur le web et dans les PDF : Perplexity, GigaChat, BotHub
Habr AI passe en revue neuf services qui combinent recherche web et analyse de documents, des moteurs privés DuckDuckGo et Brave à Perplexity, BotHub et GigaChat.
L'IA dans le DevOps : ce qui aide vraiment les ingénieurs
Des SRE de Vi.Tech et l'équipe de la plateforme Shturval expliquent pourquoi le DevOps n'a pas disparu, les dangers de l'automatisation excessive et les tâches que l'IA prend déjà en charge.
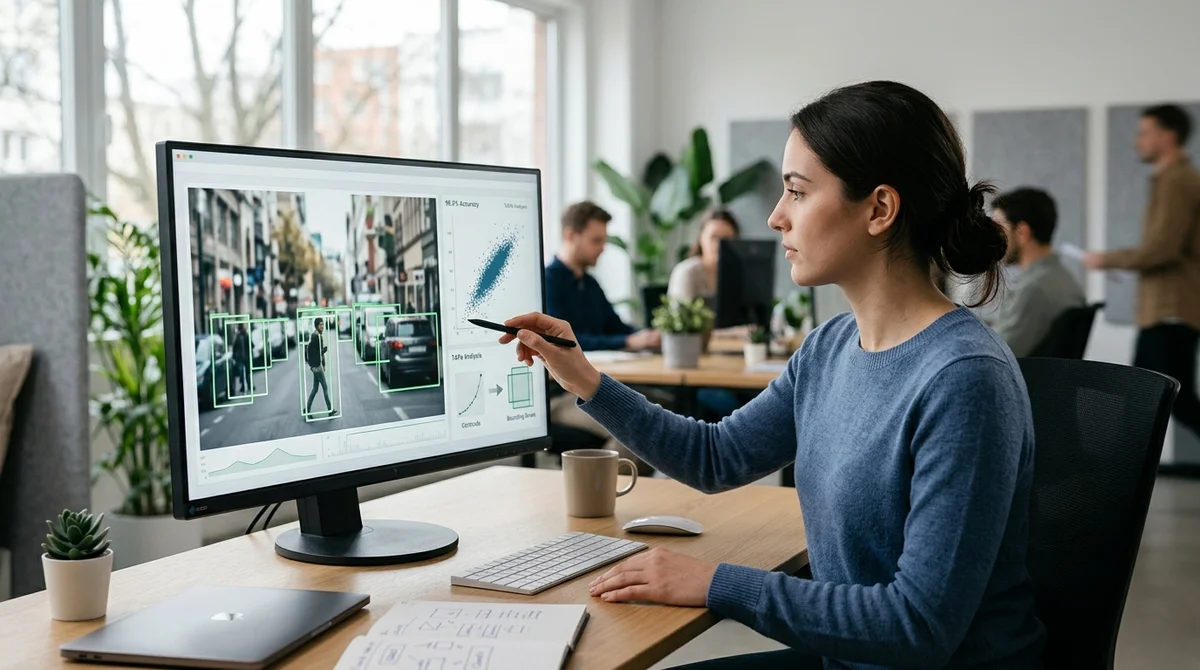
TAPe : une IA de vision par ordinateur à 98 % de précision
L'équipe de TAPe affirme que, lors de tests rapides sur 2 % de COCO, elle a porté la précision à 98 %, réduit les faux positifs et, pour la première fois, abandonné la recherche de centres d'objets pour des boîtes rectan
Loi sur l'IA : ce qu'il faut savoir pour l'utiliser en Russie
Le projet de loi russe sur l'IA pose un premier cadre pour le marché : droit à une alternative sans IA dans certains cas, étiquetage des contenus synthétiques et nouvelles règles pour modèles et plateformes.
L'IA pour les entreprises : comment les sociétés étendent leur infrastructure
Selon une étude de Selectel, la moitié des entreprises russes utilisent déjà une infrastructure pour l'IA, et les principaux freins tiennent désormais à l'économie et à l'expertise, non à la demande.
L'IA pour le SEO : DeepSeek remplace la collecte manuelle de mots-clés
Un article sur Habr montre comment un simple script d'export de mots-clés Wordstat est devenu un système avec DeepSeek, clustering par SERP et vote d'agents, réduisant la vérification manuelle à 5 %.
ChatGPT, DeepSeek et GigaChat ont tenté d'assembler un PC gamer à 100K
X-Com a comparé la manière dont ChatGPT, DeepSeek et GigaChat choisissent un PC gamer à 100 000 roubles : toutes les configurations fonctionnent, mais chaque modèle s'est trompé sur des points importants.
ChatGPT, DeepSeek et les autres : pourquoi l'IA flatte au lieu de donner un conseil honnête
Une étude de Stanford publiée dans Science montre que 11 modèles d'IA populaires donnent trop souvent raison à l'utilisateur, même en cas de tromperie, de préjudice ou de conflit personnel.