Habr AI
Fuente de noticias de IA. Los artículos son seleccionados y adaptados por la redacción de Hamidun News.
Últimas publicaciones
GPTunneL y la tendencia de Forbes: por qué las superapps de IA son el nuevo motor de crecimiento del mercado
GPTunneL, que ya tiene 2 millones de usuarios, explica cómo las superapps de IA cambian el comportamiento de la audiencia, la demanda corporativa y la economía del mercado, de China y EE. UU. a Rusia.
En Habr muestran cómo entrenar un mini-LLM en C# con ILGPU y gráficos AMD integrados
Un artículo de Habr explica cómo construir y entrenar un LLM diminuto en C# con ILGPU y OpenCL, exportarlo a GGUF y ejecutarlo en LM Studio, incluso con gráficos AMD integrados.
Anthropic presenta Claude Mythos Preview con una system card de 244 páginas en lugar de un lanzamiento
Anthropic presentó Claude Mythos Preview no como un lanzamiento habitual, sino mediante una system card de 244 páginas sobre las capacidades del modelo, sus riesgos y los motivos del acceso limitado.
OpenAI y Anthropic cambian el cálculo del coste de los modelos de lenguaje: en 2026 importa el precio de la tarea
OpenAI y Anthropic cambian las reglas de tarificación de los LLM: en 2026 a las empresas ya no les basta con vigilar el precio del token; tendrán que calcular el coste total de resolver una tarea.
Convierten Claude Code en un analista de IA basado en BABOK que entrevista y recopila requisitos
Un asistente de análisis de negocio construido sobre Claude Code sigue BABOK v3: ayuda a hacer entrevistas, reunir requisitos, no saltarse pasos y generar artefactos.
Claude Code y Codex: cómo reducir el desperdicio de tokens con tres archivos markdown
Claude Code y Codex gastan gran parte del contexto en volver a recorrer los proyectos. La solución: un mapa global, CLAUDE.md y memoria de sesiones anteriores.
LM Studio y Qwen: cómo se defienden los LLM locales programando en un MacBook M4 Pro
El autor probó modelos locales Qwen, Gemma y otros para programar con LM Studio en un MacBook M4 Pro: en chat ya son viables, pero en modo agente quedan claramente por detrás de la nube.
Qwen 3.5 en un MacBook Pro: comparativa de ocho servidores locales para trabajo en equipo
El autor probó ocho servidores MLX en un MacBook Pro M2 Max con Qwen 3.5 35B y comprobó que casi todos pierden velocidad de golpe con peticiones en paralelo.
Selectel: la IA no quita el trabajo, pero hace mucho más difícil entrar en la profesión
Selectel describe un nuevo mercado laboral en torno a la IA: no desaparecen vacantes, pero a los júniors les cuesta entrar, y la demanda y los salarios se desplazan hacia quienes saben trabajar con modelos.
Habr AI publica una guía sobre ChatGPT, Claude y mcp para quienes se inician en el tema
Habr AI explica sin teoría innecesaria las diferencias entre modelos locales y en la nube, por qué pagar suscripciones, cómo funcionan los agentes y por qué mcp ya se perfila como estándar.
Yoshua Bengio y LawZero: por qué el miedo a la IA del futuro distrae de las amenazas de hoy
Un texto sobre la «apuesta de Pascal» en la IA sostiene que el miedo a una superinteligencia hipotética desvía la atención de amenazas reales: vigilancia, poder corporativo y presión sobre los trabajadores.
Claude Opus 4.7 de Anthropic gasta más tokens de lo anunciado
Las pruebas del nuevo tokenizador de Claude Opus 4.7 arrojan un aumento del 45–47 % en el consumo, frente al 0–35 % prometido por Anthropic, con impacto en cuotas, caché y plan Max.
OpenAI lleva GPT-Rosalind a la biología: qué sabe hacer el nuevo modelo y dónde están sus límites
OpenAI lanza GPT-Rosalind para ciencias de la vida y lo vincula a un módulo de investigación de Codex, con la promesa de acelerar hipótesis y experimentos sin ensamblar a mano decenas de servicios.
Una auditoría de Cursor halla cuatro vulnerabilidades en las defensas del editor de código, pero no logra romper la autorización
La auditoría de Cursor halló prototype pollution, un campo dev oculto y filtraciones de arquitectura, pero la suscripción y los modelos premium siguen validándose en el servidor.
Anthropic lanza Opus 4.7 y OpenAI convierte Codex en un agente que usa el ordenador
Semana intensa en IA: Anthropic actualiza a Opus 4.7, OpenAI da a Codex el control del ordenador y Google y Baidu abren nuevos modelos de voz e imagen.
ChatGPT acertó los cinco casos médicos en el diagnóstico, pero quedó por detrás en el plan de acción
En una comparación de cinco casos médicos, ChatGPT no falló ni una vez el diagnóstico principal, pero rindió claramente peor en recomendaciones prácticas, pruebas y ruta del paciente.
Por qué los servicios LLM ignoran tus instrucciones y cómo recuperar el control de verdad
Ni un prompt detallado garantiza una respuesta obediente: por qué los LLM rompen el formato, caen en inyecciones y necesitan restricciones de ingeniería además de texto.
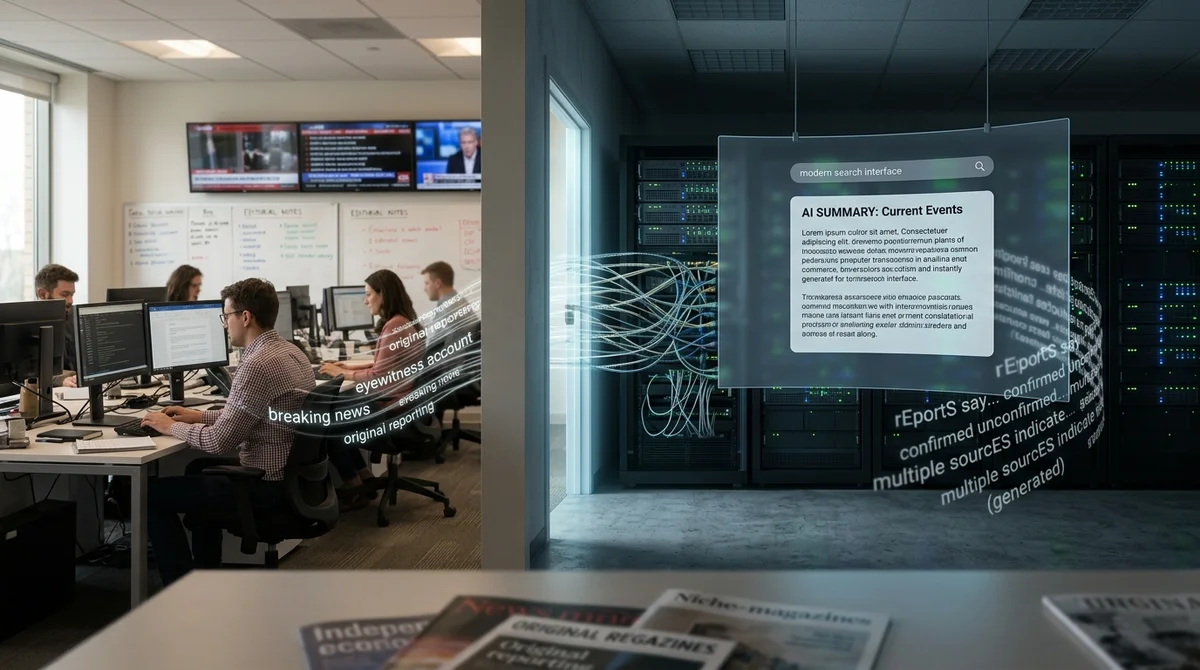
Google y OpenAI chocan con un límite: qué pasa si se acaba el texto humano en internet
La IA generativa no solo le quita tráfico a los sitios web con sus resúmenes: también erosiona su propia base de entrenamiento. Cuanto menos compense escribir, peor serán internet y los futuros modelos.
Cómo el Moscow Credit Bank muestra la evolución de la formación bancaria, de los oficinistas a la IA
Moscow Credit Bank repasa cómo los bancos formaron a su personal, desde revisar monedas y redactar correspondencia comercial hasta el onboarding personalizado, el compliance y los asistentes de IA.
OpenAI integra la tecnología de Sky en Codex para Mac y refuerza el control de aplicaciones en segundo plano
OpenAI traslada el trabajo de Sky a Codex para Mac: el agente controla varias aplicaciones en segundo plano, usa cursores propios y resuelve con más precisión las tareas rutinarias.
Habr AI explica cómo la búsqueda de soluciones basada en datos cambia la arquitectura cliente-servidor
Un artículo de Habr AI analiza cómo deben plantear la interacción con el usuario los sistemas expertos con búsqueda de soluciones guiada por datos: en local, en red local y por internet.
Seedance 2.0 llama la atención por su generación hiperrealista de personas y escenas
El sistema multimodal Seedance 2.0 acepta texto, imágenes, audio y vídeo y produce clips casi cinematográficos que ya alimentan el debate sobre los deepfakes.
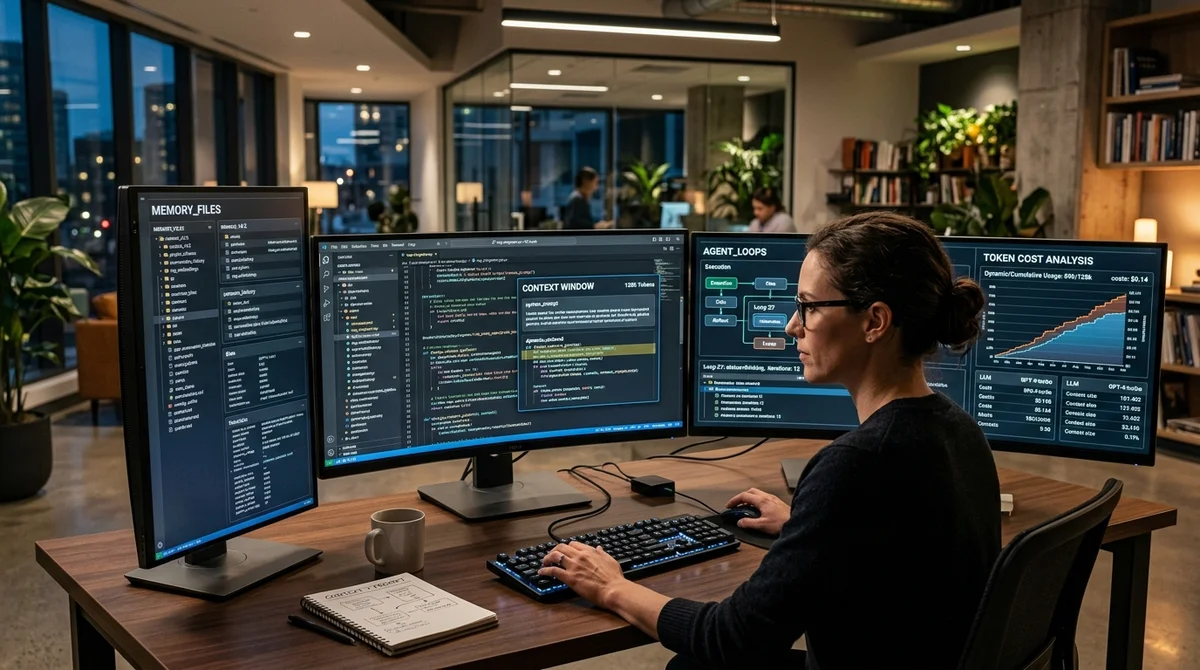
Claude Code y Codex cambian las reglas: la ingeniería de contexto sustituye a los prompts
Un análisis sobre Context Engineering sostiene que en Claude Code, Codex y los IDE agénticos ya no decide el prompt, sino la memoria, las instrucciones del sistema, las herramientas y el ensamblaje del contexto.
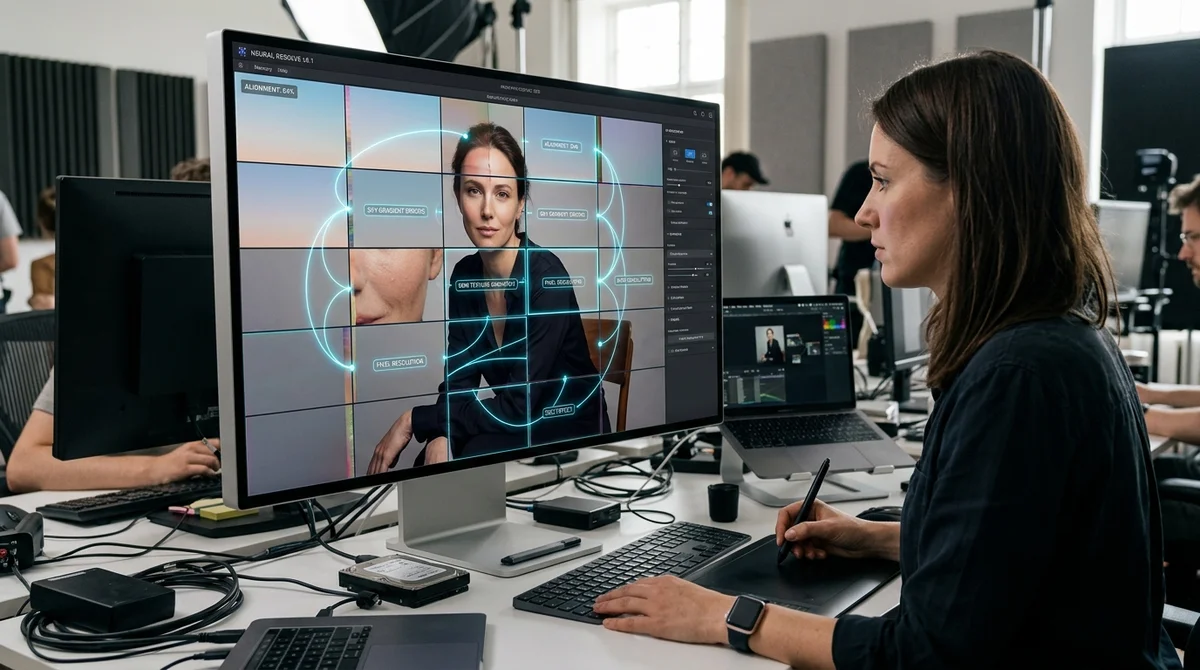
Por qué los modelos de difusión dejan costuras en fotos de 40 megapíxeles y cómo dar memoria a los tiles
Por qué el tiling rompe imágenes de 40–150 megapíxeles en modelos de difusión y qué mecanismos de memoria de la difusión de vídeo podrían trasladarse a la fotografía.
Lyubomir Gorbatko presenta Sessa, una alternativa a los transformers y a Mamba
Un artículo en Habr analiza Sessa, una arquitectura que busca combinar lo mejor de Transformer y Mamba para manejar contextos largos sin perder memoria controlable.
Harvard Business Review: cómo el uso intensivo de la IA provoca un «sobrecalentamiento cerebral»
Harvard Business Review describe el efecto AI brain fry: cuanto más dependen los empleados de Claude, Gemini y los agentes, mayor es el riesgo de fatiga cognitiva, confusión y peores decisiones.
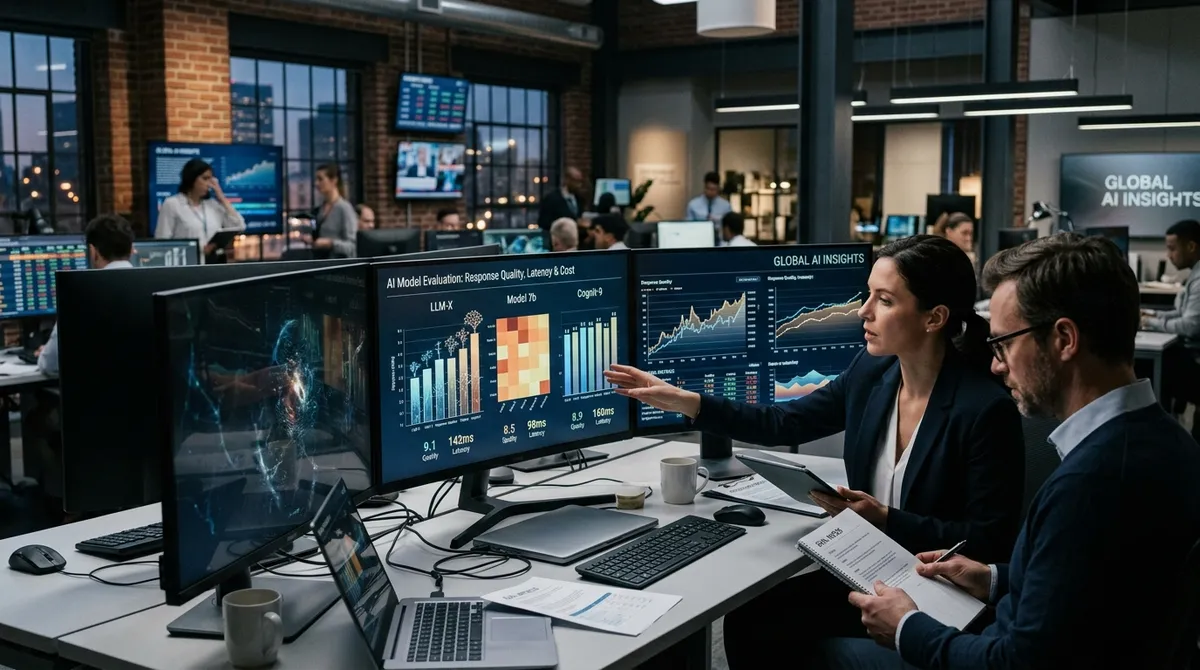
Flag Soft: el benchmark «Desafío Dalí» ayudó a elegir un LLM por calidad, velocidad y precio
El benchmark «Desafío Dalí» comparó LLM según tres criterios clave para llevarlos a un producto: calidad de las respuestas, velocidad y coste final.
Habr AI: en lugar de pipelines de agentes complejos, se aconseja a los desarrolladores usar markdown, git y memoria de sesiones
Un manifiesto en Habr critica los pipelines de agentes sobrecargados: su autor sostiene que en el desarrollo complejo con IA importan más las sesiones, los roles, las reglas y git que LangChain y las bases vectoriales.
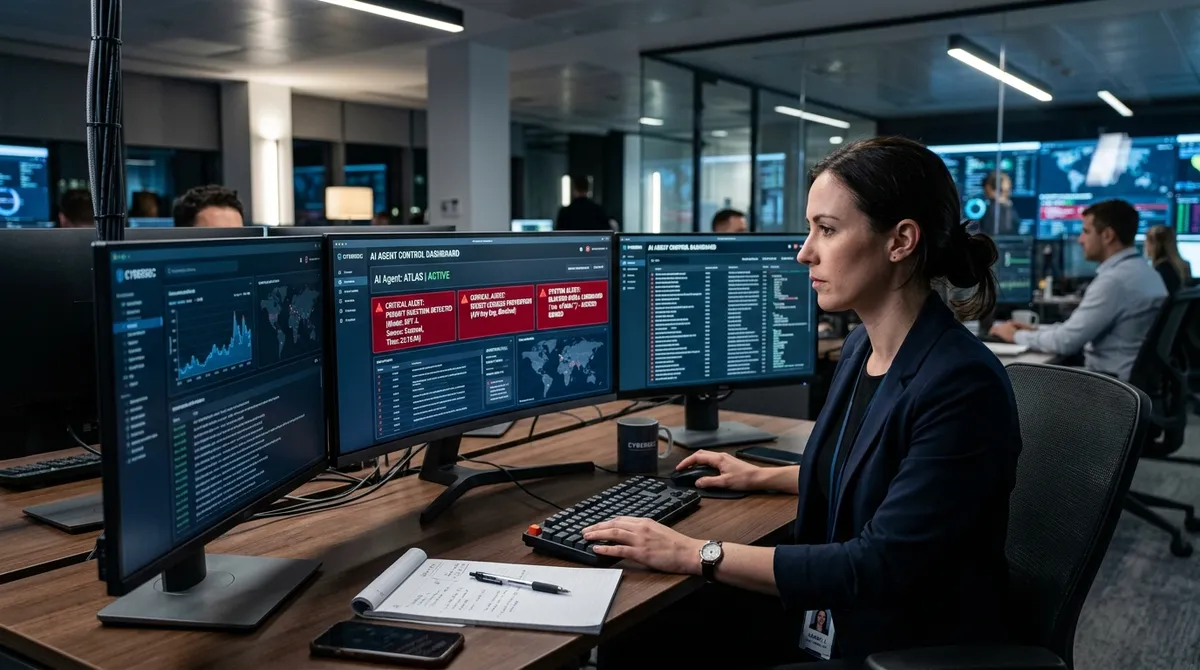
El plugin opencode-policy añade 309 reglas para proteger a los agentes de IA de inyecciones y fugas
Para opencode se propone un filtro determinista con 309 reglas regex que intercepta prompt injection y llamadas peligrosas a herramientas antes de que lleguen al shell, los archivos o los secretos.
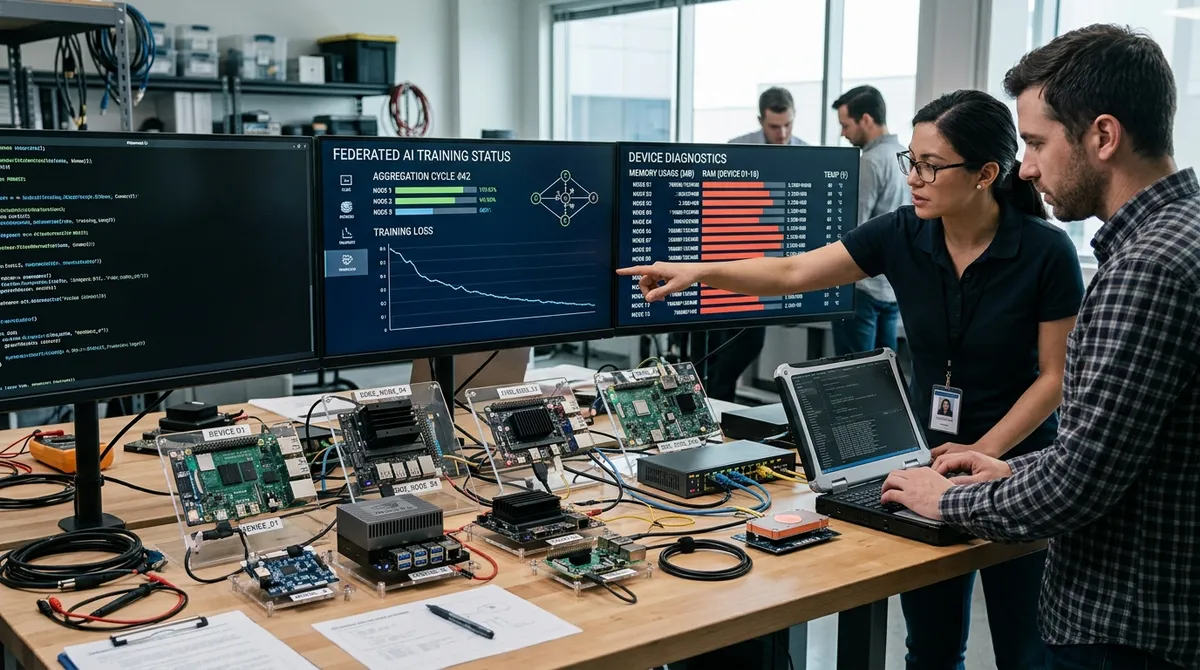
Un ingeniero de Eltex explica cómo ejecutar aprendizaje federado en dispositivos edge con 256 MB de memoria
Un ingeniero de Eltex, a partir de una charla en AiConf, explica cómo aplicar aprendizaje federado en dispositivos edge con menos de 256 MB de RAM, donde la memoria es el principal límite.