Por qué los modelos de difusión dejan costuras en fotos de 40 megapíxeles y cómo dar memoria a los tiles
Los modelos de difusión funcionan bien con imágenes corrientes, pero en fotogramas profesionales de 40–150 MP el tiling deja casi inevitablemente costuras, color fluctuante y texturas rotas. El artículo analiza por qué los modelos fotográficos no pueden mantener memoria entre tiles vecinos y qué ideas de la difusión de vídeo, de FramePack a AnimateDiff, podrían ayudar a corregirlo. El autor sostiene que el límite no es solo el hardware ni el tamaño de la imagen, sino la propia arquitectura de la difusión fotográfica.
Procesado por IA desde Habr AI; editado por Hamidun News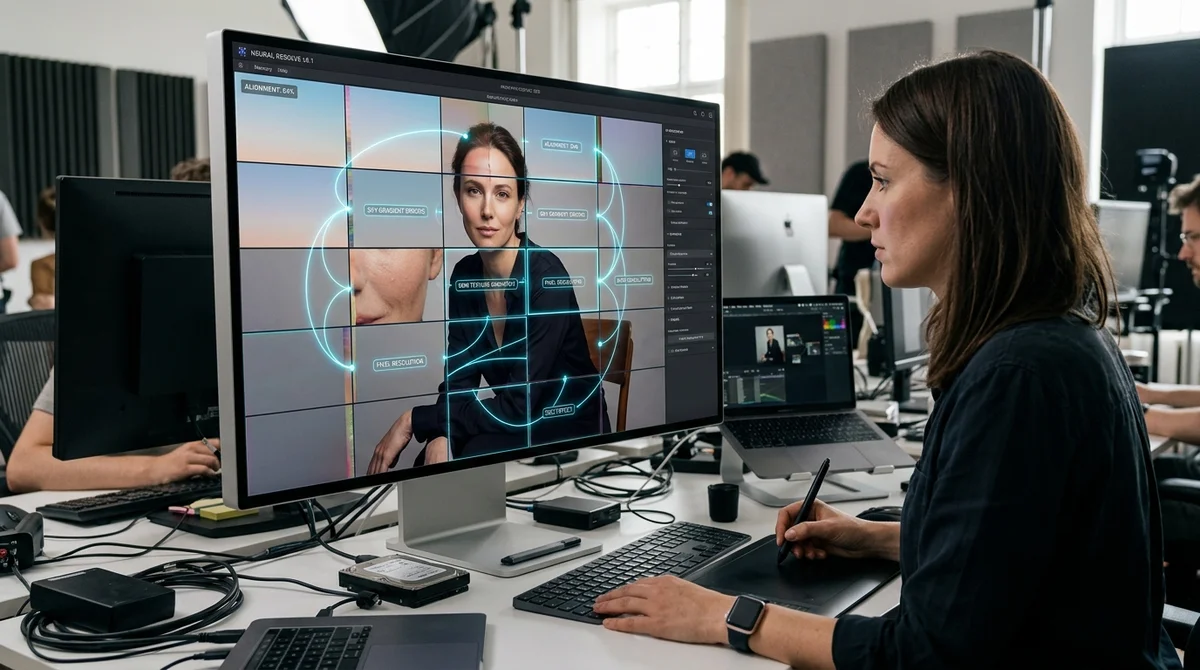
La causa principal de las costuras en imágenes enormes no resulta ser un mal ensamblado ni solo la falta de memoria de vídeo. El problema es más profundo: los modelos de difusión fotográficos no conservan memoria entre fragmentos vecinos de la imagen. Cuando un fotograma de 40–150 megapíxeles se corta en decenas o cientos de tiles, el modelo toma cada decisión desde cero. No sabe qué tono de cielo, color de piel o escala de textura ha elegido ya en el fragmento de al lado. De ahí surgen los escalones en los degradados, el color fluctuante y las uniones visibles, que resultan especialmente dañinas en el retoque profesional.
El autor aborda el tema desde la práctica, no desde la teoría: acumula veinte años de retoque y cuatro años intentando adaptar los modelos de difusión a producción. En la fotografía de estudio, publicitaria y de revista, la alta resolución no es un lujo sino un estándar de trabajo, y estos fotogramas rara vez caben en una sola pasada de generación o edición. Por eso la industria vuelve una y otra vez al mismo recurso: dividir la imagen en 100 o más fragmentos, procesarlos por separado y volver a ensamblarlos. En detalles pequeños puede funcionar de forma aceptable, pero en piel, tejidos, fondos y transiciones de luz los artefactos son casi inevitables.
La raíz del problema es que el tiling convencional conserva el detalle local, pero rompe la coherencia global. Cada tile ve solo su trozo de la escena y no entiende qué ocurre a la izquierda, a la derecha, arriba o abajo. Aunque las zonas vecinas se solapen, el modelo puede desplazar ligeramente el balance de color, interpretar el grano de otra manera, añadir poros que no encajan o construir otro ritmo de textura. El blending y las máscaras ocultan parte de los defectos, pero no eliminan la causa: el modelo fotográfico carece de un mecanismo que enlace las decisiones entre vecinos. Por eso un ensamblado perfecto en fotogramas muy grandes sigue siendo más la excepción que la norma.
El artículo propone mirar hacia la difusión de vídeo, donde la coherencia lleva tiempo en el centro de la arquitectura. Un modelo de vídeo debe recordar cómo era un objeto en el fotograma anterior para no perder el rostro, la luz, la textura y la posición de los detalles durante el movimiento. El autor analiza ocho clases de esa memoria, desde BCLA de SANA-Video y FramePack hasta SVD reshape, AnimateDiff y otros enfoques, y evalúa qué se puede trasladar a los tiles y qué no.
La cuestión clave no es el nombre del método, sino el principio: ¿se puede lograr que un modelo fotográfico transmita al fragmento vecino un contexto compacto, un estado oculto o una estructura de escena compartida, para que las decisiones no se tomen en el vacío?
De aquí se derivan tres grandes ideas para la práctica. La primera es el intercambio de contexto entre tiles vecinos, de modo que el modelo reciba no solo el fragmento actual, sino también información comprimida sobre las zonas ya procesadas. La segunda es una memoria compartida a nivel de latentes o de mecanismos de atención, que mantenga el mismo color, la misma iluminación y el mismo carácter de superficie en toda la imagen.
La tercera es un esquema de varios pasos en el que primero se construye una representación global aproximada de toda la escena y después los tiles locales solo afinan los detalles, sin romper el conjunto. Para impresión, publicidad exterior, retoque de belleza y fotografía comercial esto es crítico: allí cualquier ruptura de textura o salto de tono se ve de inmediato.
La conclusión principal es sencilla: el límite no está solo en el hardware ni solo en el tamaño de la imagen, sino en la propia arquitectura de la difusión fotográfica. Mientras el modelo no aprenda a recordar lo que ha pasado en el fragmento vecino, el procesamiento de fotogramas de 40 megapíxeles o más seguirá siendo un compromiso entre detalle e integridad. Si los mecanismos de memoria del vídeo logran adaptarse a los tiles, los modelos de difusión darán un paso notable desde las demos vistosas hacia una herramienta profesional completa de retoque y posproducción.
- 12 nov 2026MiniMax publica los pesos de H3-Image: imágenes 4K en 10–16 segundos y 16 referencias
- 9 feb 2026Modelos de difusión: análisis a fondo y perspectivas de desarrollo
- 23 abr 2026Richard Tice, de Reform UK, publicó una foto con señales de manipulación con IA, según expertos
- 31 ene 2026La Luna de una red neuronal: por qué tu smartphone ya no sabe hacer fotos
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
Lo esencial de la IA — una vez por semana
Siete historias que de verdad importaron, elegidas a mano. Sin ruido ni notas de prensa.
¡Listo! Revisa tu correo para la confirmación.