Habr AI explica cómo la búsqueda de soluciones basada en datos cambia la arquitectura cliente-servidor
Los sistemas expertos con búsqueda data-driven necesitan algo más que una base de conocimiento: requieren un diálogo estable con el usuario en cada paso. Un nuevo análisis muestra en qué se diferencian el uso local, el trabajo en red local y el acceso por internet, qué límites tiene cada modelo y por qué la arquitectura debe elegirse según el escenario de uso y no por moda. El enfoque solo funciona si el sistema es capaz de guiar al usuario de forma continua a través de una cadena de aclaraciones. Por eso la arquitectura pesa tanto como la propia base de conocimiento. La conclusión principal: en la búsqueda data-driven, la arquitectura no es una envoltura del algoritmo, sino parte del producto.
Procesado por IA desde Habr AI; editado por Hamidun News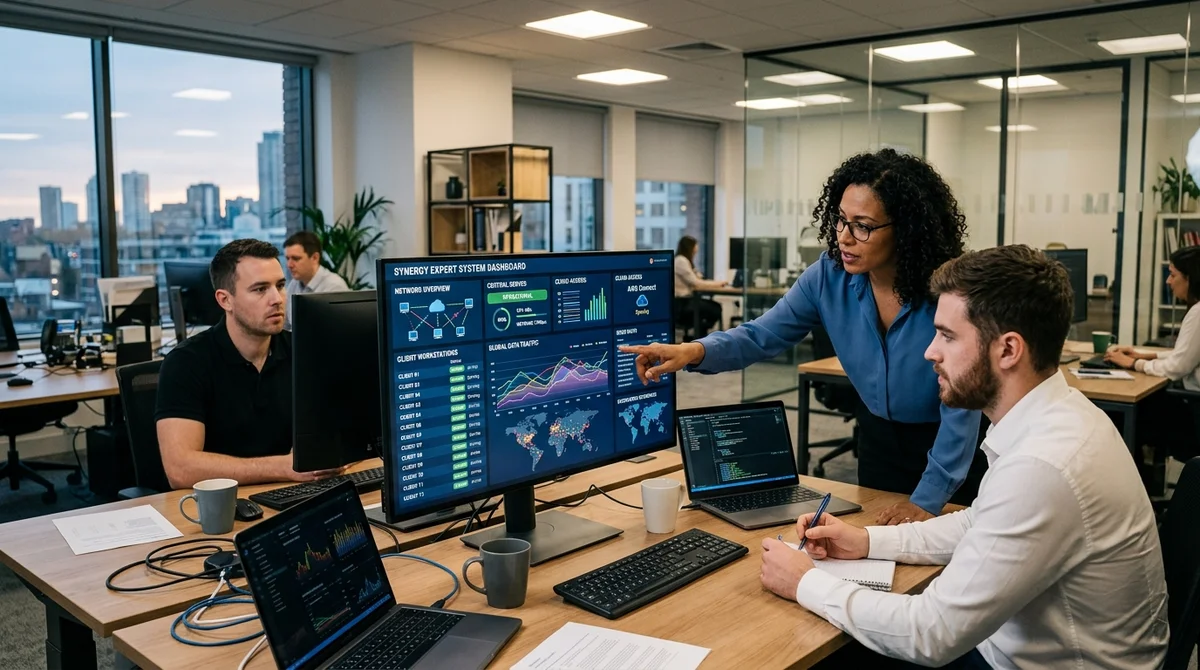
La búsqueda de soluciones guiada por datos solo funciona cuando el sistema sabe guiar al usuario de forma continua a través de una cadena de aclaraciones. Por tanto, la arquitectura influye aquí tanto como la propia base de conocimiento. El foco no está en la interfaz como tal, sino en cómo organizar un diálogo vivo entre la persona y el sistema experto cuando este debe atender a varios puestos de trabajo a la vez sin perder la coherencia de los datos.
La clave del enfoque data-driven es que el sistema no se limita a devolver una respuesta preparada para una única consulta. Contrasta los datos de entrada, formula preguntas de aclaración, comprueba restricciones y va reduciendo poco a poco el conjunto de opciones. Por eso la calidad del resultado depende no solo de las reglas de la base de conocimiento, sino también de la estabilidad con que se transmiten las respuestas del usuario, la rapidez de reacción del sistema y su capacidad de continuar el diálogo sin perder el contexto cuando participan varias personas o varios dispositivos.
El análisis de Habr AI se centra en tres modelos básicos de interacción: ejecución local en un solo ordenador, trabajo dentro de una red local y acceso por internet. A primera vista las diferencias pueden parecer técnicas, pero en la práctica cambian el propio escenario de uso.
Si el sistema experto se instala en local, es más sencillo de desplegar, no depende de la red y encaja en entornos aislados. Este esquema resulta cómodo para pilotos, tareas profesionales muy específicas y situaciones en las que importan la autonomía y la previsibilidad. Pero sus límites aparecen pronto: las actualizaciones divergen entre puestos, el historial de trabajo se fragmenta y la base de conocimiento única se convierte en un conjunto de copias.
La red local aporta el siguiente nivel de madurez. Cuando varios usuarios se conectan a una base de conocimiento común y a un mismo motor de búsqueda de soluciones, el sistema empieza a funcionar como herramienta corporativa y no como un programa aislado. Es más fácil controlar las versiones, administrar los cambios y garantizar reglas de decisión uniformes. A la vez surgen nuevos requisitos: hay que pensar en el trabajo concurrente, la separación de permisos de acceso, el registro de las sesiones de usuario, el log de acciones y la resiliencia del servidor. De lo contrario, incluso una buena lógica de recomendaciones choca enseguida con fallos organizativos.
El acceso web por internet hace el sistema aún más flexible, porque pueden conectarse sucursales, especialistas remotos, socios y usuarios móviles. Pero es justo aquí donde más se nota que la conversación sobre arquitectura no puede reducirse a elegir un stack de moda. Importan no solo las páginas, las API o el transporte de mensajes, sino dónde se guarda el estado del diálogo, cómo se restablece la sesión tras un corte de conexión, cómo se protegen los datos sensibles y con qué rapidez recibe el usuario respuesta en cada paso.
En sistemas donde la búsqueda de una solución se construye como una serie de aclaraciones, los retrasos, la pérdida de contexto o la divergencia de versiones pueden ser más críticos que en un simple directorio de consulta.
Cabe destacar además que el material evita deliberadamente los detalles de una implementación concreta. No se discuten REST o SPA, long polling o WebSocket, server-side session o event sourcing. Y ese es un punto fuerte del enfoque: primero hay que definir el modelo de interacción entre el usuario y el sistema experto, y solo después elegir las herramientas de desarrollo. Si no, el equipo corre el riesgo de empezar por las tecnologías sin responder a una pregunta más importante: dónde debe residir exactamente la lógica de decisión, cómo escalará la base de conocimiento y quién responde de la integridad de la experiencia de usuario cuando trabajan varios clientes a la vez.
La conclusión principal es sencilla: para la búsqueda data-driven, la arquitectura no es una carcasa sobre el algoritmo, sino parte del propio producto. De la elección entre el modelo local, de red o web dependen la velocidad de implantación, el coste de mantenimiento, el control de versiones, la seguridad y la comodidad del usuario. Cuanto antes se tenga esto en cuenta al diseñar el sistema experto, menos probable será tener que reconstruir desde cero un prototipo exitoso cuando crezca hasta convertirse en una herramienta para un equipo, un departamento o toda la empresa.
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
Lo esencial de la IA — una vez por semana
Siete historias que de verdad importaron, elegidas a mano. Sin ruido ni notas de prensa.
¡Listo! Revisa tu correo para la confirmación.