Flag Soft: el benchmark «Desafío Dalí» ayudó a elegir un LLM por calidad, velocidad y precio
Al elegir un LLM para su primer proyecto personal, el autor creó su propio benchmark, el «Desafío Dalí», y comparó modelos por calidad, velocidad y coste. La conclusión es práctica: un producto no necesita el «mejor» modelo en abstracto, sino el que ofrezca el nivel de respuestas requerido dentro de una latencia y un presupuesto aceptables. Ese enfoque ayudó a encontrar la opción óptima para integrar en los productos de la compañía.
Procesado por IA desde Habr AI; editado por Hamidun News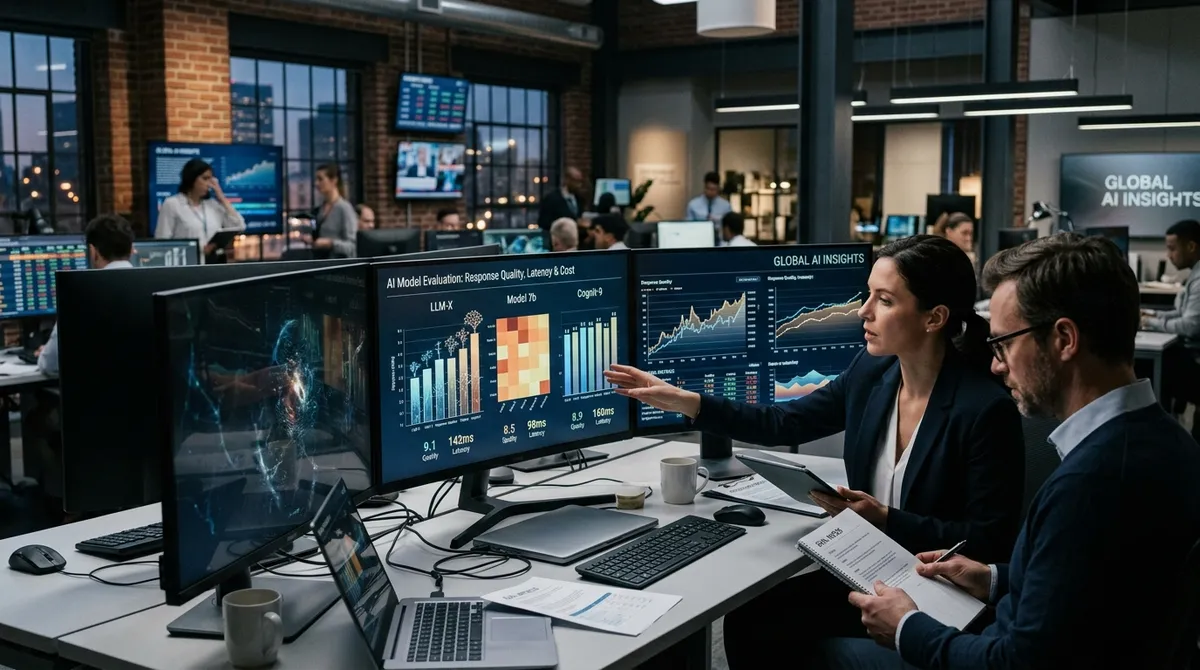
Elegir un LLM para un producto real rara vez se reduce a comparar demos vistosas. El autor del texto abordó la tarea desde un ángulo práctico: mientras buscaba un modelo para su primer proyecto personal, creó su propio benchmark, el «Desafío Dalí», y evaluó los LLM más populares no por promesas ruidosas, sino por tres factores que realmente influyen en la implantación: calidad de las respuestas, velocidad y coste.
La idea nació de un problema de ingeniería de lo más cotidiano. Cuando hay que elegir un modelo para un proyecto propio, la pregunta abstracta «¿cuál es el mejor LLM?» se convierte pronto en un conjunto de restricciones prácticas. Un modelo escribe de forma convincente, pero responde demasiado despacio. Otro cabe en el presupuesto, pero pierde el hilo en instrucciones largas. Un tercero supera las pruebas de forma estable, pero su precio final lo vuelve inviable para un producto masivo. De ahí salió esta prueba casera, que después resultó útil no solo para un experimento personal, sino también para las decisiones de producto de Flag Soft.
El «Desafío Dalí» se basa en una lógica sencilla pero acertada. Si un modelo va a integrarse en un producto, hay que compararlo no por la impresión puntual de un chat, sino con un mismo conjunto de tareas. En este enfoque, la calidad no significa simplemente «me gusta la respuesta o no»: es la capacidad del modelo de conservar el sentido, seguir las instrucciones, no perder detalles y entregar un resultado utilizable sin una larga corrección manual.
La velocidad importa igual: en una herramienta interna se pueden tolerar unos segundos de más, pero en un servicio de cara al usuario cada retraso perjudica la retención y la conversión. El coste es el tercer parámetro obligatorio, porque incluso un modelo potente puede resultar demasiado caro al escalar a miles de solicitudes.
Ahí reside el valor del benchmark: no busca un campeón absoluto, sino que muestra el equilibrio. En la práctica, casi nunca gana el modelo que simplemente escribe mejor. Gana el que ofrece una calidad aceptable en el momento adecuado y a un precio compatible con la economía unitaria del producto. Para una empresa que quiere integrar un LLM en un servicio real, esto resulta mucho más útil que las tablas llamativas con puntuaciones abstractas. Este método de evaluación permite ver de antemano dónde aparecerá el cuello de botella: en la latencia de respuesta, en el presupuesto de tokens o en la inestabilidad del comportamiento del modelo ante solicitudes similares.
La conclusión aplicada del autor tiene interés propio: el benchmark ayudó a elegir no el modelo «más inteligente» en general, sino el LLM óptimo para integrarlo en los productos de Flag Soft. La diferencia es importante. Los equipos suelen empezar la implantación con un modelo de primera línea y luego se ven obligados a retroceder a una alternativa más barata o más rápida. Aquí la lógica es la inversa: primero se formulan los requisitos reales y después se selecciona el modelo que los cumple. Este orden reduce el riesgo de rehacer costosamente el trabajo cuando la arquitectura ya depende de un proveedor que no soporta la economía, la velocidad de respuesta o el nivel de servicio esperado.
El enfoque del autor también resulta útil porque refleja el estado real del mercado de LLM. Distintos modelos pueden ganar en distintos escenarios: generación de textos, resúmenes, búsqueda de conocimiento, asistencia al operador, autocompletado en una interfaz o gestión de solicitudes de clientes. Un mismo candidato puede lucirse en tareas creativas y fracasar donde se exige una disciplina estricta al seguir instrucciones. Por eso los benchmarks personalizados dejan de ser un lujo y pasan a ser higiene básica para cualquier equipo que vaya a pagar un modelo con su propio presupuesto y responder por la experiencia del usuario.
El sentido principal del «Desafío Dalí» es simple: un LLM se elige como cualquier tecnología de infraestructura, con métricas verificables y no por la publicidad. Si un equipo tiene su propio conjunto de tareas, un límite de tiempo de respuesta y un presupuesto claro, casi seguro obtendrá una respuesta más precisa que la de una clasificación general. Para el mercado es una señal más: la época de elegir el modelo «por reputación» llega a su fin y pasa a primer plano el pragmatismo de ingeniería.
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
Lo esencial de la IA — una vez por semana
Siete historias que de verdad importaron, elegidas a mano. Sin ruido ni notas de prensa.
¡Listo! Revisa tu correo para la confirmación.