Un ingeniero de Eltex explica cómo ejecutar aprendizaje federado en dispositivos edge con 256 MB de memoria
El ingeniero de Eltex Alexander Loshkarev ha publicado un texto sobre aprendizaje federado en dispositivos edge con menos de 256 MB de memoria RAM. No trata de la teoría del FL, sino de su lado práctico: cómo encajar el modelo, el entrenamiento local y el intercambio de actualizaciones en un perfil de recursos muy limitado. La primera parte plantea con claridad el marco del problema para equipos de sistemas embebidos y de ML.
Procesado por IA desde Habr AI; editado por Hamidun News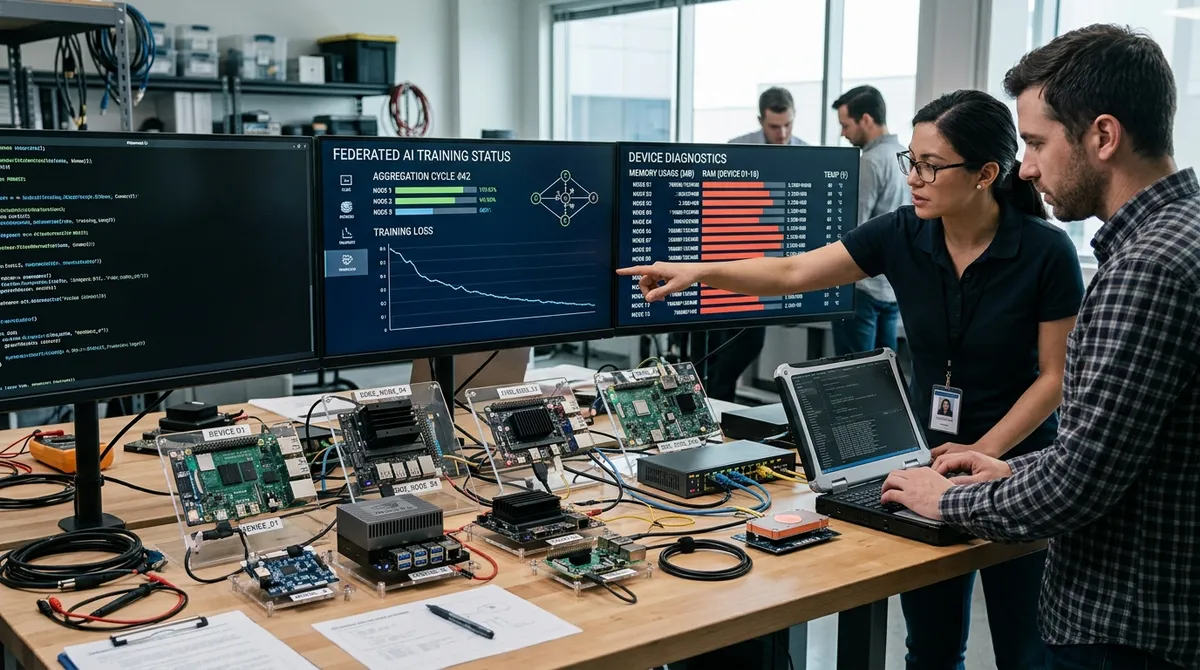
El aprendizaje federado suele debatirse en el contexto de los smartphones, los coches y las grandes redes IoT, pero en la práctica el principal obstáculo suele ser mucho más prosaico: al dispositivo simplemente le falta memoria. Ese es el foco del texto del ingeniero de Eltex Alexander Loshkarev, preparado a partir de su charla para AiConf.
El tema suena específico, pero afecta a casi cualquier proyecto que necesite llevar el ML de la nube al borde de la red y hacerlo funcionar en hardware con recursos muy modestos. Se trata de escenarios en los que el dispositivo edge tiene menos de 256 MB de memoria RAM. Para los equipos de servidores es un límite casi extremo, pero para la electrónica industrial, las pasarelas, los equipos de telecomunicaciones, los sistemas embebidos y los controladores especializados, esa configuración es perfectamente real.
En estas condiciones, la tarea ya no consiste en tomar un modelo preparado y cargarlo en memoria. Hay que hacer caber a la vez el propio modelo, los datos, los búferes, los procesos del sistema y la lógica de intercambio de actualizaciones, sin perder la estabilidad del dispositivo.
Lo interesante del aprendizaje federado en este contexto es que permite entrenar o ajustar modelos sin transferir de forma centralizada los datos en bruto. Los cálculos se hacen en local y solo se envían al exterior los parámetros o sus cambios. Este enfoque ayuda a controlar mejor la privacidad, reduce la dependencia de un canal de comunicación constante y hace más viables los escenarios edge. Pero tiene una cara negativa: el propio cliente local de FL requiere memoria, cómputo y un pipeline bien organizado. Cuanto más débil es el dispositivo, más estricto hay que ser con cada megabyte.
A juzgar por la descripción de la primera parte, el material aborda el lado de ingeniería de este problema y no la teoría abstracta. Para los equipos que despliegan ML en la periferia, este es el punto más doloroso: un modelo puede ser preciso en el laboratorio y resultar inútil en producción si no cabe en memoria o degrada el resto de servicios. En estos dispositivos importa no solo el tamaño de los pesos, sino también los picos temporales de consumo de memoria durante la inferencia, la preparación de lotes, la serialización de actualizaciones y el intercambio por red. Aunque el modelo parezca compacto en estático, su comportamiento en tiempo de ejecución puede hacer inviable el despliegue.
En este sentido, la formulación sobre un dispositivo para el que 1 GB suena a lujo describe con bastante precisión la brecha entre el stack de ML típico y el mundo embebido real. Muchas herramientas y prácticas habituales en el desarrollo para servidores dejan de funcionar aquí sin adaptación. No se puede aumentar indefinidamente el tamaño de lote, mantener copias innecesarias de tensores ni confiar en un amplio margen de memoria del sistema. Cualquier error al estimar el perfil de recursos se convierte rápidamente en reinicios, bloqueos o en el abandono de la función para la que se implantó el modelo.
También es importante que no se trata solo de ejecutar inferencia en un dispositivo pequeño, sino específicamente de aprendizaje federado. Es un modo más complejo: el sistema debe recibir periódicamente el modelo global, ejecutar pasos de entrenamiento en local, almacenar estados intermedios y devolver el resultado. Si hay poca memoria, hay que revisar literalmente todo: el tamaño del modelo, el formato de representación de los datos, la frecuencia de sincronización, la duración de las sesiones locales y, a veces, la propia arquitectura del cliente.
Del anuncio se desprende que el autor plantea bien la pregunta: antes de hablar de la calidad del modelo, hay que entender si es posible mantenerlo en hardware edge real sin caídas y sin concesiones constantes en fiabilidad.
Para el mercado, es una señal importante. El interés por la IA en el borde de la red crece, pero el despliegue real choca no con demos vistosas, sino con los límites de memoria, energía y estabilidad. Por eso estos materiales son útiles no solo para ingenieros de ML, sino también para equipos de backend, embebidos y producto: devuelven la conversación del terreno de las promesas al de la ingeniería de sistemas.
Si la primera parte fija el marco del problema, la conclusión principal ya está clara: en el ML en el edge no gana el modelo más de moda, sino el que el dispositivo realmente es capaz de soportar.
Ship AI Faster with Founders, Engineers & Weekly Architecture Reviews
Inside Vibe Club (hamidun.com/club) — weekly live masterminds with Zhemal Khamidun, Tech Radar, full LMS access, and 370+ production Claude Code skills.
Lo esencial de la IA — una vez por semana
Siete historias que de verdad importaron, elegidas a mano. Sin ruido ni notas de prensa.
¡Listo! Revisa tu correo para la confirmación.