Claude Code y Codex: cómo reducir el desperdicio de tokens con tres archivos markdown
El problema de los agentes de programación va más allá del precio de los modelos: navegan a ciegas. Vuelven a recorrer el disco, leen archivos innecesarios e incluso se conectan por SSH para obtener datos que podrían haber conocido de antemano. El análisis muestra que tres elementos reducen drásticamente las tool calls, el consumo de tokens y el número de errores: un mapa global de proyectos, un CLAUDE.md por proyecto y una memoria en markdown de las sesiones anteriores.
Procesado por IA desde Habr AI; editado por Hamidun News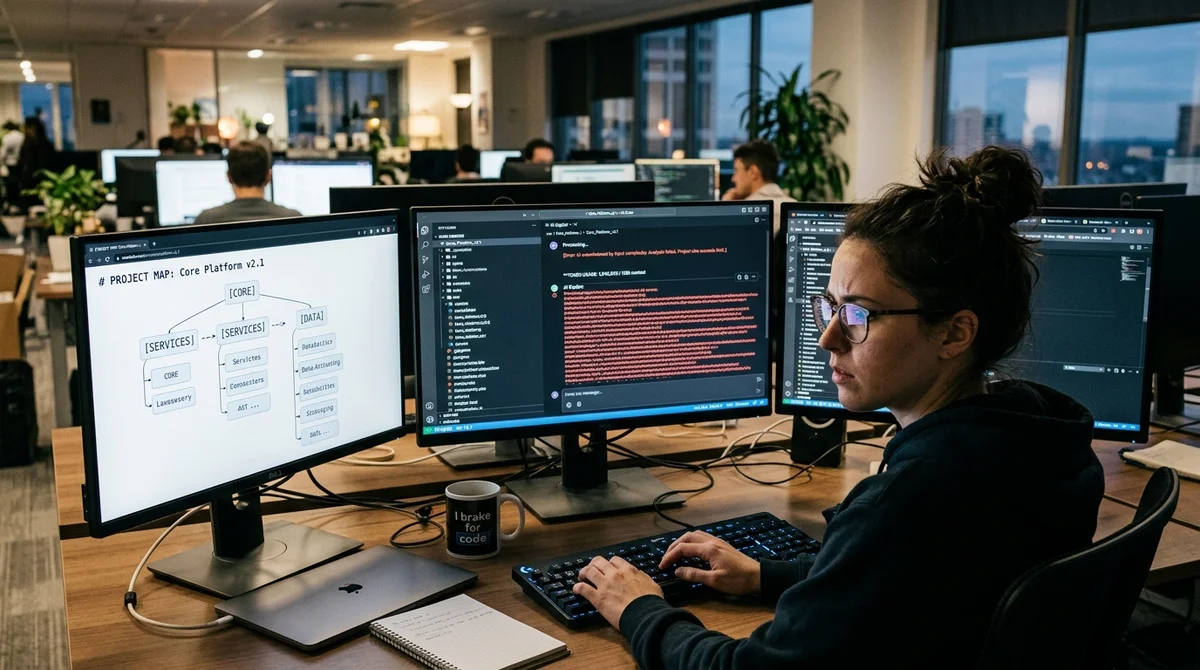
Los agentes de IA para desarrollo queman contexto no porque respondan mal, sino porque dedican casi todo su tiempo a buscar el lugar correcto en el código. Incluso con una ventana de un millón de tokens, vuelven a recorrer directorios, releen archivos que ya conocen y revisan servidores como si vieran el proyecto por primera vez. El análisis muestra que, ante una pregunta sencilla sobre pagos, el agente gastó más de 80 mil tokens y más de 15 llamadas a herramientas, aunque la respuesta en sí ocupó unos 800 tokens.
Es decir, casi todo el presupuesto se fue en navegación, no en razonamiento. El problema no resultó ser una particularidad de Claude Code, sino una limitación general de los agentes de programación actuales. Cursor, Codex y Gemini CLI funcionan con el mismo esquema: sin un mapa del espacio de trabajo, empiezan cada nueva sesión con una fase de exploración.
Con un solo proyecto, es tolerable. Pero cuando un desarrollador tiene decenas de repositorios, VPS y entornos de staging, el agente primero hace grep en el directorio personal, encuentra archivos parecidos en proyectos vecinos, los lee, luego se da cuenta de que se ha equivocado de sitio y lanza una nueva ronda de búsqueda. En un ejemplo real, una pregunta sobre los métodos de pago de un bot derivó en una búsqueda por varios proyectos, la relectura de seis archivos e incluso una comprobación de la configuración del servidor por SSH.
Este modo de trabajo, además de caro, es frágil: el modelo gasta esfuerzo en orientarse y pasa por alto con facilidad las partes relevantes. El autor analiza tres enfoques populares que suelen proponerse como remedio. El primero es RAG y la búsqueda vectorial.
Encuentra bien fragmentos semánticamente similares, pero entiende mal la estructura del proyecto: puede devolver chunks con auth, login y token, pero no reconstruir la cadena exacta de dependencias entre el middleware, la lógica de refresh y la configuración de JWT. Además, RAG requiere una infraestructura propia, un índice y reindexaciones, y cada consulta añade latencia. La segunda vía es el análisis estático y el grafo de dependencias mediante AST y tree-sitter.
Resulta útil dentro de un único repositorio, pero casi inútil a nivel de cartera de proyectos, donde hay que responder no solo cómo funciona una función, sino también dónde vive el servicio en cuestión, en qué servidor se ejecuta y cuál es su estado. La tercera opción es mantener un CLAUDE.md en cada proyecto.
Ayuda, pero solo después de que el agente haya entendido a qué proyecto debe ir. En su lugar, se propone un contexto jerárquico que guía al agente de arriba abajo. En el nivel cero está el mapa global de proyectos: una tabla breve con nombres, rutas, servidores y estados que se incluye automáticamente en cada sesión.
En el primer nivel, un CLAUDE.md en la raíz de cada proyecto con el stack, los archivos clave, los comandos de despliegue, el nombre del servicio y los logs. Entre ambos se puede añadir una capa intermedia con Graphify si la base de código es grande y se necesita un grafo preciso de relaciones.
Como tercera capa en markdown, el autor propone guardar las sesiones anteriores y las decisiones de ingeniería en archivos markdown con frontmatter YAML, para que el agente pueda recordar qué se discutió, qué archivos se modificaron y qué decisiones de depuración o de pagos se tomaron una semana antes. La idea es sencilla: primero el mapa, después la descripción del proyecto, luego la memoria de conversaciones pasadas y solo entonces el código fuente. Las mediciones muestran que este esquema aporta una mejora práctica, no cosmética.
Ante una pregunta sobre la arquitectura del proyecto, el agente a ciegas necesitó 12 tool calls frente a una sola con la jerarquía. Ante la pregunta de qué proyectos usan una biblioteca concreta, el modo a ciegas hizo 44 llamadas, escaneó todo el disco y aun así omitió uno de los tres proyectos relevantes; la jerarquía resolvió la tarea con dos consultas puntuales y dio una respuesta completa. En el caso del despliegue, el efecto es aún más evidente: sin estructura, el agente leía configuraciones y se conectaba por SSH; con un CLAUDE.
md bien completado, pudo responder directamente desde el contexto sin ninguna llamada adicional. La conclusión importante es que un contexto mejor organizado mejora la velocidad y el ahorro de tokens, y también la precisión de la respuesta. ¿Por qué funciona mejor que el pipeline de RAG habitual?
Porque los archivos markdown ofrecen al agente latencia cero, previsibilidad y una actualización sencilla. Es el propio desarrollador quien define qué hay que saber del proyecto, en lugar de confiar en que el ranker extraiga del índice los chunks adecuados. Si cambia el despliegue o un servicio se traslada, basta con corregir una línea.
La escalabilidad también resulta razonable: el mapa de proyectos ocupa unos 2 KB, y quince archivos de proyecto de 5 KB suman menos de 80 KB de contexto estructurado, en lugar de cientos de kilobytes de código fuente en bruto. Con tanto debate sobre ventanas de contexto de millones de tokens, esto es especialmente relevante: más tokens no siempre significa mejor. La información irrelevante dispersa la atención del modelo, y el efecto lost in the middle sigue presente.
La principal conclusión del análisis es que el problema de los tokens en los agentes de programación casi siempre se resuelve no con modelos caros ni complicando el stack, sino con disciplina de contexto. Un mapa global de proyectos, un buen CLAUDE.md y una memoria de sesiones guardada se pueden montar literalmente en diez minutos, y el beneficio llega de inmediato: menos búsqueda a ciegas, menos repeticiones, menos errores y un camino más corto desde la pregunta hasta el archivo correcto.
- 1 nov 2026Los modelos locales pierden ante Opus y Codex: 0,21 puntos en un MacBook frente a 1,00 de Codex
- 1 nov 2026Kimi logra un 96,2 % en un test de analítica sobre una base de 1C y se perfila como plan B ante un bloqueo de Claude
- 1 nov 2026OpenAI reescribe las reglas de comportamiento de GPT: cinco valores y una cadena de prioridades
- 1 nov 2026Google admite que AI Mode reduce los ingresos de su buscador: las acciones caen un 15%
Build & Ship Production AI Agents Without Boilerplate Code
Start your free 72-hour trial at Hamidun Academy (academy.hamidun.com) — interactive lessons on Claude Code & Cursor, live Tech Radar, and production agent templates.
Lo esencial de la IA — una vez por semana
Siete historias que de verdad importaron, elegidas a mano. Sin ruido ni notas de prensa.
¡Listo! Revisa tu correo para la confirmación.