Habr AI
Fuente de noticias de IA. Los artículos son seleccionados y adaptados por la redacción de Hamidun News.
Últimas publicaciones
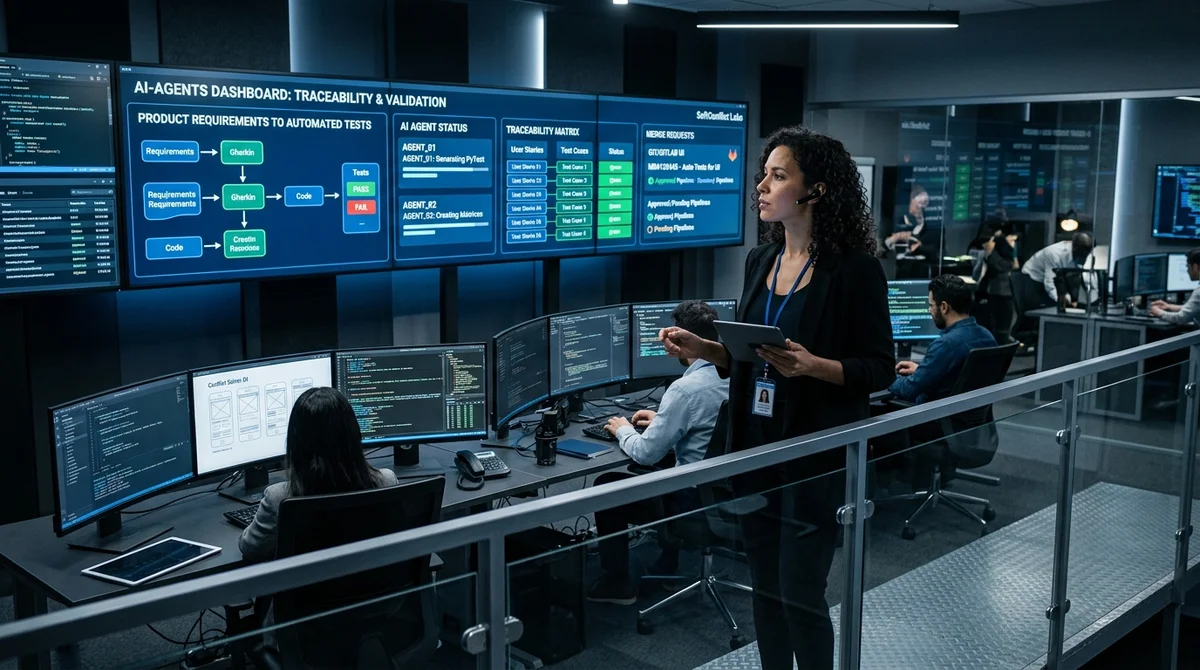
Claude Code y 11 agentes: cómo un equipo de QA automatizó hasta el 80 % de la rutina de pruebas
Un equipo de QA montó un sistema de 11 agentes de IA sobre Claude Code que convierte una tarea de Jira en casos de prueba, autotests y Merge Request en horas en lugar de días.
Por qué los LLM mienten y olvidan datos: cómo funciona la memoria de los modelos de lenguaje
Los modelos de lenguaje no guardan datos como una base de datos: generan texto verosímil. Repasamos cuatro razones por las que los LLM alucinan y olvidan.
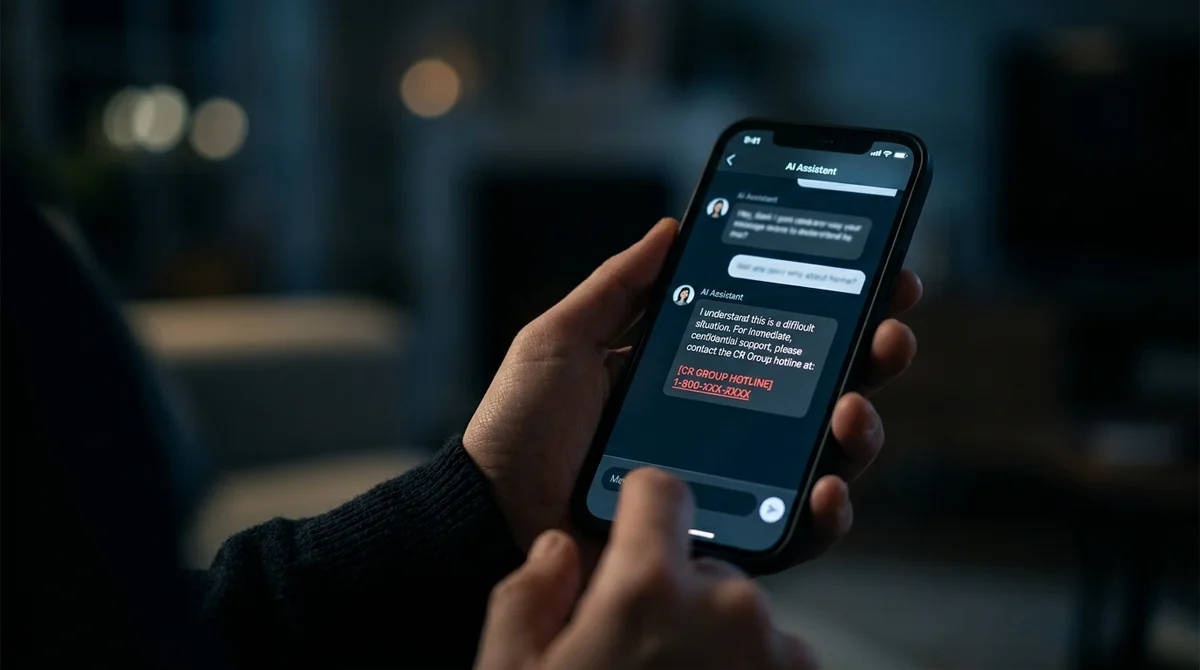
Un LLM inventó un teléfono de ayuda: por qué un prompt no evita las alucinaciones
Un modelo de lenguaje dio a una joven en situación de maltrato el número de una línea infantil en lugar del de un centro de crisis. La prohibición en el prompt no sirvió: hay que cambiar la arquitectura.
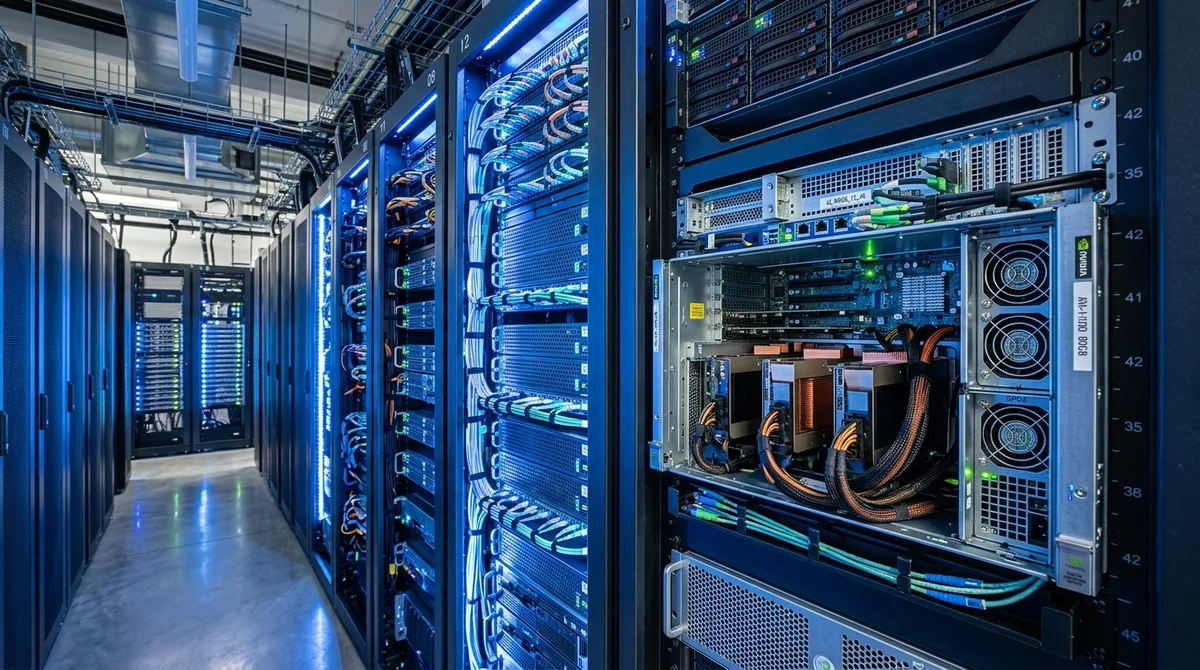
T1 Oblako: H200 y L40S, análisis técnico de GPU para tareas de IA generativa
T1 Oblako publicó un análisis técnico de sus servidores GPU H200 y L40S, con fotos de su centro de datos, y explicó cómo elegir el acelerador adecuado para cada tarea de IA.

NVIDIA Nemotron 3 Super 120B: prueba con tareas analíticas reales en una sola GPU
El equipo de Luxms BI probó durante una semana NVIDIA Nemotron 3 Super 120B en tareas reales de analítica corporativa: 120B de parámetros y 256K tokens de contexto en una sola tarjeta gráfica.
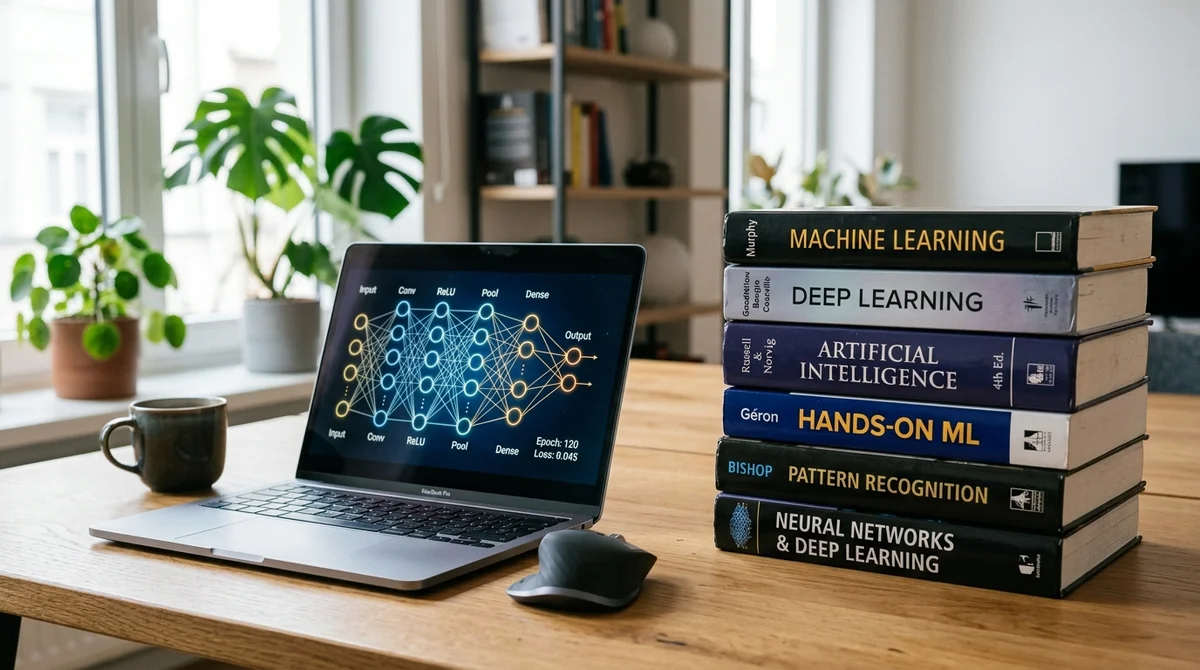
El best seller internacional sobre grandes modelos de lenguaje llega en ruso
La editorial BHV publica en ruso un best seller internacional sobre LLM: una guía práctica para desarrolladores que necesitan entender y aplicar modelos de lenguaje en proyectos reales.

PSB muestra cómo implanta la IA en el banco: chatbots, RAG y servicios para empresas
PSB detalla cómo usa IA generativa para pymes y empleados: el asistente Katyusha, consultas con RAG, pagos en mensajerías y pilotos internos para ventas.
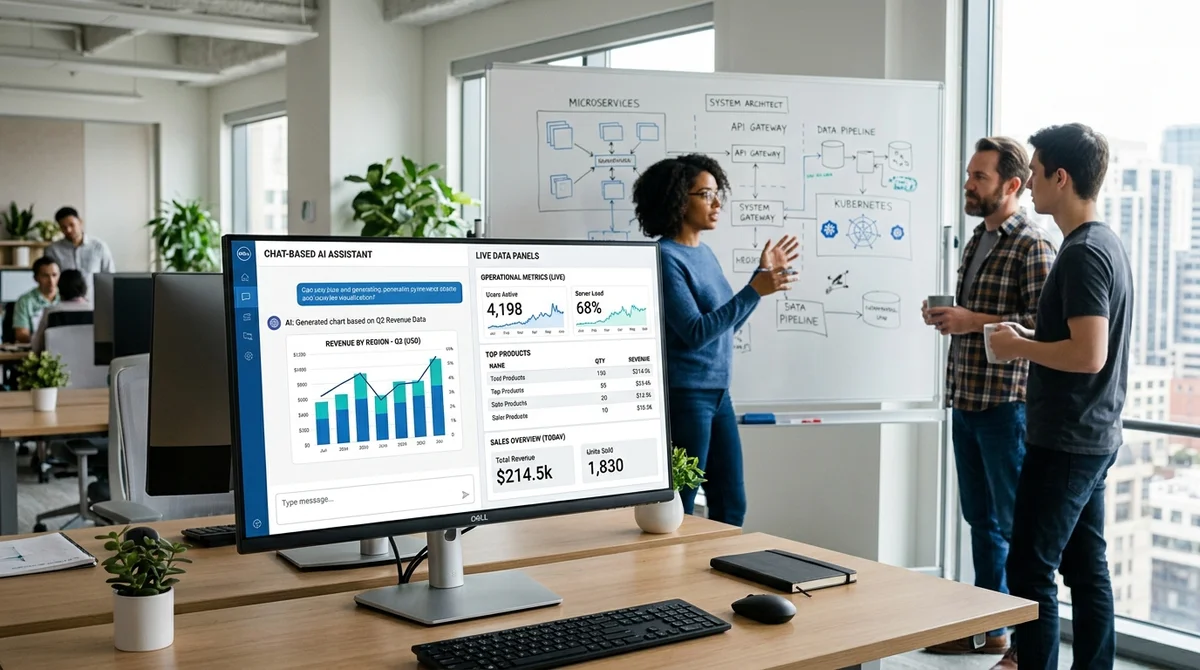
Yandex Cloud explica por qué el frontend lidera la integración de redes neuronales en DataLens en su fase inicial
Con el caso de DataLens, Yandex Cloud muestra cómo llevar la primera capa de integración de IA a un BFF del frontend para lanzar antes un asistente de chat y gestionar el contexto más cerca de la interfaz.
Claude Code en Windows: cómo montar un entorno de trabajo estable y rápido
Un ingeniero de un equipo de AWS con más de 150 cuentas explica cómo lograr que Claude Code funcione de forma estable y rápida en Windows sin pasarse a Linux, con ajustes de abril de 2026.
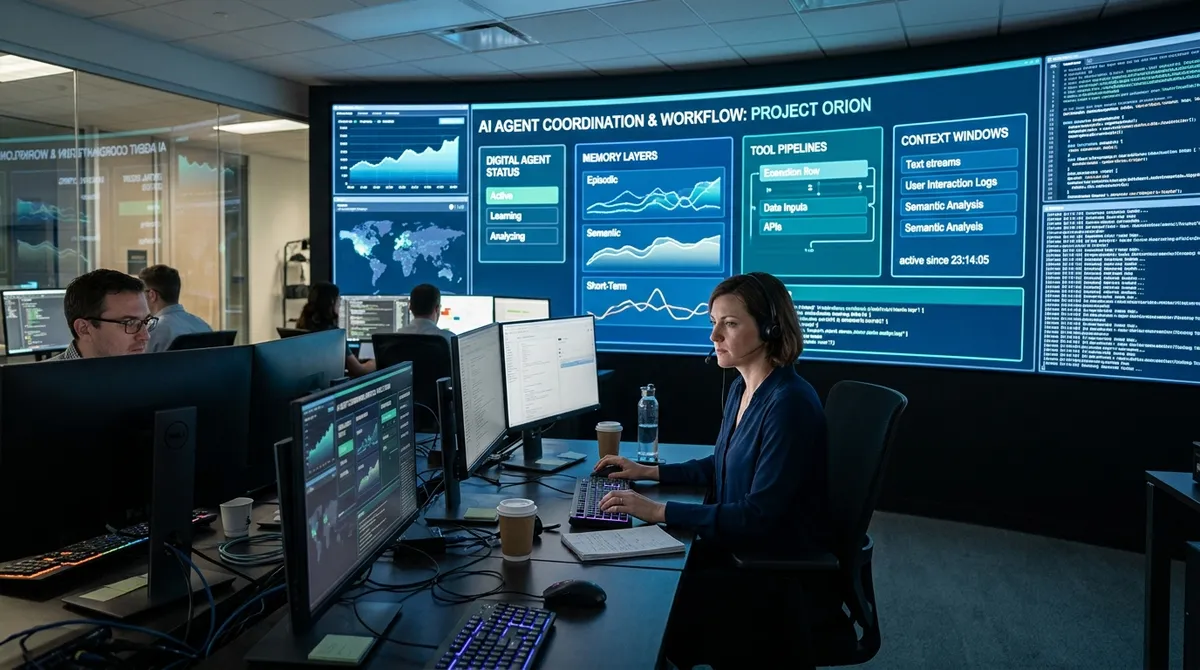
Anthropic, OpenAI y LangChain explican por qué los agentes de IA necesitan un harness
Anthropic, OpenAI y LangChain desplazan el foco de los modelos al agent harness: la capa de orquestación, memoria y herramientas que mantiene estables a los agentes de IA en producción.
Anthropic y otros modelos de lenguaje pueden invocar herramientas ocultas sin permiso
Un investigador describe cómo Anthropic, Gemini y Grok pueden invocar una herramienta no autorizada si existe en el entorno y la API o el cliente validan mal su nombre.
El grupo fintech Svoi explica cómo hacer que los agentes LLM sean más baratos y precisos al programar
El grupo fintech Svoi publicó una guía práctica para convertir un LLM de un "buscador mejorado" en un agente controlable, reducir el gasto en tokens y mejorar la precisión del código generado.
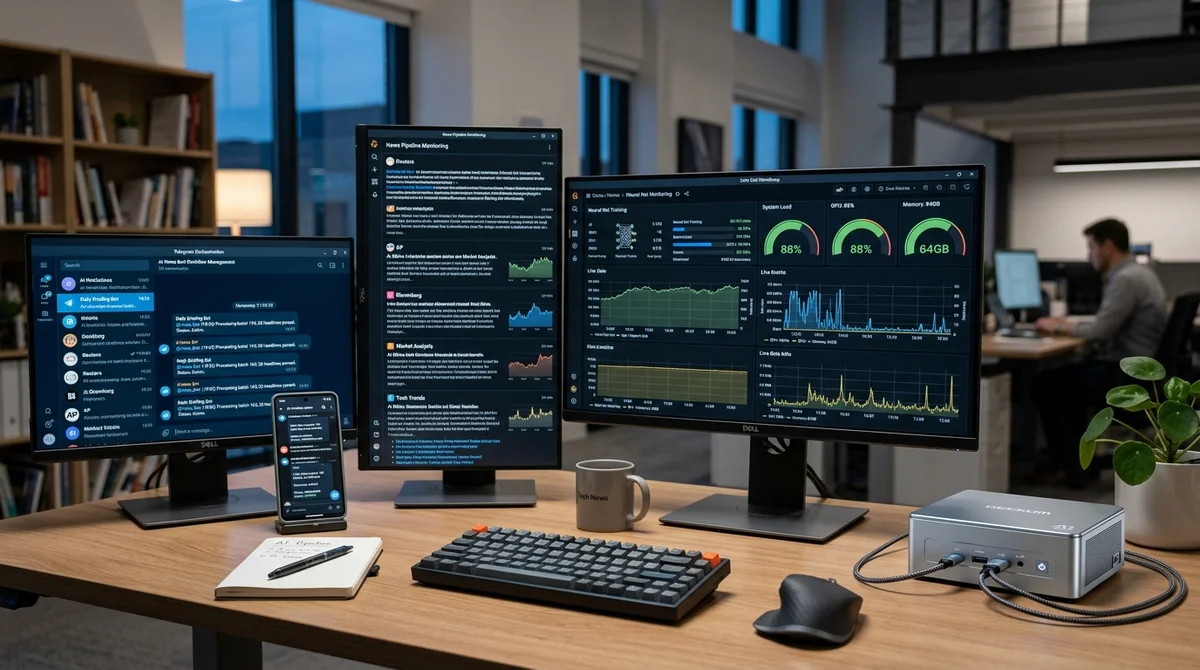
Cómo un autor de Habr convirtió siete flujos de n8n en un sistema autónomo de noticias de IA
En mes y medio, el autor transformó un frágil conjunto de siete flujos de n8n en un único pipeline en Python con 11 workers, 5 agentes de IA, un LLM local y control por Telegram.
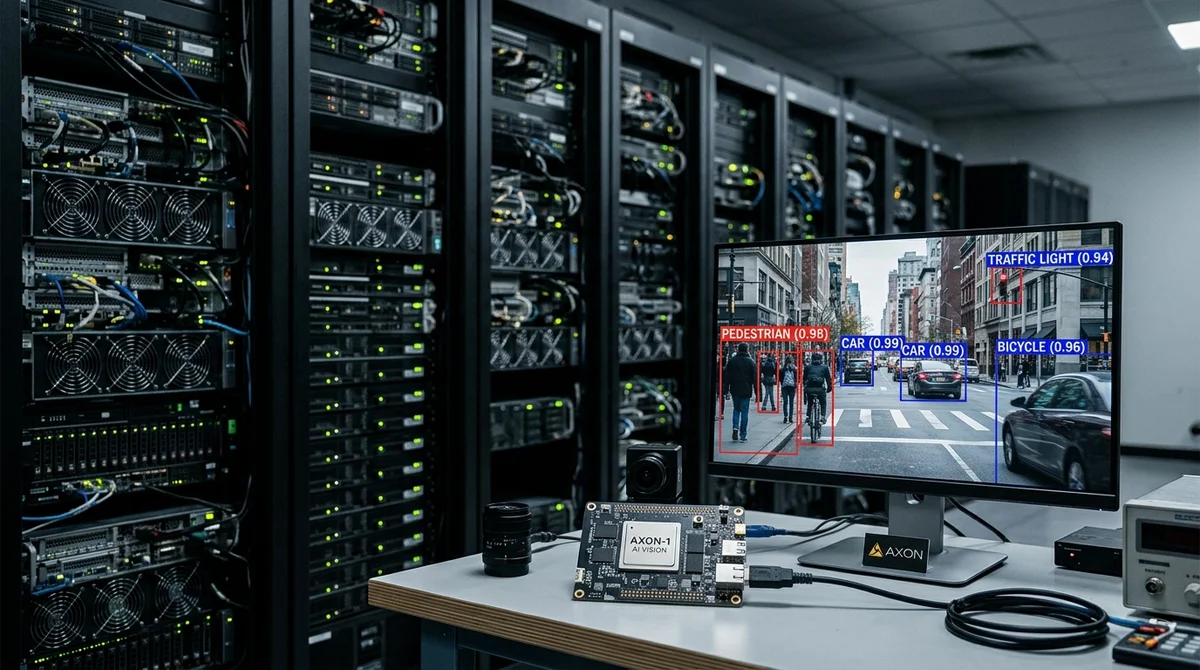
TAPe iguala a RF-DETR y YOLO en detección sobre COCO con un modelo de menos de 100.000 parámetros
Los autores de TAPe afirman que su detector alcanza el nivel de RF-DETR y YOLO en COCO con menos de 100.000 parámetros y 7–8 ms por fotograma, reduciendo datos y hardware.
Por qué OpenCode y los modelos potentes escriben tests en verde pero inútiles, y cómo arreglarlo
Un modelo reciente y un agente potente como OpenCode no bastan si el código está lleno de any y el equipo pide a la IA que escriba tests sin especificación, límites ni verificación.
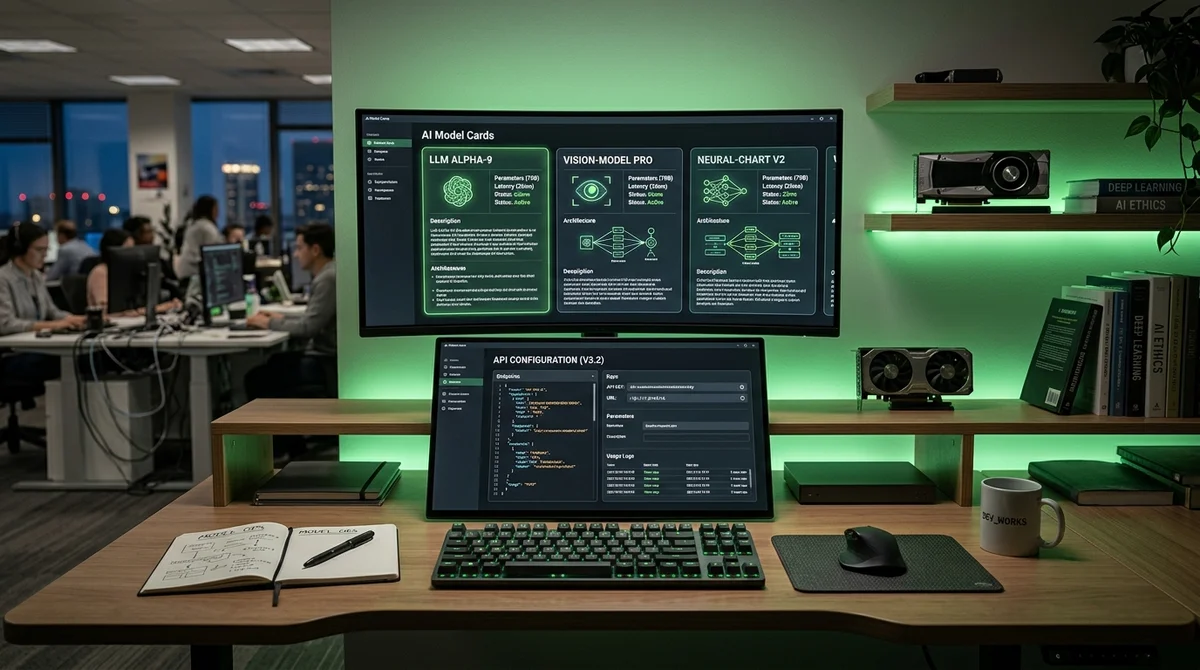
NVIDIA abre una API gratuita a más de 100 modelos de IA con acceso compatible con OpenAI
NVIDIA entrega claves gratuitas a más de 100 modelos de IA: los desarrolladores obtienen una API compatible con OpenAI, un límite de 40 solicitudes por minuto y acceso sin tarjeta bancaria.
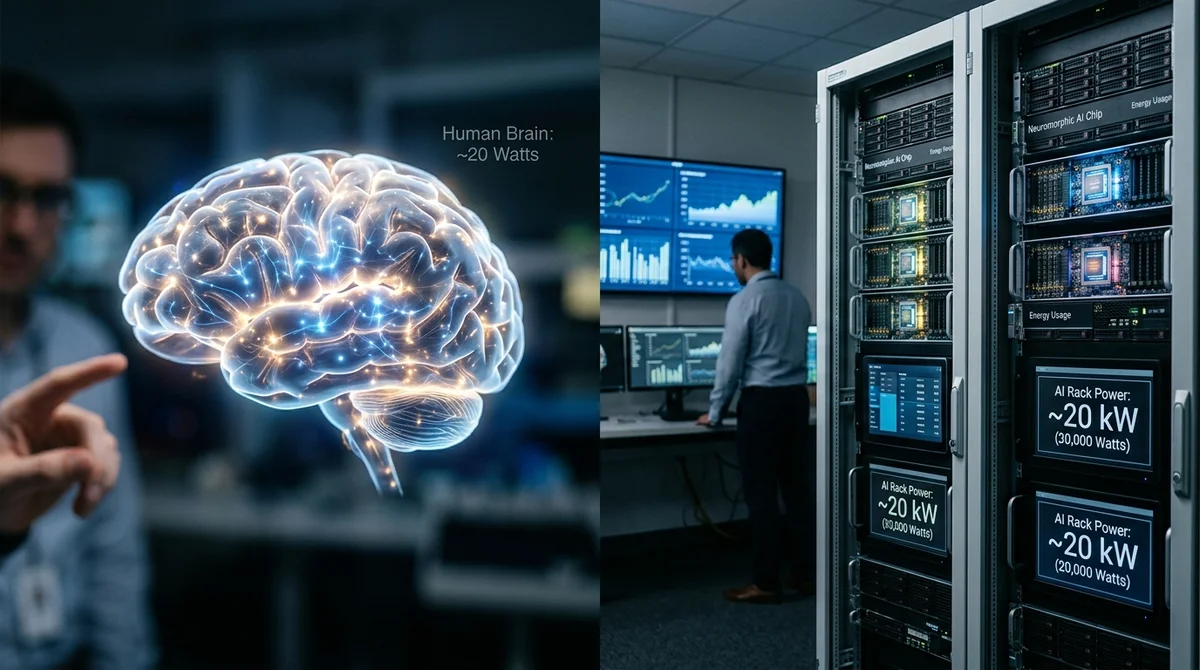
Por qué el cerebro es cientos de millones de veces más eficiente que GPT-4 y hacia dónde van los chips neuromórficos
El autor analiza por qué el cerebro humano gasta órdenes de magnitud menos energía que GPT-4 en tareas cognitivas y cómo los chips neuromórficos intentan reducir esa brecha.
Estudio sobre ChatGPT: ¿influye la forma femenina del prompt en la calidad con la que resuelve tareas?
Un experimento propio en LiveCodeBench mostró que, en GPT-5.4 mini, presentarse en femenino en un prompt en ruso reduce ligeramente el pass@1, sobre todo en tareas difíciles.
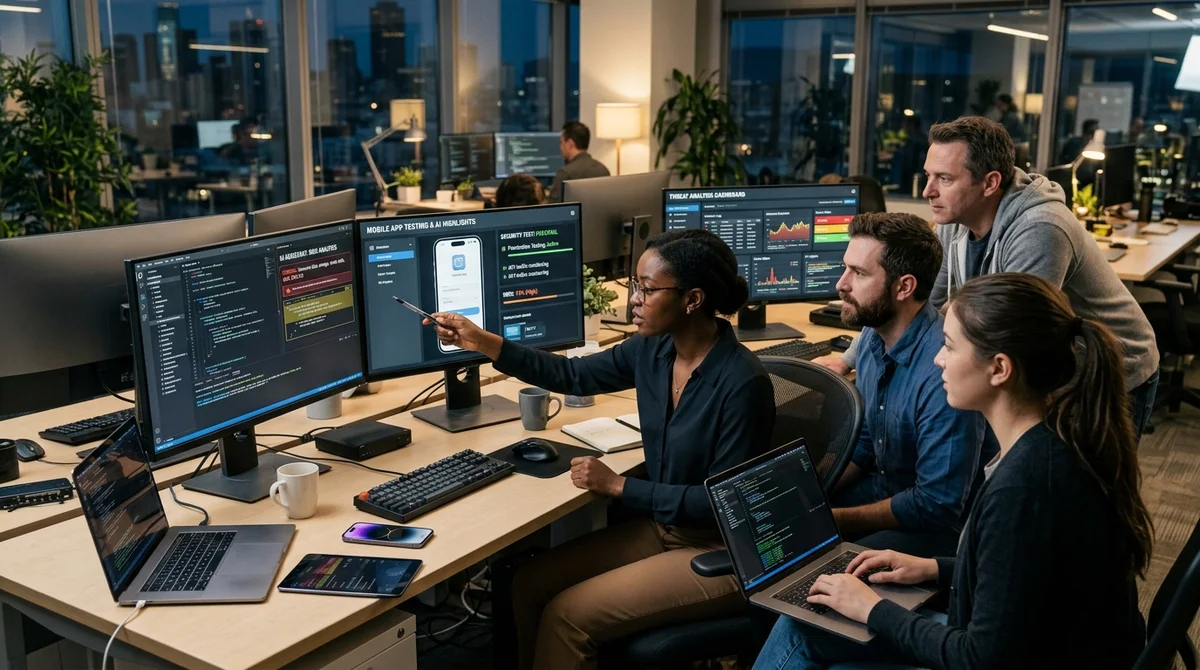
RuStore incorpora IA a la seguridad informática: cómo VK automatiza la revisión de tareas, código y pruebas DAST
El equipo de seguridad de RuStore usa IA para el primer análisis de tareas de seguridad, la revisión de merge requests y las pruebas dinámicas, para liberar a los ingenieros de la rutina y acelerar el ciclo de lanzamient
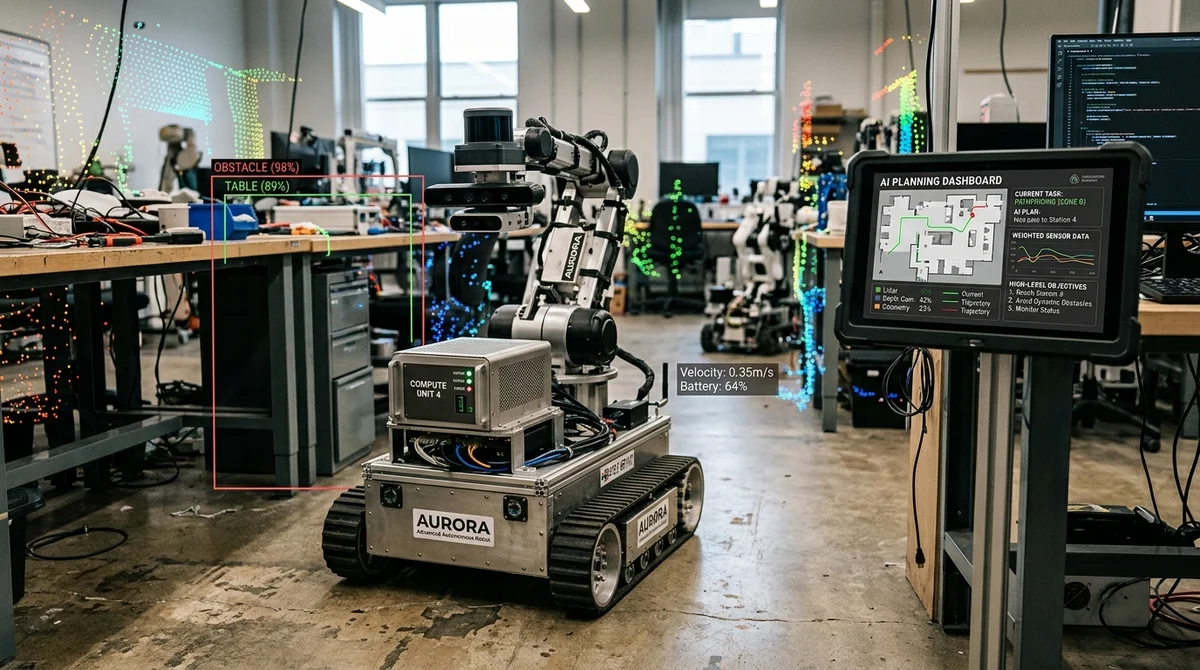
OpenGrall presenta una arquitectura para robots con IA en la que el modelo de lenguaje se encarga de la estrategia
El framework OpenGrall separa pensamiento y control: el LLM define la estrategia y TinyML se ocupa de la ejecución y la seguridad, reduciendo la latencia incluso en hardware modesto.
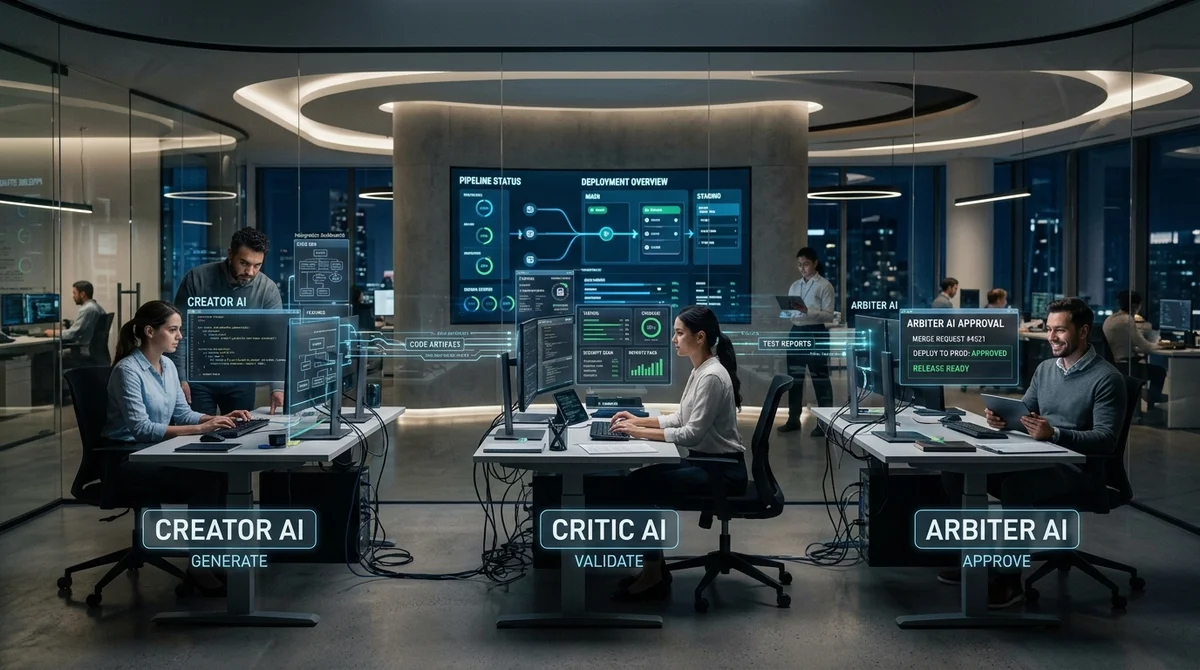
Habr AI: cómo Pipeline Triad monta un pipeline de agentes de IA en lugar de un equipo de desarrollo
Habr AI analiza Pipeline Triad, un modelo en el que las etapas de desarrollo pasan por tríos de agentes de IA y una persona interviene solo en cuatro puntos de control.
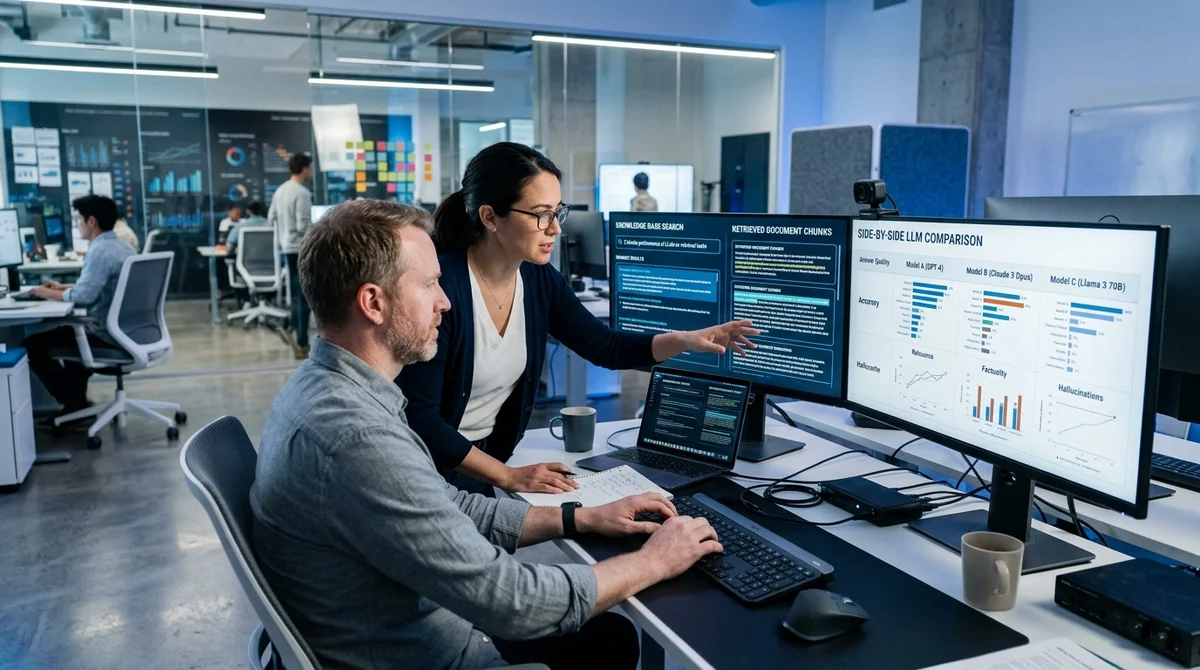
Gramax muestra cómo comparar la calidad de las respuestas de RAG sin evaluarlas «a ojo»
Gramax explica por qué las métricas de recuperación no bastan en RAG y propone evaluar la respuesta final del usuario, no los chunks hallados, por completitud, precisión y estabilidad.
Guardrails para LLM en Java: cómo bloquear inyecciones de prompt y respuestas tóxicas
Por qué un system prompt no basta para proteger un LLM y cómo los guardrails en Java interceptan entradas peligrosas y filtran salidas tóxicas o no deseadas.
Anthropic y el modelo Mythos: por qué el peligro para los bancos se convirtió rápido en un riesgo para todos
Anthropic presentó Mythos como un modelo demasiado peligroso para el acceso abierto, pero el mayor riesgo no está en los bancos: la pequeña empresa no llega a cerrar vulnerabilidades antes de los ataques.
Anthropic y Claude Mythos: por qué los críticos ven en el lanzamiento del modelo un costoso montaje de relaciones públicas
Una columna crítica sostiene que Anthropic vende con Claude Mythos un modelo de IA y también el mito de su naturaleza casi humana, para avivar la escasez y la demanda corporativa.
Asistentes de IA en 2026: cómo un desarrollador en solitario se volvió más rápido que un equipo de tres personas
El autor muestra que en 2026 un solo desarrollador con herramientas de IA open source puede escribir, probar y hacer commit de código más rápido que un pequeño equipo dos años atrás.
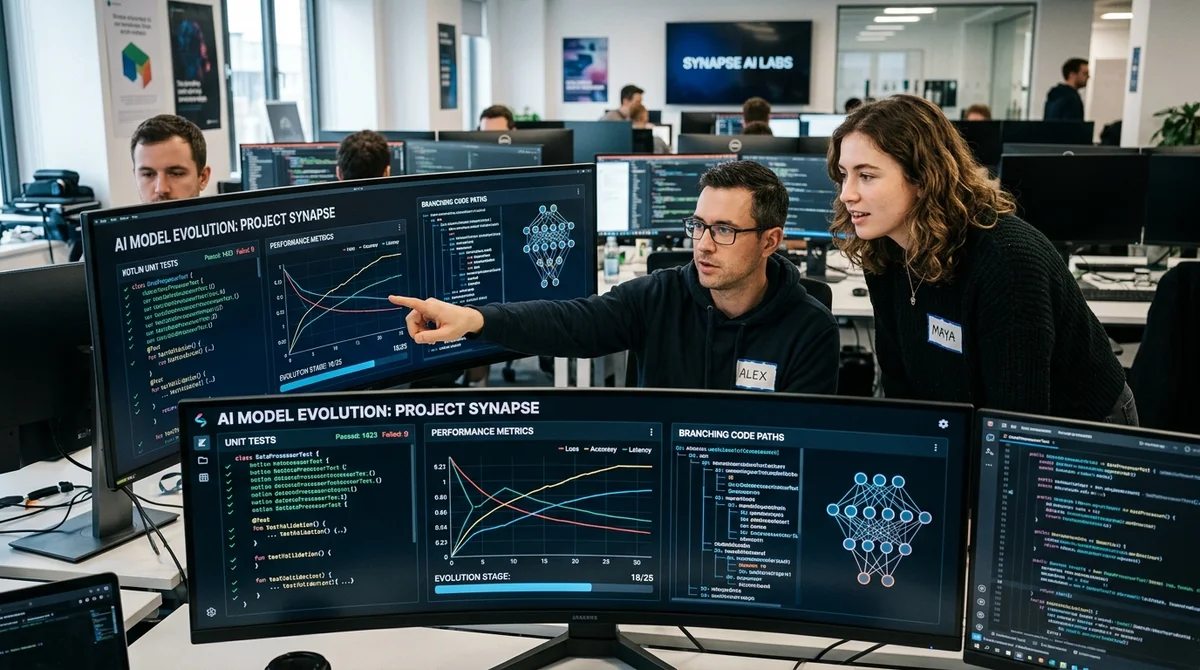
ecom.tech compara el ajuste evolutivo de Qwen3-4B con SFT y GRPO en pruebas para Kotlin
ecom.tech ajustó Qwen3-4B-Instruct para generar pruebas unitarias en Kotlin y comprobó que un algoritmo evolutivo supera a SFT y GRPO en calidad, pero deteriora las capacidades generales del modelo.
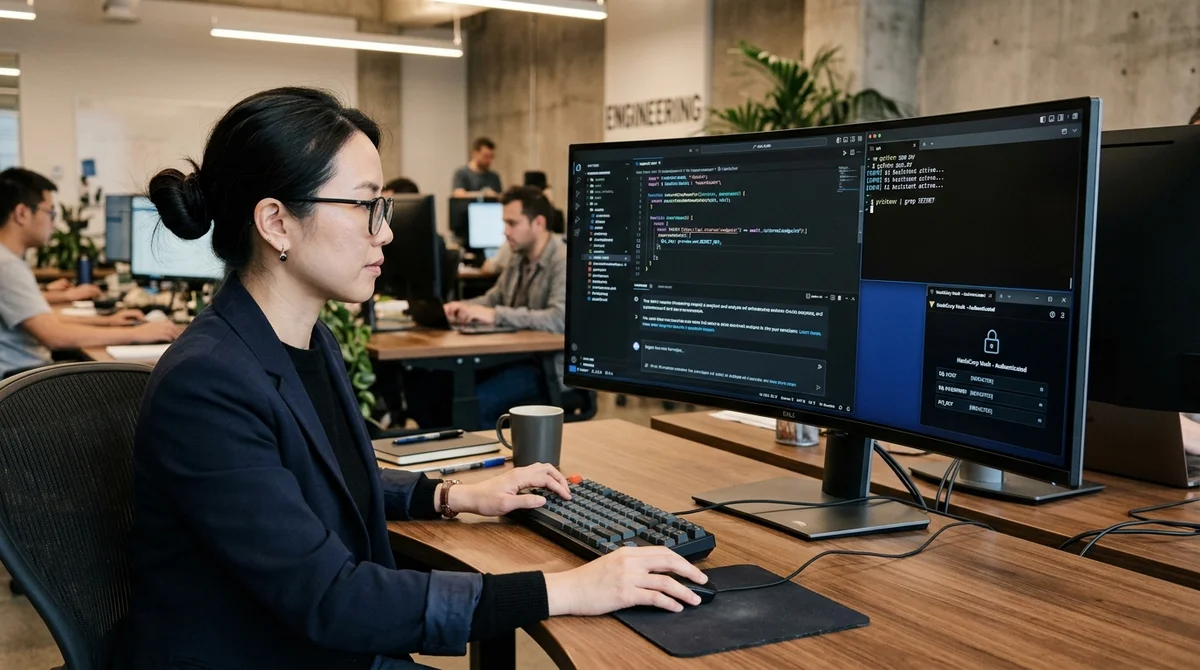
Yandex Code Assistant, probado con una tarea de secretos y comparado con Cursor
Un ingeniero de Infosystems Jet probó Yandex Code Assistant en una tarea de almacenamiento de secretos: el agente se acerca a Cursor, pero aún requiere supervisión del desarrollador.
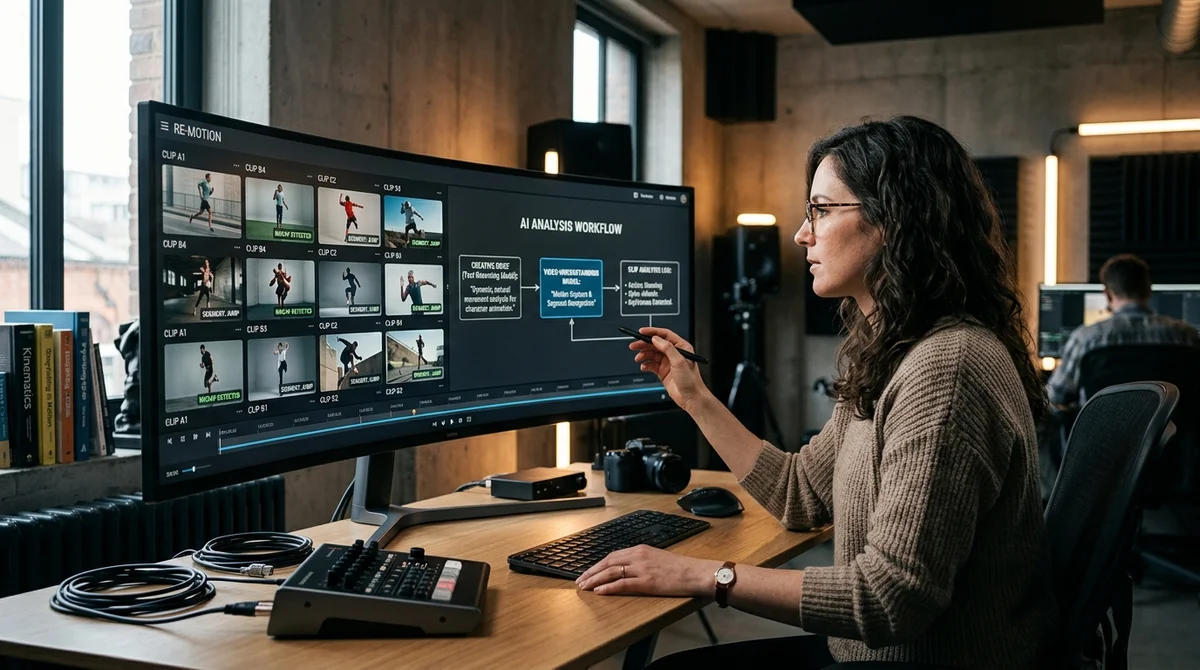
Claude y Qwen Omni: cómo un desarrollador conectó el análisis de vídeo a un flujo de trabajo real
Un autor de Habr combinó Claude con Qwen Omni para sortear la falta de soporte directo de vídeo y clasificar automáticamente 29 referencias de animación por movimiento y categoría.
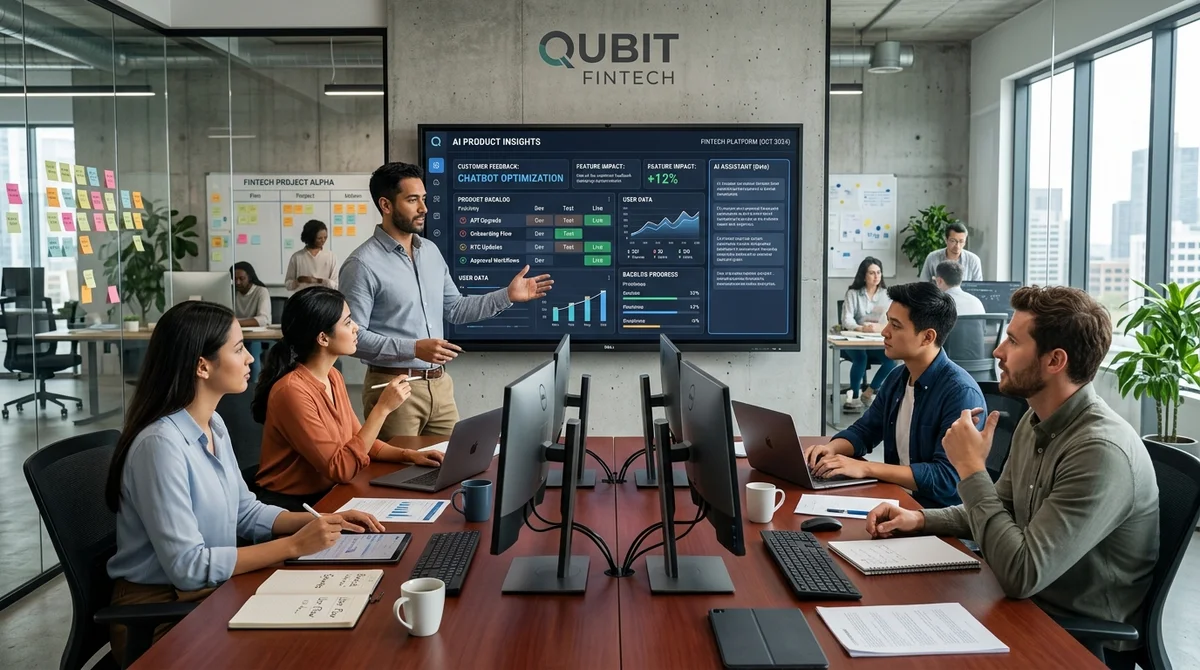
Cómo Sovcombank redujo un 50% la rutina de su equipo de producto con un asistente de IA
Sovcombank creó un asistente de IA basado en un LLM y un único prompt para quitar a los product managers la documentación, las aprobaciones y parte del análisis, liberando hasta la mitad de su tiempo.