Un LLM inventó un teléfono de ayuda: por qué un prompt no evita las alucinaciones
Un bot basado en un LLM detectó señales de maltrato emocional en la conversación de una usuaria y le aconsejó llamar a un «teléfono de ayuda». El número resultó ser el de una línea infantil: el modelo se lo inventó. La regla del prompt «no inventes contactos» no funcionó, porque el afán de ser útil pesa más que cualquier instrucción. La solución no es reescribir el prompt, sino cambiar la arquitectura: guardar los contactos en una base de datos y recuperarlos mediante RAG o llamadas a funciones.
Procesado por IA desde Habr AI; editado por Hamidun News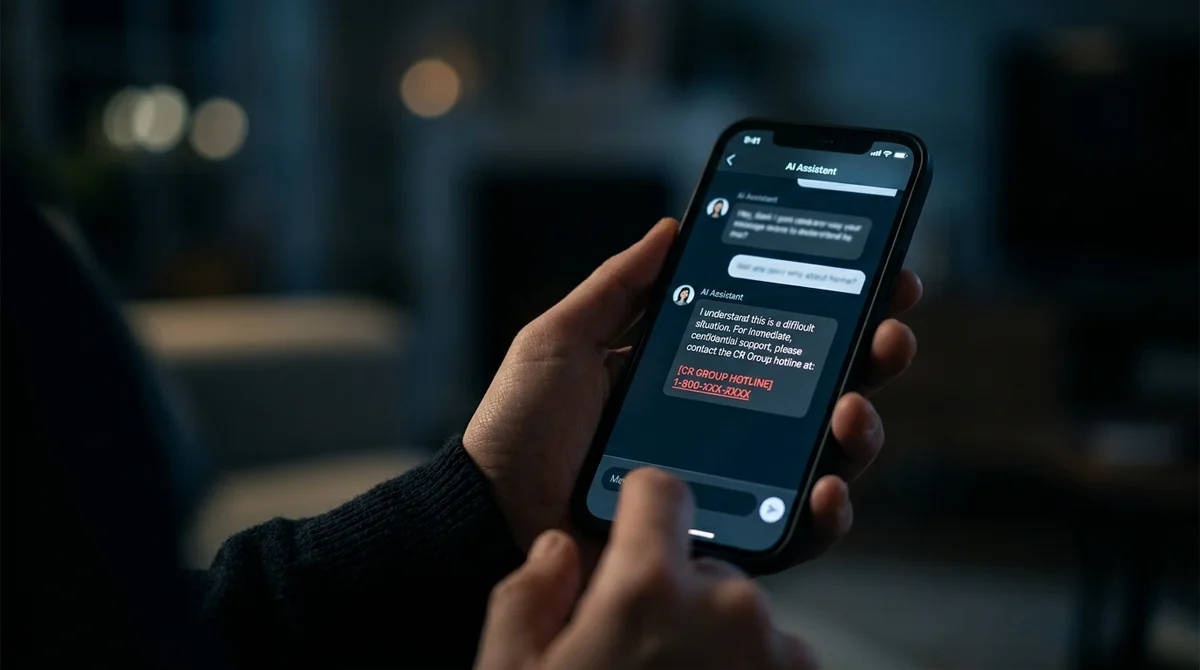
Un bot basado en un LLM detectó señales de alarma en una conversación y recomendó llamar a un teléfono de ayuda. El número resultó ser de una línea infantil: el modelo se lo inventó. El prompt contenía una prohibición explícita: «no inventes datos de contacto». No sirvió. No es un fallo que se arregle con palabras mágicas. Es un problema de arquitectura.
El escenario es real e inquietante. Una joven envía al bot su conversación con su novio. El modelo reconoce los patrones: presión emocional, aislamiento, manipulación (gaslighting). Reacciona como un asistente atento: sugiere buscar ayuda profesional y da un número concreto. Todo parece lógico salvo una cosa: el número pertenece a una línea telefónica infantil. El modelo generó una cadena de dígitos verosímil porque es lo que mejor sabe hacer: predecir lo que parece apropiado.
El problema no es la mala intención ni un prompt mal escrito. Los modelos de lenguaje se entrenan para predecir el siguiente token de modo que el resultado parezca lo más útil y apropiado posible en ese contexto. Cuando el contexto pide datos de contacto, el modelo los genera. La instrucción «no te inventes nada» compite con el comportamiento aprendido de miles de millones de parámetros ajustados para la utilidad (helpfulness) mediante RLHF. En esa pugna, el prompt casi siempre pierde. El deseo del modelo de ser útil resulta más fuerte que cualquier prohibición verbal.
Esto tiene una consecuencia concreta para los productos: si tu servicio depende de un LLM para entregar datos críticos (teléfonos, direcciones, nombres de especialistas, referencias legales), estás construyendo sobre una base poco fiable. La alucinación no es una excepción, sino algo inherente al modelo. Cuanto más «atento» lo haces, más fuerte es el impulso de responder aunque no tenga información fiable.
¿Qué funciona en lugar del prompting?
El desacoplamiento arquitectónico. Los contactos se guardan en una base de datos verificada, no en los pesos del modelo. El LLM reconoce la intención del usuario y llama a una función o lanza una consulta RAG: obtiene un número concreto de una fila concreta de una tabla. El modelo no genera dígitos, los recupera. La diferencia es fundamental.
La llamada a funciones (function calling, tool use) resuelve la tarea directamente. Se describe una herramienta, get_crisis_contact(region, type), y cuando la intención coincide, el modelo la invoca en lugar de fantasear. La respuesta sale de la base de datos, no de una distribución de probabilidad de tokens. Un patrón similar es RAG con un formato de respuesta estricto: si no se encuentra el documento, el modelo debe decirlo explícitamente en vez de inventar.
La segunda capa de protección es la validación de la salida. Antes de entregar cualquier dato de contacto al usuario, hay que comprobarlo: si el número figura en una lista blanca verificada, si el formato es correcto, si sigue vigente. No da una garantía del 100 %, porque la base también hay que mantenerla, pero es un orden de magnitud más fiable que una instrucción en el prompt.
El tercer patrón es separar explícitamente en la arquitectura los tipos de conocimiento. Hay conocimiento que el modelo puede generar libremente: tono, estructura, empatía, interpretación de la situación. Y hay conocimiento que nunca debe generar: números concretos, direcciones, recomendaciones médicas, datos con valor legal. La arquitectura debe excluir físicamente lo segundo: no pedirle al modelo que se abstenga, sino no darle esa posibilidad.
El ejemplo del teléfono de ayuda es revelador precisamente porque lo que está en juego es mucho. Una persona en crisis recibe un número equivocado. No es una molestia: es un daño potencial. En producción hay muchos más escenarios así de lo que se suele admitir: asesoría legal, informes médicos, datos financieros, recomendaciones de especialistas. En todos hay un bot LLM que quiere ayudar sinceramente y que, sin embargo, no tiene acceso a información verificada.
La conclusión es sencilla: el prompting no es control, es un deseo. Si un comportamiento es crítico para la seguridad del usuario, saca los datos concretos del control generativo del modelo. Dale funciones, bases de datos y herramientas. Que entienda el contexto e interprete la intención, pero que no invente hechos. Eso es arquitectura, no un conjunto de palabras mágicas en el system prompt.
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
Lo esencial de la IA — una vez por semana
Siete historias que de verdad importaron, elegidas a mano. Sin ruido ni notas de prensa.
¡Listo! Revisa tu correo para la confirmación.