Claude y Qwen Omni: cómo un desarrollador conectó el análisis de vídeo a un flujo de trabajo real
Un desarrollador ha mostrado cómo convertir Claude en una herramienta práctica para analizar vídeo conectándolo con Qwen Omni. En lugar de trocear el vídeo en fotogramas, donde se pierde el movimiento, la combinación de modelos describió y clasificó automáticamente 29 referencias de animación de un personaje. La idea práctica es sencilla: la sólida lógica de Claude se puede complementar con una capa multimodal externa y ahorrarse entre una hora y hora y media de rutina manual.
Procesado por IA desde Habr AI; editado por Hamidun News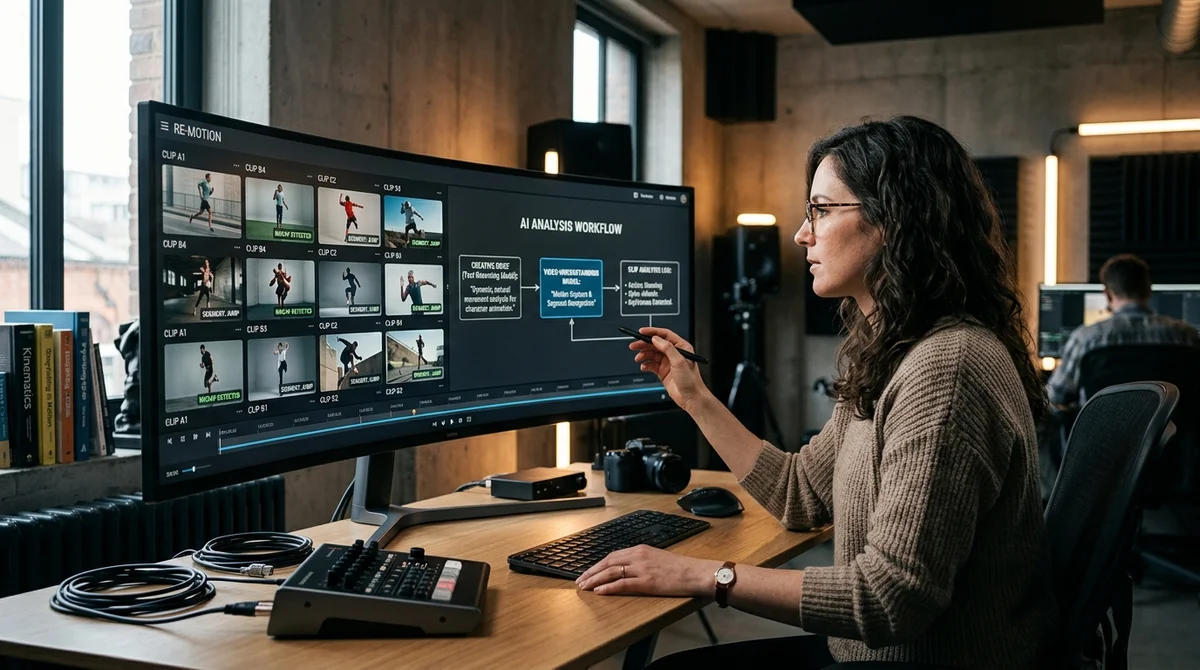
En una nueva publicación en Habr, un desarrollador muestra una forma sencilla pero útil de ampliar las capacidades de Claude en tareas que exigen analizar vídeo y no imágenes sueltas. En vez de esperar a que Anthropic ofrezca soporte nativo para vídeos, montó una cadena de dos modelos: Qwen Omni se encarga de la percepción multimodal, mientras que Claude analiza, estructura y redacta el resultado. En la práctica, esto convirtió una tarea manual tediosa en un flujo automatizado que ahorra tiempo y conserva mejor el contexto del movimiento.
El problema al que se enfrentó le resultará familiar a cualquiera que trabaje con animación, motion graphics y referencias visuales. Si se corta un vídeo en fotogramas y se envían al modelo uno a uno, se pierde lo esencial: la relación entre estados, el ritmo, la trayectoria de la cámara, las transiciones entre poses y el dibujo general de la acción. En escenas estáticas, este rodeo aún es tolerable, pero para analizar movimiento pronto choca con sus límites.
Para tareas como desglosar técnicas de cámara, sincronizar gestos, seguir cambios de plano y evaluar el diseño final de un personaje, ese compromiso resulta casi inútil. El modelo ve un conjunto de imágenes y no un acontecimiento completo, y la persona sigue teniendo que reconstruir el sentido a mano.
La tarea concreta era totalmente práctica: en la carpeta del proyecto había 29 referencias de vídeo generadas de animación de un personaje, que había que repartir por categorías y describir brevemente en cuanto a movimiento. Hacerlo a mano habría costado al autor alrededor de una hora u hora y media, y en un trabajo de poco valor añadido: abrir el archivo, verlo, identificar el tipo de movimiento, anotar la descripción y pasar al siguiente. Para los profesionales creativos, esta rutina es especialmente dolorosa, porque consume tiempo no en crear, sino en inventariar material ya creado.
La solución llegó con Qwen Omni, que el autor ya usaba en otro proyecto: un asistente digital con forma de personaje que funciona en tiempo real. La idea resultó lógica: si un modelo comprende bien la entrada multimodal y otro destaca en la interpretación y en generar texto cuidado, se pueden unir en un único flujo de trabajo. En este esquema, Qwen Omni recibe primero el vídeo y extrae de él rasgos relevantes y una descripción de lo que ocurre; después Claude usa ese material como base para una categorización más cómoda, comparaciones y conclusiones en texto.
A partir de ahí se pueden obtener no solo un resumen en bruto, sino descripciones homogéneas, listas, etiquetas y breves conclusiones de cada clip de la carpeta. No se trata de una transformación «mágica» de Claude en un modelo de vídeo completo, sino de una composición práctica de herramientas especializadas.
Desde el punto de vista de la ingeniería, lo importante es el enfoque. En lugar de buscar un modelo universal para todas las tareas, el autor monta una pila de componentes con distintas especialidades. Para los usuarios, esto supone un camino más realista hacia la multimodalidad: en vez de esperar a que su LLM favorito aprenda todo a la vez, se le añaden sensores externos y capas intermedias.
Este patrón es especialmente útil cuando se valora no solo el reconocimiento, sino también el razonamiento posterior: análisis de escenas, descripción del comportamiento de un personaje, identificación de patrones de movimiento típicos, preparación de notas para producción o para la comunicación dentro del equipo. Con el mismo esquema se pueden analizar storyboards, vídeos formativos, grabaciones de interfaces y generaciones de prueba antes del montaje.
La historia de Claude y Qwen Omni muestra que la limitación de un modelo no siempre significa un callejón sin salida para todo el proceso. Si se divide la tarea en etapas (percepción, descripción, clasificación y conclusión), queda claro qué parte puede cubrir ya una herramienta externa. Para los creadores de contenido visual, animadores y artistas de IA, es una buena señal: el valor nace cada vez más no de un único modelo «más inteligente», sino de una cadena bien montada en la que cada sistema hace aquello en lo que realmente destaca.
- 2 nov 2026Karpathy montó en dos horas un clon de YouTube con 6454 vídeos recomendados en Hacker News
- 2 nov 2026Karpathy usó Claude para crear HackerTube, con 6454 vídeos recomendados en Hacker News
- 2 nov 2026Arca encarga a agentes de IA tareas financieras de hasta 10 días y deja las operaciones en manos de personas
- 2 nov 2026Anthropic debe aumentar sus ingresos un 32% al año para cubrir contratos por $850 mil millones
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
Lo esencial de la IA — una vez por semana
Siete historias que de verdad importaron, elegidas a mano. Sin ruido ni notas de prensa.
¡Listo! Revisa tu correo para la confirmación.