Cómo un autor de Habr convirtió siete flujos de n8n en un sistema autónomo de noticias de IA
Un desarrollador ha mostrado cómo, en mes y medio, convirtió un frágil pipeline de noticias basado en siete workflows de n8n en un sistema de IA casi autónomo. En lugar de supervisión manual, ahora funcionan 11 workers, 5 agentes, un LLM local y un orquestador en Telegram. La base de datos ya contiene 7127 registros y el sistema consume 160 fuentes únicas sin intervención constante. La idea central es abandonar un conjunto de automatizaciones dispersas y pasar a un único sistema gestionable al que se le pueden asignar tareas directamente desde un chat.
Procesado por IA desde Habr AI; editado por Hamidun News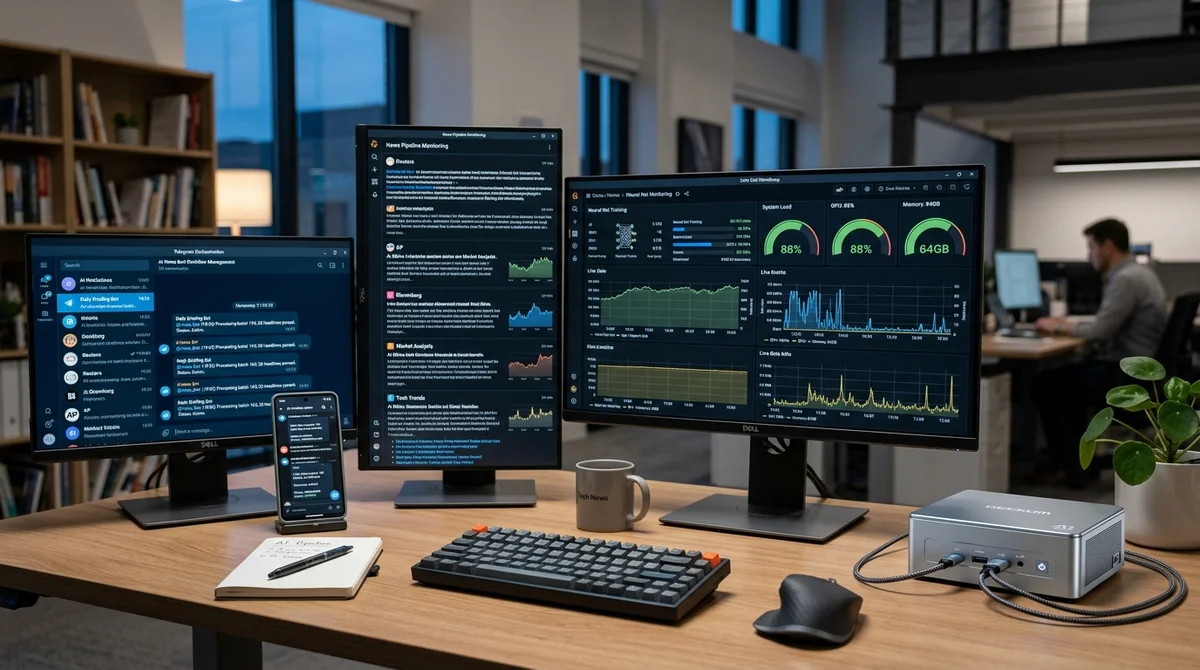
La historia muestra cómo un frágil montaje no-code puede convertirse en pocas semanas en un sistema editorial completo: el autor abandonó siete flujos independientes en n8n y construyó un único pipeline en Python que recopila, filtra, traduce, da formato y publica noticias de IA casi sin intervención manual.
El punto de partida fue el caos clásico de las automatizaciones. Cada workflow de n8n se encargaba de una etapa: recopilación de noticias, limpieza de duplicados, traducción, preparación de imágenes y publicación. Formalmente todo funcionaba, pero cualquier error se convertía en una larga búsqueda del fallo: un flujo podía terminar «con éxito» sin producir nada, y toda la cadena se venía abajo. En algún momento el autor entendió que el problema principal no estaba en las funciones concretas, sino en la arquitectura: siete procesos suponían siete puntos de fallo distintos y una observabilidad casi nula.
Construyó la nueva versión como un único proyecto. Según él, las herramientas de IA aceleraron la transición: Cursor participó en la configuración del minipc doméstico y la infraestructura local, Perplexity en la discusión de decisiones de arquitectura, y Claude Code ayudó a trasladar el conjunto de workflows a Python y a desplegar un servicio en contenedores.
Así surgió un pipeline en el que 11 workers hacen una sola tarea cada uno. La cadena básica es esta: collector recopila datos de RSS y API de unas 160 fuentes cada 15 minutos, scraper obtiene el texto completo, deduplicator elimina duplicados semánticos, ai_filter evalúa la relevancia, translator traduce los materiales al ruso, llm_editor adapta los textos al estilo necesario, image_worker encuentra o genera ilustraciones y publisher publica los posts según un calendario. Además hay procesos en segundo plano para buscar repositorios de GitHub, trabajar con vídeo y moderar manualmente.
Se hace especial hincapié en el modelo local. En lugar de pagar de forma continua por API en la nube para traducir, el autor trasladó esta tarea a un minipc doméstico con Qwen 3.5, ejecutado mediante llama.cpp y optimizado para Vulkan. Eso resolvió dos problemas a la vez: redujo el coste de procesar un gran volumen de noticias y mantuvo los datos dentro de su propia infraestructura.
Según las cifras actuales, el sistema ha acumulado 7127 registros en la base de datos y el flujo semanal de entrada alcanza unos 1000 materiales. Pero la salida no es un flujo infinito: tras filtrar por relevance_score, revisar editorialmente y repartir por franjas, se publican solo ocho posts al día. Según el autor, este enfoque resultó más eficaz que las 28 publicaciones diarias anteriores, cuando la audiencia veía demasiado ruido e ignoraba la mayor parte del canal.
Otra capa importante es la orquestación de agentes. Las decisiones de publicación y los ajustes operativos están en OpenClaw, donde trabajan un coordinador y varios agentes de IA más: editor, gestor del pipeline, auditor de fuentes y analista. Basta escribir al coordinador en Telegram, por ejemplo para pedirle que reduzca el límite diario de publicaciones, y él mismo llama a la API, cambia la configuración y confirma el resultado.
Alrededor ha crecido además un dashboard completo: muestra el estado de los workers, el recorrido de cada noticia por las etapas, la eficacia de las fuentes, las colas, el calendario de franjas y los materiales publicados. Este nivel de transparencia permite saber rápidamente dónde se ha atascado un contenido y qué fuentes conviene desactivar. Por ejemplo, ya en la primera semana quedó claro que unas 20 fuentes no aportan señal útil, y el pass rate ayuda a separar las plataformas ruidosas de las realmente valiosas.
La conclusión principal no es que el no-code sea malo y Python bueno. Es más bien un ejemplo de lo rápido que cambia el umbral de entrada a los sistemas de IA complejos. El autor no escribe código él mismo, pero logró construir un producto funcional planteando tareas, revisando soluciones y dirigiendo la arquitectura.
La combinación de programación con IA, LLM locales, infraestructura doméstica barata y una orquestación comprensible convierte un proyecto personal de noticias en una redacción casi autónoma. Para los medios independientes y los canales de nicho es una señal: ahora el valor no lo crea la automatización en sí, sino la calidad de la selección, la observabilidad del sistema y la capacidad de montar un flujo robusto con las herramientas disponibles.
- 1 nov 2026Los modelos locales pierden ante Opus y Codex: 0,21 puntos en un MacBook frente a 1,00 de Codex
- 1 nov 2026Kimi logra un 96,2 % en un test de analítica sobre una base de 1C y se perfila como plan B ante un bloqueo de Claude
- 1 nov 2026OpenAI reescribe las reglas de comportamiento de GPT: cinco valores y una cadena de prioridades
- 1 nov 2026Google admite que AI Mode reduce los ingresos de su buscador: las acciones caen un 15%
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
Lo esencial de la IA — una vez por semana
Siete historias que de verdad importaron, elegidas a mano. Sin ruido ni notas de prensa.
¡Listo! Revisa tu correo para la confirmación.