T1 Oblako: H200 y L40S, análisis técnico de GPU para tareas de IA generativa
No todas las tareas de IA necesitan una H200, la GPU insignia. T1 Oblako ha publicado un análisis técnico de sus servidores con NVIDIA H200 y L40S, acompañado de fotografías de su centro de datos. La H200, con 141 GB de memoria HBM3e, está pensada para entrenar modelos grandes y generar vídeo. La L40S, basada en la arquitectura Ada Lovelace, se orienta a inferencia, sistemas RAG y chatbots corporativos. El proveedor amplió su catálogo de GPU para que los clientes no paguen de más por una capacidad que no necesitan.
Procesado por IA desde Habr AI; editado por Hamidun News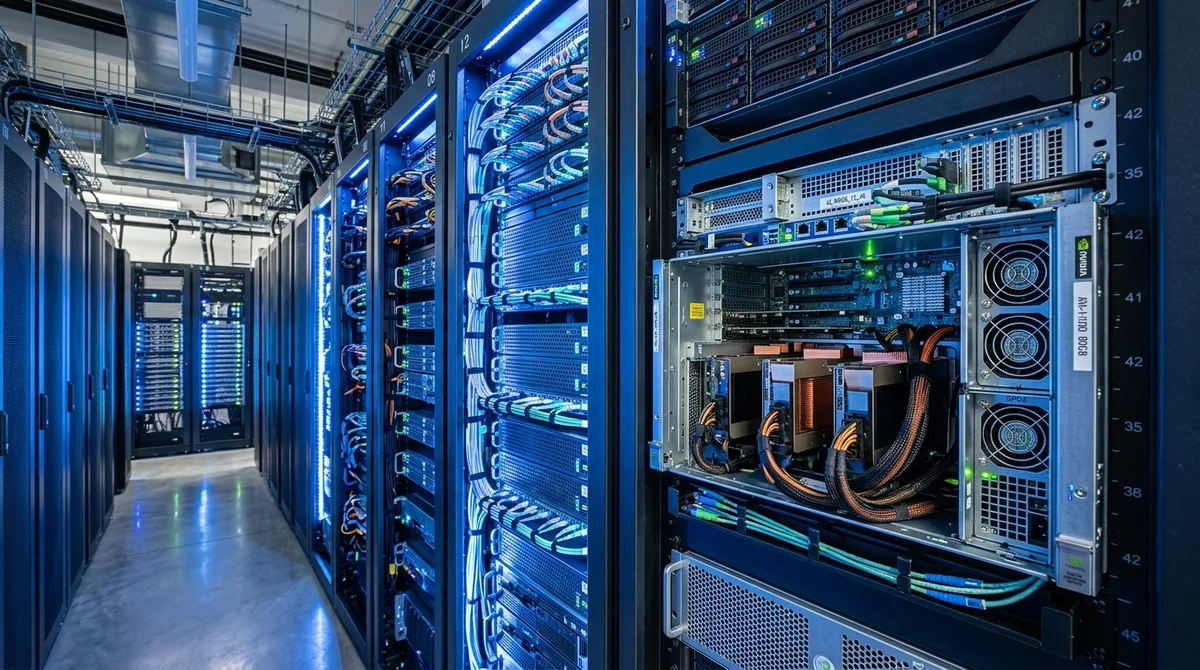
Elegir una GPU para tareas de IA va más allá del presupuesto. Se trata de ajustar la herramienta con precisión a la tarea: contratar exactamente la potencia de cálculo que requiere cada caso de uso, sin pagar de más por prestaciones que nunca se van a aprovechar. Ese principio guió la ampliación del catálogo de GPU de T1 Oblako.
La compañía publicó un análisis técnico detallado de sus servidores con aceleradores NVIDIA H200 y L40S, con fotografías tomadas directamente en su centro de datos. El material llega en un contexto de demanda creciente de cómputo con GPU: a medida que los LLM pasan de ser una herramienta experimental a convertirse en infraestructura estándar en las empresas, estas se enfrentan cada vez más a una pregunta práctica: qué acelerador encaja con cada tarea concreta. La H200 pertenece a la gama alta del mercado de GPU.
Sucesora de la H100, incorpora memoria de nueva generación HBM3e con un ancho de banda de 4,8 TB/s y una capacidad ampliada: 141 GB frente a los 80 GB de su predecesora. Es una tarjeta para tareas que exigen mantener en memoria modelos enormes: grandes redes multimodales que generan texto, imágenes y vídeo, entrenamiento desde cero con cientos de miles de millones de parámetros y procesamiento de vídeo en alta resolución. La H200 admite NVLink para conectar varias GPU dentro de un mismo servidor y la interconexión de alta velocidad entre nodos Infiniband, algo crítico en entrenamientos a gran escala, donde los datos deben moverse rápidamente entre decenas de nodos.
La L40S es otra historia. Se trata de un acelerador con arquitectura Ada Lovelace, 48 GB de memoria GDDR6 y núcleos tensoriales de cuarta generación optimizados para operaciones FP8 y BF16. Su punto fuerte es la versatilidad, no un ancho de banda de memoria récord.
La L40S rinde igual de bien en inferencia de modelos de lenguaje medianos, renderizado, procesamiento de vídeo, visión por computador y tareas de diseño generativo. Si una empresa necesita desplegar un chatbot corporativo sobre documentos internos, montar un sistema RAG para una base de conocimiento o automatizar el procesamiento de imágenes, la L40S resuelve la tarea sin pagar de más por las prestaciones de gama alta de la H200. T1 Oblako amplió su catálogo de GPU precisamente para no imponer a sus clientes una herramienta innecesariamente cara donde no hace falta.
Su centro de datos cuenta ahora con servidores para distintos tipos de tareas: desde inferencia ligera y sistemas RAG hasta entrenamiento distribuido intensivo. Es un paso importante en un mercado en el que muchos proveedores han ofrecido históricamente solo configuraciones de gama alta, lo que llevaba a las empresas a pagar de más por un cómputo que sencillamente no necesitaban. El valor práctico de este enfoque es evidente.
Una empresa que necesita una base de conocimiento corporativa con búsqueda semántica sobre miles de documentos internos no debería alquilar un clúster de H200. Le bastan una o dos L40S. En cambio, si esa misma empresa entrena su propio modelo multimodal especializado o trabaja con vídeo en 8K, solo obtendrá una ventaja real con la H200, y ahí ahorrar en hardware se traduciría en pérdida de tiempo y de calidad.
El formato de la publicación también merece atención: las fotografías detalladas de un centro de datos son una rareza en el mercado ruso de la nube. La mayoría de los proveedores se limitan a PDF con especificaciones y diapositivas de marketing. Mostrar el equipo real junto con la descripción técnica aporta transparencia y ayuda a ingenieros y responsables de compras a entender mejor cómo está construida la infraestructura, algo especialmente importante al elegir un socio tecnológico a largo plazo.
La conclusión es clara: el crecimiento del mercado de aceleradores de IA obliga a los proveedores de nube a pensar también en una segmentación inteligente, además de en la potencia de gama alta. La H200 y la L40S no son competidoras, sino herramientas para tareas radicalmente distintas. Las compañías que lo entienden y ofrecen ambas opciones con recomendaciones de uso claras obtienen una ventaja competitiva real: el cliente paga exactamente por lo que necesita, ni más ni menos.
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
Lo esencial de la IA — una vez por semana
Siete historias que de verdad importaron, elegidas a mano. Sin ruido ni notas de prensa.
¡Listo! Revisa tu correo para la confirmación.