OpenGrall presenta una arquitectura para robots con IA en la que el modelo de lenguaje se encarga de la estrategia
OpenGrall propone no entregar la motricidad directamente al LLM. El modelo de lenguaje toma solo decisiones de alto nivel, mientras que un circuito TinyML asume la ejecución y los reflejos de emergencia. Los datos de los sensores se recopilan de forma asíncrona y se ponderan según su frescura y fiabilidad, y las situaciones repetitivas se guardan en caché. El resultado es que el robot no se queda paralizado en cada paso y puede funcionar incluso con modelos locales compactos.
Procesado por IA desde Habr AI; editado por Hamidun News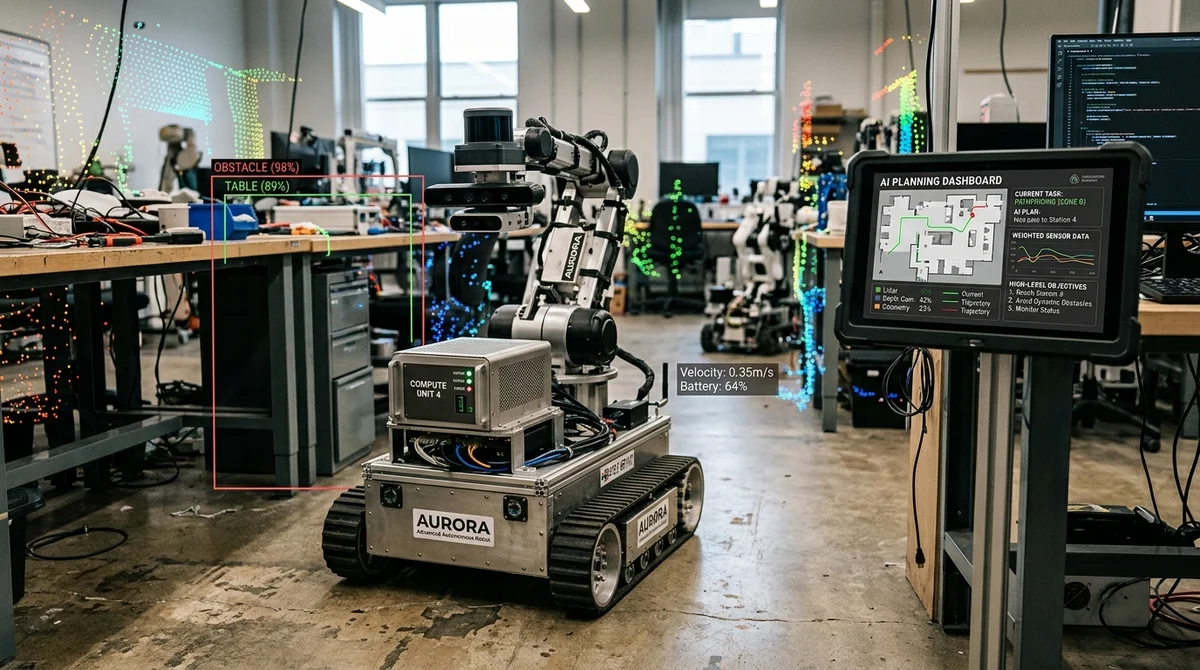
OpenGrall propone un cambio sencillo pero importante en la robótica: un LLM no debería controlar un robot al nivel de los motores y las reacciones instantáneas. Aquí el modelo de lenguaje se encarga solo del sentido, el plan y la elección del siguiente paso, mientras que la seguridad, el movimiento y los reflejos de bajo nivel se trasladan a un circuito aparte. Así, el proyecto intenta eliminar el principal problema de la mayoría de las demos de «robots con GPT», en las que la máquina conversa muy bien pero luego se queda inmóvil varios segundos antes de cada acción.
Los autores empiezan por el punto más delicado: la seguridad. Un LLM no es determinista: la misma petición puede producir respuestas distintas, así que confiarle el control directo de los motores es peligroso. OpenGrall introduce un esquema híbrido en el que un modelo TinyML, u otro circuito de ejecución rígido en un microcontrolador, hace de «médula espinal».
Es quien conoce la física de la plataforma concreta, gestiona la suspensión y la superación de obstáculos, y tiene derecho de veto sobre cualquier comando. Si el operador o el LLM ordenan avanzar, pero el telémetro detecta un objeto a menos de 10 centímetros, el comando simplemente no se ejecuta. El tiempo de reacción declarado para una parada de emergencia es de menos de 10 milisegundos.
La lógica es plenamente pragmática: el LLM piensa, el módulo ejecutor actúa y puede detener una acción peligrosa en cualquier momento.
El segundo punto fuerte de OpenGrall es la modularidad. El proyecto separa «pensar» y «hacer» para que ambas partes puedan cambiarse de forma independiente. Como cerebro puede actuar un LLM local, un VLM o un modelo en la nube, si se necesita una tarea más compleja, como un plan de varios pasos o una búsqueda web.
Como ejecutor, TinyML, un modelo VLA o incluso un algoritmo convencional codificado a mano, si la plataforma es sencilla. Todo el sistema se conecta mediante un servidor WebSocket, y los dispositivos se conectan como clientes normales con roles como agent, operator, lidar o esp. Esto permite añadir sensores nuevos sin reescribir el núcleo e incluso montar un esquema en el que un mismo agente trabaja con varios cuerpos a la vez: por ejemplo, una plataforma con ruedas y un dron.
Para un proyecto de código abierto sobre hardware modesto, este énfasis es especialmente importante: la arquitectura no depende de un único tipo de robot ni de un modelo concreto.
El bloque de ingeniería clave es la pareja SensorMemory y WeightCalculator. En lugar de enviar al LLM todos los flujos en bruto sin criterio, el sistema recopila los datos de forma asíncrona, evalúa su frescura y su fiabilidad, y después los convierte en un prompt breve. Si el lidar se ensucia o el VLM se ciega por el sol, su peso baja antes de tomar la decisión. Si un sensor es lento, no bloquea a los demás. El artículo ofrece un ejemplo ilustrativo: la nube de puntos del lidar se condensa en ocho sectores, y los objetos cercanos se describen mediante ángulo, distancia, tamaño y velocidad. Para el LLM ya no es ruido, sino una situación estructurada.
Un matiz importante es que OpenGrall no intenta escribir a mano reglas complejas de fusión de datos. El árbitro es el propio LLM, que ve la fuente, la antigüedad y el peso de cada señal y, con eso, elige la acción en formato JSON. El prompt del sistema se incorpora al modelo de antemano, por ejemplo mediante Ollama, de modo que en el ciclo de trabajo a la petición solo va la parte operativa «desnuda». Según la estimación del autor, esto reduce el prompt de unos 450 a 150 tokens.
Otro foco del artículo es la lucha contra la lentitud. En muchos frameworks clásicos el robot espera al sensor más lento, y por eso la telemetría rápida queda de hecho ociosa. OpenGrall renuncia a esa sincronización: lidar, VLM y odometría escriben datos en la memoria de forma independiente, y el agente toma los valores más recientes y fiables en ese momento. Pero incluso así el LLM tarda cientos de milisegundos en pensar, por lo que en el lado del ESP32 se añade movimiento inercial: si todavía no hay un comando nuevo, el robot no se queda clavado, sino que continúa suavemente la última acción segura con la velocidad decreciente.
Otra capa de optimización es el almacenamiento en caché de decisiones por hash del contexto. Si el robot vuelve a encontrarse ante el mismo pasillo vacío, el sistema no llama de nuevo al modelo, sino que toma la decisión ya verificada de la caché. Esta idea se desarrolla después hacia hábitos y reflejos de alto nivel: las estrategias exitosas pueden ejecutarse sin LLM, y la retroalimentación humana refuerza su peso. Además, el proyecto guarda una memoria episódica de las instrucciones humanas e incluso admite la fijación autónoma de objetivos, en la que un robot inactivo elige por sí mismo qué explorar, qué recordar o con quién iniciar un diálogo.
Visto en conjunto, OpenGrall resulta interesante no como un intento más de «acoplar GPT a un robot», sino como un intento de llevar la robótica con LLM a una arquitectura más madura. No promete un cerebro universal mágico, pero sí ofrece una separación clara de responsabilidades, trabajo con hardware limitado, protección frente a acciones peligrosas y un camino hacia el aprendizaje gradual sin reentrenar todo el sistema. Para los desarrolladores, esto supone una forma más realista de construir robots con modelos actuales: usar el LLM donde es fuerte y no obligarlo a hacer aquello para lo que resulta más adecuado un circuito de ejecución pequeño, rápido y predecible.
- 2 nov 2026DeepSeek abre el código del prototipo Super-agent: p95 de ejecución de 15,7 min frente a 29,5
- 2 nov 2026El creador de Bun migra 750 mil líneas de Zig a Rust en 11 días con Claude Code
- 2 nov 2026Microsoft lanza Mage-VL-Cowork, un modelo de 4B que resuelve el 66,0% de las tareas de OSWorld-Verified
- 2 nov 2026El asistente Muse de Meta mantiene dosieres de las personas cercanas y obtiene root en Ubuntu por defecto
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
Lo esencial de la IA — una vez por semana
Siete historias que de verdad importaron, elegidas a mano. Sin ruido ni notas de prensa.
¡Listo! Revisa tu correo para la confirmación.