موضوع
#LLM
تغطية منسقة حول «LLM»: إصدارات، أبحاث، معايير، مفتوحة المصدر.
2880 مقالات0% مقابل الأسبوع السابق0 هذا الأسبوع

أبرز المواضيع
01Claude Code على Windows: إعداد بيئة عمل مستقرة وسريعة02شرحت Anthropic و OpenAI و LangChain لماذا يحتاج وكلاء الذكاء الاصطناعي إلى harness03قادة الشركات يعدون بزيادة الإنتاجية من الذكاء الاصطناعي بينما الموظفون يغرقون في 'Workslop'04Synera تجمع 40 مليون دولار لدمج الذكاء الاصطناعي الوكيل في عمليات الهندسة بـ NASA و BMW05يمكن لـ Anthropic والنماذج اللغوية الأخرى استدعاء أدوات مخفية بدون إذن
LLM·Habr AI
بحث حول ChatGPT: هل تؤثر الصيغة النحوية الأنثوية في المطالبة على جودة حل المهام
أظهرت تجربة من تأليف الباحث على LiveCodeBench أنه في GPT-5.4 mini، تقلل التقديم الذاتي الأنثوي في مطالبة باللغة الروسية قيمة pass@1 قليلاً،
LLM·Habr AI
أظهرت Gramax كيفية مقارنة جودة إجابات RAG دون تقييم يدوي ذاتي
شرحت Gramax لماذا مقاييس retrieval غير كافية لـ RAG واقترحت تقييم الإجابة النهائية للمستخدم بدلاً من المقاطع المسترجعة — من حيث الاكتمال وال
LLM·Habr AI
مساعدات الذكاء الاصطناعي في عام 2026: كيف أصبح مطور منفرد أسرع من فريق من ثلاثة أشخاص
LLM·Habr AI
قارنت ecom.tech بين الضبط الدقيق التطوري لـ Qwen3-4B مع SFT و GRPO لاختبارات Kotlin
LLM·Habr AI
تم اختبار Yandex Code Assistant في إدارة الأسرار ومقارنته مع Cursor
LLM·Habr AI
كيف قلل بنك سوفكومبانك أعمال فريق المنتج الروتينية بنسبة 50% باستخدام مساعد ذكاء اصطناعي
LLM·MarkTechPost
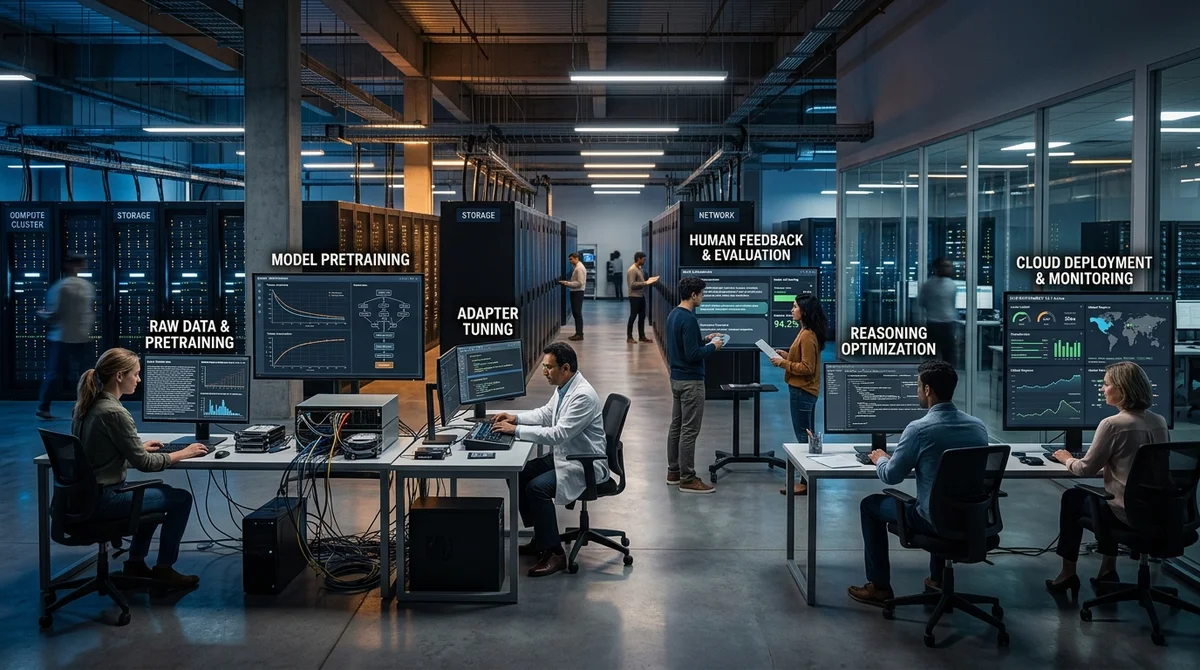
قام MarkTechPost بتحليل الدورة الكاملة لتدريب نماذج اللغة الكبيرة: من البيانات إلى النشر
نشر MarkTechPost تحليلاً مفصلاً لكيفية بناء نماذج اللغة الكبيرة اليوم: من التدريب المسبق على المجموعات الضخمة إلى SFT و RLHF وتحسين المنطق و
LLM·MarkTechPost
قدّمت Google نموذج Gemini 3.1 Flash TTS — نموذج كلام مع التحكم والحوارات و70+ لغة
أطلقت Google نموذج Gemini 3.1 Flash TTS في معاينة: يقوم النموذج بتحويل النص إلى كلام في 70+ لغة، يدعم الحوارات بصوتين، ويسمح بالتحكم في الإل
مواضيع ذات صلة