Anthropic وOpenAI وLangChain تشرح لماذا تحتاج وكلاء الذكاء الاصطناعي إلى harness
لم تعد كبرى شركات الذكاء الاصطناعي تتنافس بالنماذج وحدها، بل تتنافس أكثر فأكثر على جودة agent harness. فالتنسيق والذاكرة والتحكم في السياق وموثوقية عمل الأدوات هي ما يحوّل نموذج LLM من روبوت عرض تجريبي إلى وكيل يؤدي عملًا فعليًا. ومن الأمثلة اللافتة أن LangChain تمكنت من الصعود الحاد في TerminalBench 2.0 عبر تحسين البنية التحتية المحيطة بالنموذج، لا أوزان النموذج نفسه. وهذا يغيّر قواعد اللعبة أمام فرق المنتجات.
معالج بواسطة الذكاء الاصطناعي من Habr AI؛ بتحرير Hamidun News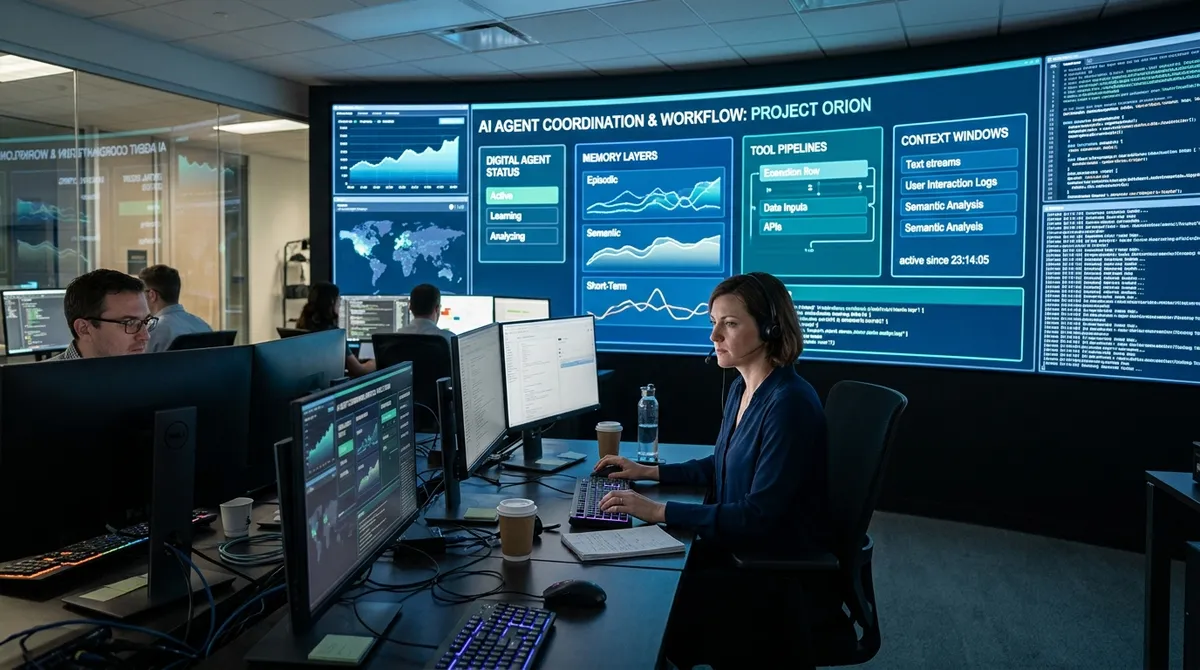
المشكلة الرئيسية في وكلاء الذكاء الاصطناعي الحاليين لا تكمن في جودة النموذج الأساسي، بل في الطبقة المحيطة به: التنسيق (orchestration)، والذاكرة، وإدارة السياق، وموثوقية عمل الأدوات. وهذه الطبقة، التي يُطلق عليها بشكل متزايد اسم agent harness، هي ما يحوّل نموذج LLM عديم الحالة (stateless) من عرض تجريبي لافت إلى نظام قادر على تنفيذ سلاسل طويلة من الإجراءات بثبات، والتعافي من الأخطاء، وإيصال المهمة إلى نتيجة.
في المراحل الأولى، تكتفي فرق كثيرة بواجهة دردشة وعدد قليل من استدعاءات الأدوات (tool calls) وحلقة ReAct بسيطة. يكفي هذا لبناء نموذج أولي: يستدل النموذج، ويختار أداة، ويتلقى الرد، ثم يواصل الحوار. لكن في سيناريوهات الإنتاج (production) سرعان ما تظهر أعطال منهجية. ينسى الوكيل ما فعله قبل خطوتين أو ثلاث، ويكرر الاستدعاءات نفسها، ويفقد النتائج الوسيطة، وتمتلئ نافذة السياق بضجيج عشوائي. وتبرز مشكلة مستقلة في الأدوات: فقد تعيد صيغة غير متوقعة، أو تستجيب بتأخير، أو تتعطل دون سبب واضح. وإذا غابت فوق ذلك طبقة للتحكم والتسجيل والاستعادة، فإن جودة النظام لا تتحدد بذكاء النموذج، بل بهشاشة الطبقة المحيطة به.
ولهذا السبب لا تكتفي الجهات الكبرى مثل Anthropic وOpenAI وPerplexity وLangChain ببناء نماذج جديدة، بل تبني بنية تحتية متكاملة للوكلاء. وفي قلب هذه البنية حلقة التنسيق: فهي تقرر متى يحتاج النموذج إلى التفكير مرة أخرى، ومتى يستدعي أداة، وما الذي يُحفظ في الذاكرة، وما الذي يُعاد إلى المستخدم، ومتى يتوقف. وبذلك يعمل harness بمثابة نظام تشغيل للوكيل. فهو يضع قواعد التنفيذ، ويتابع حالة الجلسة، ويوجّه الإجراءات بين النموذج والخدمات الخارجية، ويقلل احتمال أن يقع الوكيل في حلقة لا نهائية أو أن يفقد هدف المهمة.
بعض مكونات هذا النهج أصبحت إلزامية بالفعل. أولًا، إدارة الأدوات: وصف الواجهات، والتحقق من البيانات المدخلة، وإعادة المحاولة، والمهلات الزمنية (timeouts)، ومعالجة الأخطاء. ثانيًا، الذاكرة متعددة الطبقات: ذاكرة قصيرة المدى للمهمة الحالية، وذاكرة عاملة للنتائج الوسيطة، وذاكرة أطول مدى للتفضيلات والقواعد والخبرة المتراكمة. ثالثًا، التحكم في السياق: انتقاء المقاطع المهمة فعلًا، وضغط السجل، وحذف الحشو، وتمرير ما يؤثر في الخطوة التالية فقط إلى النموذج. وعندما تغيب هذه الآليات، يتراجع أداء حتى نموذج LLM القوي كلما طالت المهمة. وعندما توجد، يعمل النموذج نفسه بموثوقية أعلى بشكل ملحوظ.
وثمة طبقة مهمة أخرى في harness ترتبط بقابلية المراقبة وتقييم الجودة. لا يكفي المطوّر أن يعرف أن الرد جاء سيئًا؛ بل يحتاج إلى رؤية مسار الوكيل كاملًا: أي prompt أُرسل إلى النموذج، وأي أداة استُدعيت، وأي رد عاد، وأين وقع الخطأ، ولماذا اختير ما اختير من خطوة تالية. وبدون ذلك يستحيل تصحيح سلوك الوكيل بشكل سليم وتحسين النظام تدريجيًا. لذلك تضيف المنظومات الناضجة التتبّع (traces) والمقاييس والتنفيذ داخل بيئة معزولة (sandbox) ونقاط تحقق يدوية (checkpoints) وآليات إشراك الإنسان في الحلقة (human-in-the-loop) للإجراءات الخطرة.
والأثر العملي لافت. تورد المادة مثال LangChain: فقد حسّنت الشركة البنية التحتية المحيطة بالنموذج لا أوزانه، وكان ذلك كافيًا لتقفز بشكل حاد في TerminalBench 2.0، من مراكز خارج أول ثلاثين إلى المركز الخامس. والنتيجة الأخرى أكثر إثارة للاهتمام: ففي مشروع بحثي استُخدم LLM لتحسين البنية التحتية الخاصة بوكيله، وحقق النظام معدل نجاح (pass rate) بلغ 76,4%، متفوقًا على الحلول التي بُنيت يدويًا.
وهذه إشارة مهمة للسوق. فالمنافسة تنتقل من سؤال «أي نموذج أذكى» إلى سؤال «أي بيئة تنفيذ تساعد النموذج بشكل أفضل على التفكير والتذكّر والتخطيط وتصحيح أخطائه». والخلاصة مباشرة للمطورين وفرق المنتجات: إذا كان الهدف وكيلًا عاملًا لا روبوتًا للتسلية، فلا يكفي الاستثمار في اختيار النموذج، بل يجب الاستثمار في harness أيضًا. وسيفوز من ينظّم بشكل أفضل حلقة التنفيذ والذاكرة والسياق وقابلية المراقبة والتسامح مع الأعطال. وفي المستقبل القريب، ستكون جودة هذه الطبقة المحيطة، لا قفزة جديدة في المعايير القياسية (benchmarks)، هي الفارق الرئيسي بين عرض تجريبي جميل ونظام يمكن ائتمانه على عمل حقيقي.
- 1 نوفمبر 2026Google تقرّ: وضع AI Mode يخفض إيرادات البحث، وأسهمها تهبط 15%
- 31 أكتوبر 2026مؤلف يعرض سيناريو على محكمة محلّفين من الذكاء الاصطناعي: الحكم كلّف 850 ألف توكن
- 31 أكتوبر 2026Anthropic: دمج الوكلاء الفرعيين في حلقة واحدة سرّع المهام لدى أحد العملاء إلى الضعف
- 31 أكتوبر 2026IBM: طرح أسئلة على العميل قبل التوليد رفع دقة العقود الذكية من 54% إلى 73%
Delegate Deep Research, Coding & Multi-Step Workflows to Nomad Agent
Deploy autonomous task execution with Nomad Agent (agent.nomadnet.ai) — automated web research, data synthesis, code generation, and MCP tool orchestration.
أهم ما في عالم الذكاء الاصطناعي — مرة كل أسبوع
سبع قصص مهمة فعلاً هذا الأسبوع، مختارة بعناية. بلا ضجيج ولا بيانات صحفية.
تم! تحقق من بريدك للتأكيد.