Des robots piégés par les données : pourquoi les vidéos de saltos périlleux ne sont qu'un début
Les vidéos virales donnent l'illusion d'une percée technologique, mais le progrès réel est freiné par une « crise des données ». Contrairement aux IA textuelles, les robots ont besoin de données multidimensionnelles issues du monde physique : vision, toucher et force. La Chine construit massivement des centres de collecte de données, où des opérateurs enseignent manuellement des tâches de base aux machines. Les principaux problèmes sont le coût élevé des données « réelles » et l'incompatibilité des équipements de différents fabricants. Les experts comparent cette étape aux débuts du pilote automatique et soulignent que la route vers des robots assistants universels sera bien plus difficile et coûteuse qu'on ne le pensait au départ.
Traité par IA depuis 36Kr (36氪) ; édité par Hamidun News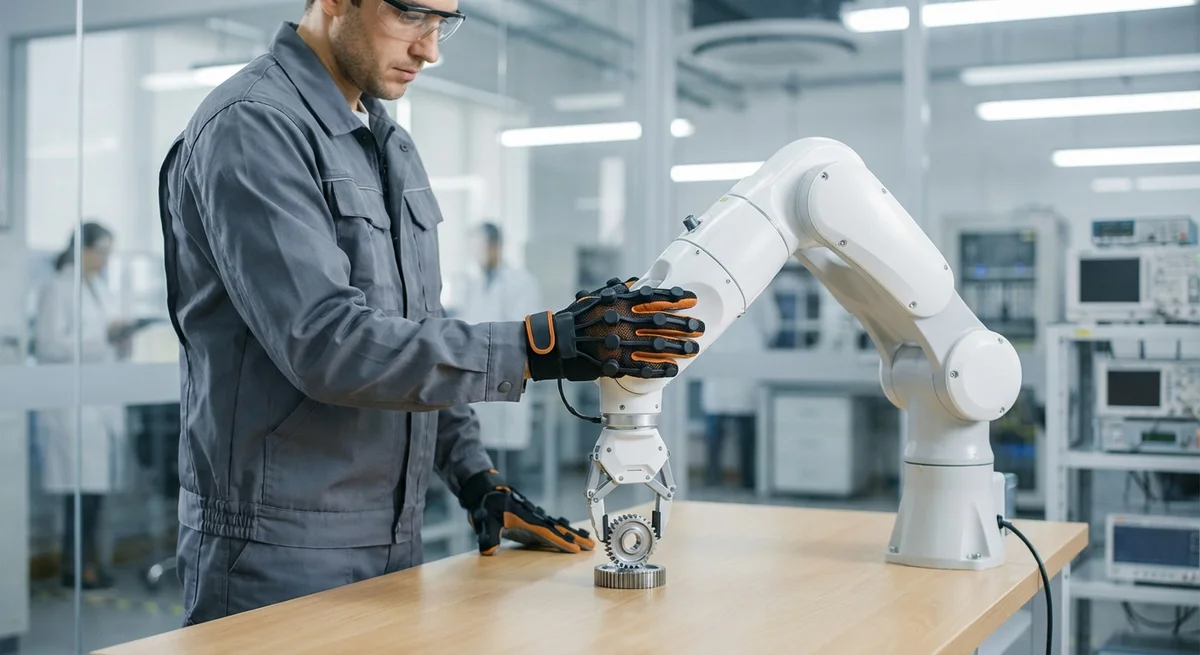
# Des robots piégés par les données : pourquoi les vidéos de saltos périlleux ne sont qu'un début
Au cours de l'année écoulée, internet a été submergé de vidéos de prouesses impressionnantes : des robots sautent, dansent, balancent des coups de poing et écrasent des pastèques d'un coup de pied. Les investissements augmentent, les médias regorgent de titres optimistes, et le public est persuadé que l'ère des robots assistants domestiques est sur le point de commencer. Mais si l'on regarde dans les coulisses de ce théâtre technologique, le tableau est bien plus complexe, et plus triste.
En ce moment même, dans des centres de préparation de données silencieux à travers la Chine, des opérateurs humains gantés pilotent lentement, presque douloureusement, des manipulateurs : ils apprennent aux machines à saisir des pièces, ranger des outils et fermer des couvercles de boîtes. Cette scène n'a rien de la dimension cinématographique des vidéos virales, mais c'est elle qui détermine le progrès réel de la robotique. Entre une prouesse impressionnante et un assistant domestique utile se dresse un problème fondamental : une pénurie catastrophique de données de qualité.
Les modèles de langage comme ChatGPT et DeepSeek reposent sur le triomphe d'une logique simple : des milliers de milliards d'exemples de texte tirés d'internet ont permis à l'IA de comprendre le langage et de produire des contenus sensés. La robotique, elle, fait face à une tout autre réalité. Les données textuelles vivent dans un espace numérique à deux dimensions et se copient et se diffusent facilement, alors que le monde physique est un flux d'informations multidimensionnel et continu.
Un robot doit percevoir le monde par de nombreux canaux à la fois : vidéo de plusieurs caméras, capteurs de force, capteurs de toucher, informations sur la position des articulations. Chaque opération effectuée par un manipulateur génère des données structurées, avec 57 dimensions dans certains systèmes. Et tous ces flux doivent être parfaitement synchronisés à la milliseconde près, faute de quoi le modèle apprendra de la pure hallucination plutôt qu'une relation de cause à effet.
La Chine compte déjà plus de cinquante centres de collecte et de traitement de données robotiques. À Pékin seulement, un de ces centres produit environ six mille enregistrements d'exemples d'entraînement par jour. Une extrapolation grossière laisse penser que la production annuelle pourrait atteindre des dizaines de milliards d'exemples.
Cela semble impressionnant, mais c'est en réalité une goutte d'eau dans l'océan des besoins. Les experts de la société PowerTech ont fait un calcul prudent : pour qu'un robot apprenne un mouvement, il faut environ mille à cinq mille exemples. Une tâche simple composée de plusieurs mouvements en demande dix mille à vingt mille.
Mais un robot universel capable d'assurer quatre-vingts pour cent des métiers humains d'un secteur nécessiterait un jeu de données de cent millions d'exemples. Et si l'ambition s'étend à des milliers de secteurs, on parle de milliers de milliards d'exemples. Le déficit atteint quatre à cinq ordres de grandeur.
Mais ce n'est pas encore le problème le plus grave. L'incompatibilité des équipements s'est révélée bien plus insidieuse. Les fabricants conçoivent des robots avec des configurations de capteurs, des protocoles de contrôle et des paramètres physiques différents. Les données collectées sur un modèle de manipulateur ne fonctionnent souvent tout simplement pas sur un autre : le langage d'une machine reste totalement étranger à l'autre. Les connaissances ne s'additionnent donc pas et ne s'accumulent pas en un actif commun pour l'industrie. Chaque fabricant doit constituer son propre jeu de données à partir de zéro, en répétant sans cesse le même travail coûteux.
Certains centres gèrent ce dilemme en se concentrant sur les modèles populaires, ce qui revient à ignorer la diversité. D'autres choisissent une voie plus ambitieuse : ils collectent les données de robots de différents fabricants dans un espace unique, en cherchant à apprendre au modèle à généraliser ses connaissances à des équipements hétérogènes. Aucune de ces approches n'a encore prouvé son caractère universel.
Tout cela rappelle les premiers temps du pilote automatique, une époque où l'on croyait que le problème venait des algorithmes et non des données. Près de vingt ans et des milliards d'investissements plus tard, la vérité s'est révélée proche, mais pas tout à fait là où on la cherchait. Avant que les robots n'entrent vraiment dans nos foyers, il reste un long et fastidieux travail à accomplir dans les centres de données, où des personnes gantées enseigneront patiemment aux machines à comprendre le monde physique. Les vidéos virales, c'est du marketing. Le progrès réel, c'est une tout autre histoire.
- 2 nov. 2026Le framework AICG de NC State réduit de 50,3% la MAE pour la notation des réponses mathématiques
- 2 nov. 2026Nous avons vérifié 929 automatisations chez Alpina : à quoi doit ressembler la formation corporate à l'IA en 2026
- 2 nov. 2026J'ai fait passer 6 IA à la question en acheteur B2B : Amazon, ésotérisme, « Telo Khudelo » et 5 failles colmatées en une journée
- 2 nov. 2026TJ Digital : une réponse directe ouvre 23% des pages citées par l'IA, contre 14% des pages non citées
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
L'essentiel de l'IA — une fois par semaine
Sept actus qui ont vraiment compté, choisies à la main. Sans bruit ni communiqués.
C'est fait ! Vérifiez votre boîte mail pour la confirmation.