Google Gemma 4, NVIDIA et OpenClaw : des agents IA locaux sans payer chaque token
Google, avec NVIDIA, met en avant Gemma 4 comme socle d'agents IA locaux. Les modèles peuvent tourner sur Jetson Orin Nano, PC RTX et DGX Spark, et l'association avec OpenClaw lève le principal obstacle des usages always-on : les coûts d'API permanents. Nuance importante : pour les données d'entreprise et sensibles, NVIDIA promeut séparément NemoClaw, avec des restrictions de sandbox et des politiques d'accès.
Traité par IA depuis MarkTechPost ; édité par Hamidun News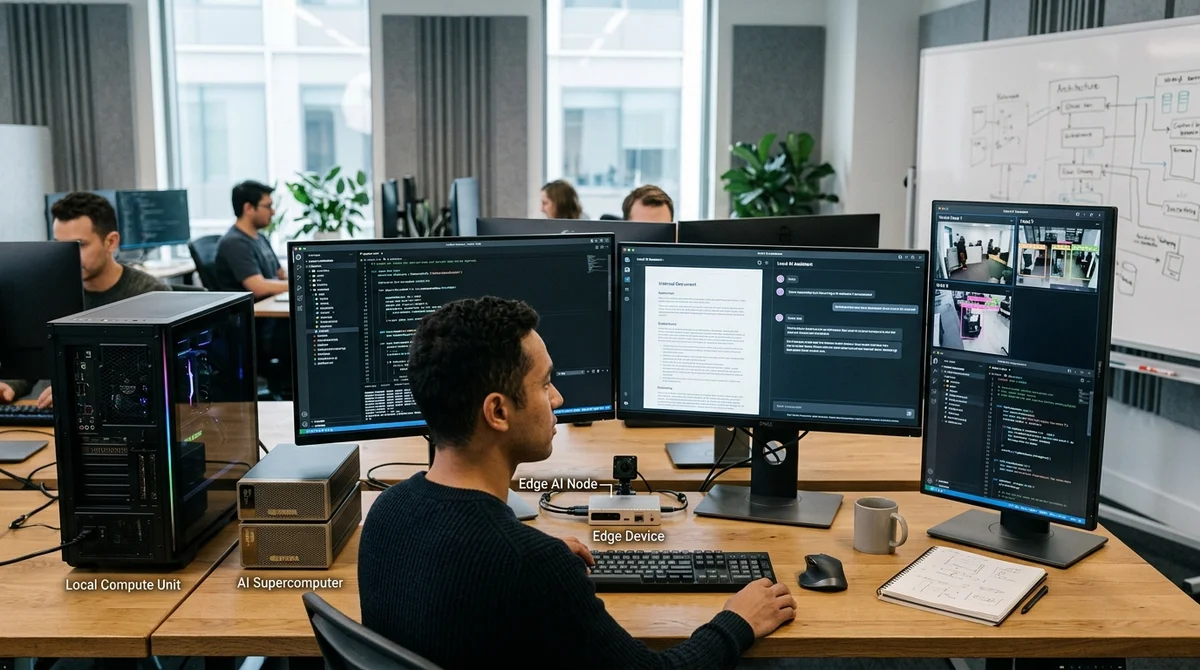
L'idée est simple : si un agent IA doit fonctionner en permanence, voir l'écran, lire des fichiers locaux, analyser des documents et lancer des actions en arrière-plan, un modèle facturé au token via une API cloud devient très vite un service coûteux. Google, NVIDIA et l'écosystème OpenClaw proposent une autre voie : garder le modèle près des données, l'exécuter sur du matériel local et supprimer ainsi non seulement la latence, mais aussi la logique même du « paiement à chaque étape » de l'agent.
Par « taxe sur les tokens », on n'entend pas ici la dépense ponctuelle d'un chatbot, mais l'effet cumulatif des assistants toujours actifs. Ces systèmes lisent en continu du contexte : conversations, fenêtres d'applications, code, documents, agenda, dossiers et notifications. Si chaque observation, chaque raisonnement intermédiaire et chaque action passent par un modèle cloud, le coût devient vite imprévisible. Pour un assistant personnel, cela pèse sur le budget ; pour un usage en entreprise, cela soulève en plus la question de la confidentialité, car il faut régulièrement envoyer des données sensibles à l'extérieur. L'exécution locale n'est donc pas ici une question d'idéologie, mais une nécessité économique et opérationnelle.
La famille Google Gemma 4, présentée le 2 avril 2026, joue un rôle clé dans ce schéma. Google a publié quatre variantes : E2B, E4B, 26B et 31B. Les petits modèles visent les appareils en périphérie et les usages mobiles ; les plus grands, le raisonnement, le code et les workflows agentiques sur stations de travail.
Le 26B utilise une architecture Mixture of Experts et n'active que 3,8 milliards de paramètres pendant l'inférence. Gemma 4 prend en charge nativement le function calling, la sortie JSON structurée et les instructions système, soit tout ce qu'il faut à un agent fiable utilisant des outils. Tous les modèles traitent images et vidéo, et E2B et E4B gèrent en plus l'entrée audio native.
La fenêtre de contexte atteint 128K tokens sur les modèles edge et 256K sur les plus grands.
Selon Google, au 2 avril 2026, la version 31B occupait la troisième place parmi les modèles ouverts sur Arena AI et la 26B la sixième ; la société souligne que la gamme surpasse des modèles nettement plus gros. Il est aussi notable que Gemma 4 soit distribué sous licence Apache 2.0 et que, à sa sortie, la famille Gemma ait cumulé plus de 400 millions de téléchargements et plus de 100 000 variantes dans l'écosystème.
La seconde moitié de l'histoire concerne le matériel et la pile d'exécution. NVIDIA présente Gemma 4 comme une gamme qui passe de Jetson Orin Nano à GeForce RTX, RTX Pro et DGX Spark presque sans changer d'approche. Pour l'edge, Jetson Orin Nano prend en charge E2B et E4B, ce qui permet de bâtir des systèmes autonomes de vision et de voix à faible latence directement sur l'appareil.
Pour les stations de travail locales et les assistants personnels, l'accent se déplace vers 26B et 31B, exécutables via Ollama, llama.cpp, vLLM et Unsloth. DGX Spark est ici particulièrement important : NVIDIA met en avant la configuration avec le GB10 Grace Blackwell Superchip et 128 Go de mémoire unifiée comme point d'entrée pratique pour le prototypage local, le fine-tuning et l'exécution de grands modèles sans cloud.
Dans ce mode, OpenClaw cesse d'être une « surcouche d'API distante » pour devenir un véritable agent local, qui puise son contexte dans les fichiers, applications et workflows de la machine de l'utilisateur.
OpenClaw rend d'ailleurs cette histoire concrète. C'est un agent local-first qui peut résider en permanence sur l'ordinateur, se connecter aux messageries, mémoriser l'état des tâches et appeler des outils. Pour lui, un modèle local n'est pas un bonus agréable, mais la condition de base d'une économie viable. Si l'agent doit lire une base de code toute la journée, suivre des projets, répondre dans des chats ou analyser des documents financiers, la tarification cloud au token devient la principale contrainte.
Pour autant, le local ne règle pas à lui seul la question de la sécurité : un agent ayant accès aux fichiers, au réseau et aux comptes reste une entité risquée. C'est pourquoi NVIDIA promeut en parallèle NemoClaw, une pile ouverte avec OpenShell et des garde-fous fondés sur des politiques, censée limiter le comportement des agents toujours actifs, isoler leur exécution dans un sandbox et garder les données sensibles dans le périmètre local.
En pratique, cela traduit un changement dans la manière même de consommer l'IA. La question n'est plus seulement de savoir si un modèle est performant en benchmark, mais s'il peut rester allumé toute la journée sans craindre la facture, la latence ou la fuite de données. L'association de Gemma 4, de NVIDIA RTX ou DGX Spark et d'OpenClaw montre que le marché évolue vers des agents personnels et d'entreprise qui travaillent plus près des données et de l'utilisateur. Le cloud ne disparaîtra pas, mais pour les assistants toujours actifs, le code local, la gestion documentaire, la robotique et les fichiers sensibles, l'inférence locale cesse d'être une option de niche et devient l'architecture de base.
- 1 nov. 2026Test de 16 modèles sur 7 moteurs de recherche : Exa obtient en moyenne 10,5 points sur 14, SearXNG environ 3
- 1 nov. 2026L'agent vidéo StreamVibe de Google devance les autres modèles de 10,7 % sur le timing et la qualité des réponses
- 1 nov. 2026OpenAI réécrit les règles de comportement de GPT : cinq valeurs et une chaîne de priorités
- 1 nov. 2026Les bots vocaux à base de LLM s'appuient sur le classifieur rapide Jev : une décision en 200–500 ms
Build & Ship Production AI Agents Without Boilerplate Code
Start your free 72-hour trial at Hamidun Academy (academy.hamidun.com) — interactive lessons on Claude Code & Cursor, live Tech Radar, and production agent templates.
L'essentiel de l'IA — une fois par semaine
Sept actus qui ont vraiment compté, choisies à la main. Sans bruit ni communiqués.
C'est fait ! Vérifiez votre boîte mail pour la confirmation.