NVIDIA montre Gemma 4 avec voix et webcam sur un Jetson Orin Nano Super
NVIDIA a monté une démo locale de Gemma 4 pour le Jetson Orin Nano Super : le modèle écoute la voix de l'utilisateur, consulte de lui-même la webcam si nécessaire et répond via un moteur TTS. La chaîne s'appuie sur Parakeet pour la reconnaissance vocale, Kokoro pour la synthèse et llama.cpp avec un vision projector. L'intérêt principal : un agent multimodal tourne sur une carte compacte de 8 Go de mémoire, sans dépendre obligatoirement du cloud.
Traité par IA depuis Hugging Face Blog ; édité par Hamidun News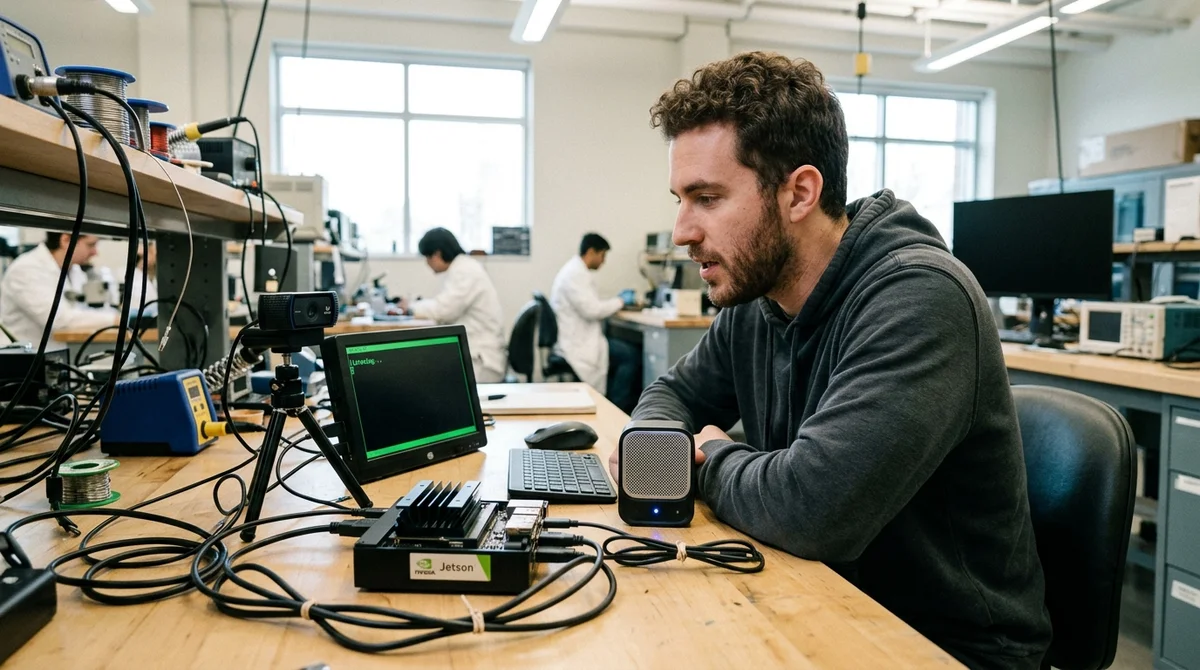
NVIDIA présente une démo edge pragmatique : Gemma 4 écoute une question, consulte de lui-même la webcam si nécessaire et répond à voix haute, le tout en local sur un Jetson Orin Nano Super doté de 8 Go de mémoire. La publication du 22 avril 2026 vaut moins pour le tutoriel lui-même que pour ce qu'elle démontre : un agent multimodal tourne sur une carte compacte, et non dans le cloud.
Comment fonctionne la chaîne
Le scénario prend la forme d'un agent vocal simple, doté d'un unique outil visuel. L'utilisateur appuie sur la barre d'espace et pose sa question à voix haute ; Parakeet transcrit alors la parole en texte, en local. Gemma 4 reçoit ensuite la requête et décide seul s'il a besoin de regarder à travers la webcam. Si c'est le cas, le script capture une image et la transmet au modèle, puis Kokoro TTS vocalise la réponse. L'article insiste sur un point : le modèle ne décrit pas l'image de manière générale, il n'utilise ce qu'il voit que pour répondre à la question posée.
«
Franchement, le simple fait que cela tourne sur un Jetson Orin Nano est déjà impressionnant. »
L'essentiel tient à l'absence de déclencheurs rigides ou de logique codée à la main du type « si la question contient le mot camera ». Le script expose à Gemma 4 un seul et unique tool, `look_and_answer`, qui prend une photo et analyse la scène. C'est le modèle qui décide de l'appeler ou non. Pour cela, NVIDIA s'appuie sur `llama-server` de `llama.cpp` avec le flag `--jinja`, qui active la prise en charge native du tool calling. Concrètement, il s'agit d'un scénario VLA compact, où la vision n'intervient que lorsqu'elle est réellement nécessaire.
Ce qu'il faut pour la faire tourner
La démo n'a rien d'une magie prête à l'emploi : c'est plutôt un guide bien construit pour les passionnés et les développeurs qui veulent reproduire chez eux un pipeline multimodal local. NVIDIA ne se contente pas de décrire le lancement d'un script Python : elle détaille toute la stack, des paquets système et de la compilation de `llama.cpp` jusqu'à la configuration de l'audio et de la caméra, en passant par le téléchargement du vision projector pour Gemma 4.
- Un Jetson Orin Nano Super avec 8 Go de mémoire, une webcam, un micro USB ou une caméra à micro intégré, des haut-parleurs USB et un clavier
- Un environnement Python avec `opencv-python-headless`, `onnx_asr`, `kokoro-onnx`, `soundfile`, `huggingface-hub` et `numpy`
- Un `llama.cpp` compilé localement avec CUDA, le modèle `gemma-4-E2B-it` au format GGUF et un fichier `mmproj` distinct, sans lequel Gemma 4 ne peut pas voir
- La configuration de `MIC_DEVICE`, `SPK_DEVICE`, `WEBCAM` et `VOICE`, après quoi la démo se lance d'une seule commande : `python3 Gemma4_vla.py`
- Un mode texte distinct via Docker, pour tester rapidement la partie LLM sans la configuration visuelle complète
La mémoire fait l'objet d'une attention particulière. La carte de 8 Go tient la charge, mais l'auteur recommande explicitement de libérer de la RAM, de couper les processus superflus, voire d'ajouter du swap pour éviter un OOM au chargement du modèle. La version quantifiée `Q4_K_M` est présentée comme l'option de base ; en cas de contraintes vraiment sévères, on peut descendre jusqu'à `Q3`. Le détail compte : il ne s'agit pas d'un produit grand public abouti, mais d'une recette fonctionnelle où chaque gigaoctet pèse réellement sur le résultat.
Pourquoi c'est intéressant
La nouveauté ne tient pas au fait que Gemma 4 tourne sur un Jetson : c'était attendu pour des versions allégées. L'essentiel est ailleurs : NVIDIA propose un modèle pratique d'agent multimodal local qui combine STT, LLM, tool calling, vision et TTS sans recours obligatoire au cloud. Pour les appareils edge, le signal est fort. Jusqu'ici, ce type de scénario évoquait plutôt un serveur, ou bien des démos très bridées où le modèle se contente de répondre à du texte.
Le guide expose d'ailleurs honnêtement ses limites. Le premier lancement est lent, car il faut télécharger les modèles et générer les fichiers vocaux. Le mode VLA complet exige une compilation native et le vision projector, tandis que la variante Docker ne convient qu'au texte. Si le serveur manque de mémoire, il faut nettoyer le système à la main. NVIDIA ne fournit pas non plus de benchmarks de vitesse dans l'article et ne montre aucune vidéo illustrant la latence réelle : on reste donc loin d'un assistant prêt pour tous. Mais comme démonstration d'une direction, le cas est très convaincant.
Ce que cela signifie
Les agents IA locaux se rapprochent d'un usage concret sur du matériel bon marché. Pour les développeurs, cela ouvre la possibilité de construire des interfaces vocales privées et des prototypes multimodaux sans infrastructure cloud obligatoire. Pour le marché de l'edge AI, c'est un pas de plus des belles présentations vers des systèmes qu'on peut réellement monter sur un bureau, tester et intégrer dans un produit.
- 1 nov. 2026Les modèles locaux battus par Opus et Codex : 0,21 sur MacBook contre 1,00 pour Codex
- 1 nov. 2026Un auteur de Habr affine YOLOv8l sur des radiographies dentaires et atteint un mAP50 de 0,642
- 1 nov. 2026Les bots vocaux à base de LLM s'appuient sur le classifieur rapide Jev : une décision en 200–500 ms
- 1 nov. 2026La couche de protection MoneyGate n'a laissé passer aucune des 42 demandes frauduleuses adressées à des IA locales
Questions clés sur cet article
Comment fonctionne la chaîne?
Le scénario prend la forme d'un agent vocal simple, doté d'un unique outil visuel. L'utilisateur appuie sur la barre d'espace et pose sa question à voix haute ; Parakeet transcrit alors la parole en texte, en local. Gemma 4 reçoit ensuite la requête et décide seul s'il a besoin de regarder à travers la webcam. Si c'est le cas, le script capture une image et la transmet au modèle, puis Kokoro TTS vocalise la réponse. L'article insiste sur un point : le modèle ne décrit pas l'image de manière générale, il n'utilise ce qu'il voit que pour répondre à la question posée. « Franch
Que sait-on sur Ce qu'il faut pour la faire tourner ?
La démo n'a rien d'une magie prête à l'emploi : c'est plutôt un guide bien construit pour les passionnés et les développeurs qui veulent reproduire chez eux un pipeline multimodal local. NVIDIA ne se contente pas de décrire le lancement d'un script Python : elle détaille toute la stack, des paquets système et de la compilation de `llama.cpp` jusqu'à la configuration de l'audio et de la caméra, en passant par le téléchargement du vision projector pour Gemma 4. Un Jetson Orin Nano Super avec 8 Go de mémoire, une webcam, un micro USB ou une caméra à micro intégré, des haut-par
Pourquoi c'est intéressant?
La nouveauté ne tient pas au fait que Gemma 4 tourne sur un Jetson : c'était attendu pour des versions allégées. L'essentiel est ailleurs : NVIDIA propose un modèle pratique d'agent multimodal local qui combine STT, LLM, tool calling, vision et TTS sans recours obligatoire au cloud. Pour les appareils edge, le signal est fort. Jusqu'ici, ce type de scénario évoquait plutôt un serveur, ou bien des démos très bridées où le modèle se contente de répondre à du texte. Le guide expose d'ailleurs honnêtement ses limites. Le premier lancement est lent, car il faut télécharger les m
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
L'essentiel de l'IA — une fois par semaine
Sept actus qui ont vraiment compté, choisies à la main. Sans bruit ni communiqués.
C'est fait ! Vérifiez votre boîte mail pour la confirmation.