Hugging Face Blog
Source d'actualités IA. Les articles sont sélectionnés et adaptés par la rédaction de Hamidun News.
Dernières publications

Liquid AI lance LFM3 : six modèles multimodaux de 2B avec un contexte de 256K
LFM3-1.7B devance LFM2.5-2.6B avec 35% de paramètres en moins et tient dans 1 Go en 4 bits. Une seule base pour le texte, la vision, l'audio, l'omni et des modèles calibrés.

Black Forest Labs lance FLUX.3 Klein : une image 1024×1024 en 2 secondes sur H100
FLUX.3 Image Klein, de Black Forest Labs, est disponible dans Diffusers dès sa sortie : text-to-image, édition par références, mise en page par bounding box. Une image en 1,93 s.

Liquid AI lance LFM2.5-24B-A2B : un agent à 2B paramètres actifs
Liquid AI ouvre les poids d'un MoE de 24B paramètres dont seuls 2B sont actifs. Il génère 184 tok/s sur un portable M5 Max et plus de 21 000 tok/s sur une seule B300.

PyTorch 2.15 accélère les modèles MoE sur Mac de 5 à 6,5 fois et ajoute le FP8
L'équipe Hugging Face a réécrit les opérations MPS critiques en Metal : Qwen3.6-35B-A3B passe de 9,4 à 61,3 tokens/s sur M3 Ultra, et le pic mémoire de Wan2.2 chute de 270 à 8 GiB.

NVIDIA Kumo Relational surpasse le ML supervisé sur 41 tâches, sans entraînement
NVIDIA lance Kumo Relational : ce modèle préentraîné prédit attrition et demande directement sur la base relationnelle, en une passe, et devance AutoGluon de 8% de MRR sur SAP SALT.

Le suisse Apertus 1.5 gagne la vue, l'ouïe et un contexte de 262 000 tokens
Le projet Swiss AI publie Apertus 1.5 en 8B et 70B sous Apache 2.0 : multimodalité via le tokenizer, mode de réflexion, contexte quatre fois plus long et données entièrement ouvertes.

Microsoft et Hugging Face entraînent Qwen3.8-27B sur l'état de la base de données : de 38 à 107 tâches
Vérifier l'état final de la base sert de récompense à GRPO : en 50 pas, Qwen3.8-27B passe de 51,70% à 60,78% en pass@1 et triple presque ses tâches 20/20.

Dharma-AI réduit le vocabulaire de Qwen3-4B et abaisse de 77% le coût d'inférence
L'équipe brésilienne Dharma-AI a reconstruit le tokenizer de Qwen3-4B pour une seule tâche. La réponse du modèle passe de 350 à 101 tokens, et le score de qualité de 0,703 à 0,810.

Reflection lance Beam : un modèle MoE ouvert de 501B de paramètres sous licence Apache 2.0
Le nouveau labo américain Reflection ouvre Beam : 501B de paramètres, 23B actifs par token, contexte de 1M et licence Apache 2.0. Le modèle vise le code et les agents.

Meta ouvre Muse Spark Open : un MoE de 816 milliards de paramètres et un contexte de 1 million de tokens
Meta publie Muse Spark Open, un modèle open-weight de 816 Md de paramètres (42 Md actifs par token). Il accepte texte, images, audio et vidéo, et il est optimisé pour le codage agentique.

GPU au sol comme des avions : Hugging Face chiffre les pertes cachées des équipes d'IA
Hugging Face compare les GPU inactifs à des avions cloués au sol et montre comment une mauvaise gestion coûte aux équipes d'IA des centaines de milliers de dollars par an.

Nunchaku Lite : la génération d'images en 4 bits arrive dans Diffusers, jusqu'à 50 % de VRAM en moins
Hugging Face intègre l'inférence 4 bits de Nunchaku Lite directement dans Diffusers : jusqu'à 50 % de VRAM en moins et une génération d'images 30 % plus rapide, en une seule ligne de code.

NVIDIA ouvre les datasets Nemotron : 10 000 milliards de tokens pour entraîner des agents AI
NVIDIA a publié les datasets Nemotron avec plus de 10 000 milliards de tokens et 2,4 milliards de personas synthétiques pour entraîner des agents AI sur des scénarios réels et des défaillances d’outils.

Hugging Face : le backend transformers dans vLLM fonctionne désormais à vitesse native
Hugging Face a annoncé une parité de performances : le flag `--model-impl transformers` apporte la vitesse native de vLLM sur plus de 450 architectures sans réécriture du code.
SkyPilot et Hugging Face ont lancé un stockage sans frais de trafic sortant
L’intégration de SkyPilot et Hugging Face Storage permet d’entraîner des modèles sur n’importe quel cloud, en stockant poids et jeux de données à $12-18/TB/mois sans frais de trafic sortant.
Microsoft a lancé Foundry Managed Compute : des milliers de modèles Hugging Face d'un seul clic
Microsoft a combiné Azure Foundry avec le catalogue Hugging Face : des milliers de modèles ouverts se déploient maintenant dans le cloud d'un seul clic, avec la sécurité d'entreprise et la facturation unifiée.
LeRobot v0.6.0 de Hugging Face : les robots apprennent à prédire l'avenir et à s'évaluer eux-mêmes
Hugging Face a lancé LeRobot v0.6.0 avec des politiques world-model, des modèles de récompense pour l'auto-évaluation des tâches et six nouveaux benchmarks — complétant le cycle d'apprentissage complet des robots.
Hugging Face met à jour Kernels : éditeurs de confiance, signature de code et développement d'agents
Le 6 juillet 2026, Hugging Face a lancé une importante mise à jour de Kernels : les kernels sont devenus un type de référentiel distinct sur Hub, les éditeurs de confiance et la signature de code via Sigstore ont été ajo
Hugging Face et Cerebras lancent Gemma 4 pour l’AI vocale en temps réel
Hugging Face et Cerebras ont présenté un pipeline ouvert de parole à parole sur Gemma 4 avec des latences prévisibles — le système est déjà utilisé dans plus de 9 000 robots Reachy Mini.
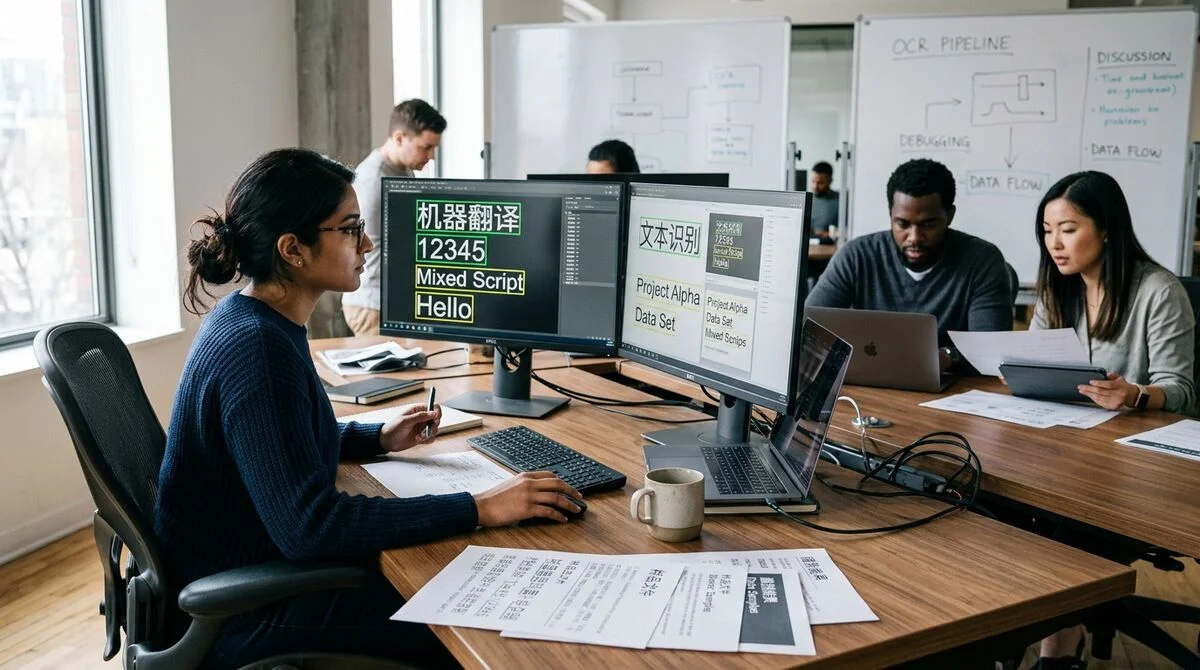
PaddleOCR lance PP-OCRv6 : reconnaissance de texte en 50 langues, de 1,5 à 34,5 millions de paramètres
PP-OCRv6 de Baidu PaddlePaddle : un OCR universel pour 50 langues en trois configurations de 1,5 à 34,5 millions de paramètres, avec un gain de précision de +4,6 à 5,1 points de pourcentage par rapport à la précédente ve
ServiceNow : un agent IA divulgue des secrets d'entreprise via une chaîne de requêtes de recherche
Des chercheurs de ServiceNow ont montré qu'un agent de deep-research révèle involontairement des secrets d'entreprise — chaque requête est anodine, mais l'ensemble de la chaîne forme une mosaïque.
Hugging Face compare toutes les alternatives à LoRA : qui l'emporte dans le fine-tuning des LLM
L'équipe de Hugging Face a testé cinq méthodes PEFT de fine-tuning des LLM — de DoRA à GaLore — et a découvert quand il est possible de surpasser LoRA, et à quel prix exactement.
Les modèles hybrides prédisent mieux les mots de contenu que les transformers — étude d'Allen AI
Allen AI a comparé les architectures OLMo 3 et OLMo Hybrid : les modèles hybrides prédisent plus précisément les noms, verbes et adjectifs, mais restent en retrait par rapport aux transformers sur les fragments de texte
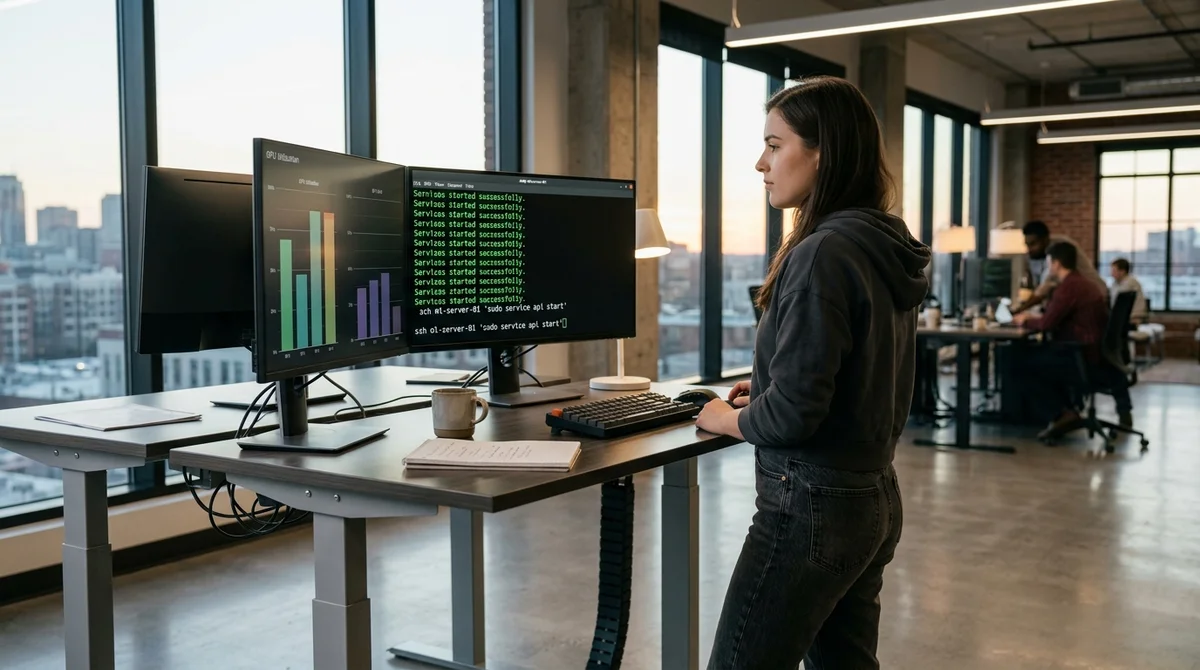
Hugging Face : lancer un serveur vLLM sur HF Jobs est désormais possible en une seule commande
Hugging Face a ajouté la prise en charge de vLLM à la plateforme HF Jobs : un serveur d’inférence prêt pour la production pour n’importe quel modèle du Hub peut désormais être déployé avec une seule commande CLI.
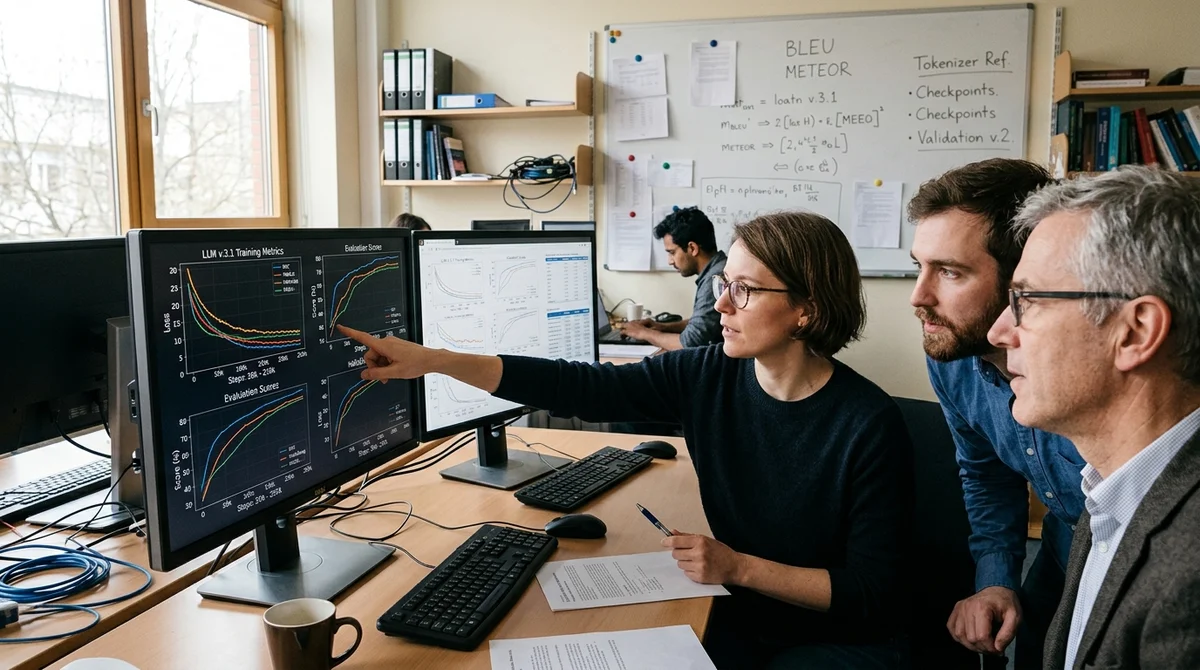
AllenAI Lance olmo-eval — Une Plateforme pour Évaluer des LLM Pendant l'Entraînement
AllenAI a lancé olmo-eval, une suite d'outils ouverte pour l'évaluation continue des modèles de langage pendant tout le cycle d'entraînement — point de contrôle après point de contrôle.
Cohere présente North Mini Code — un modèle pour les développeurs et les agents IA
Cohere a lancé North Mini Code — un modèle de 30 milliards de paramètres entraîné sur la programmation et l'interaction avec les agents IA. Le modèle est gratuit et accessible à tous.
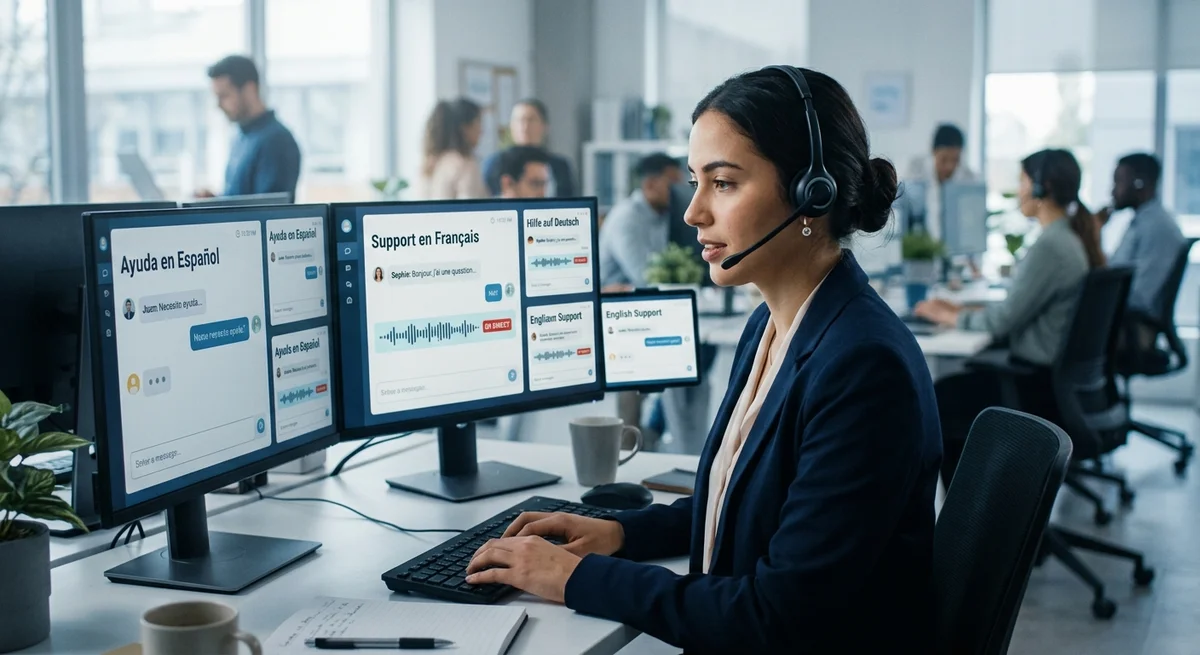
Les agents vocaux ne sont pas prêts pour les clients bilingues. Recherche ServiceNow-AI
Les agents vocaux fonctionnent mal avec les clients bilingues. Cela a été démontré par une recherche de l'équipe ServiceNow-AI, qui a testé sept systèmes populaires de reconnaissance vocale sur des…
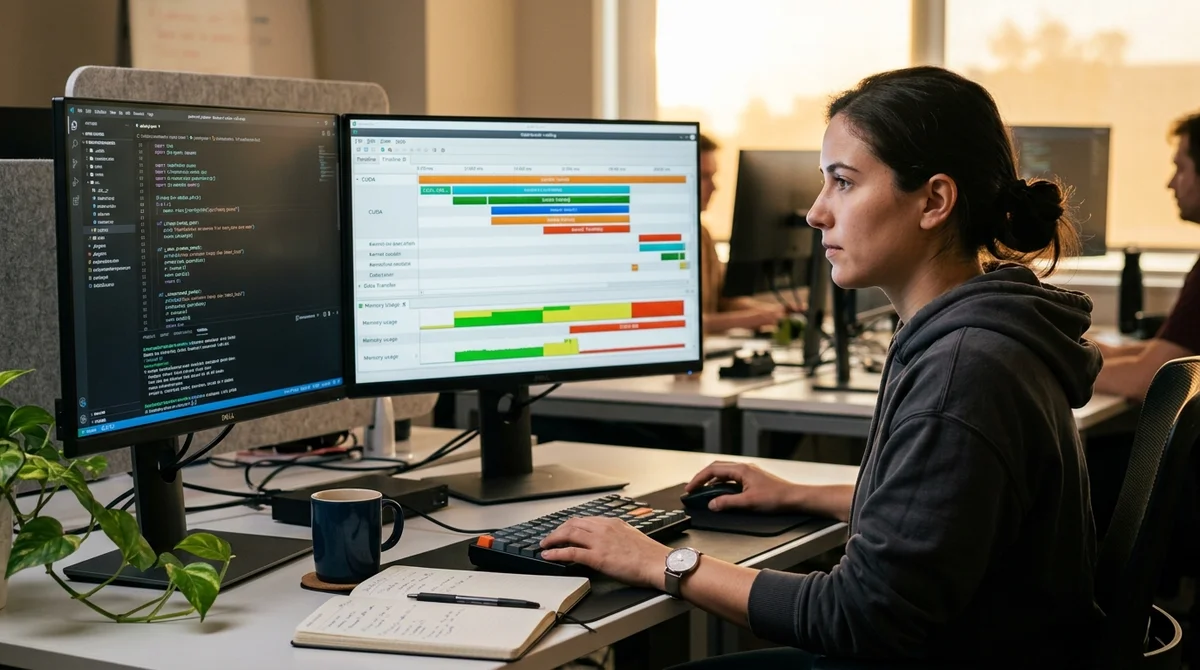
Comment accélérer les modèles PyTorch : guide pratique torch.profiler
Hugging Face présente torch.profiler, un outil intégré de PyTorch pour l'analyse de performance. Il aide à identifier les goulots d'étranglement dans l'entraînement et l'inférence des modèles.
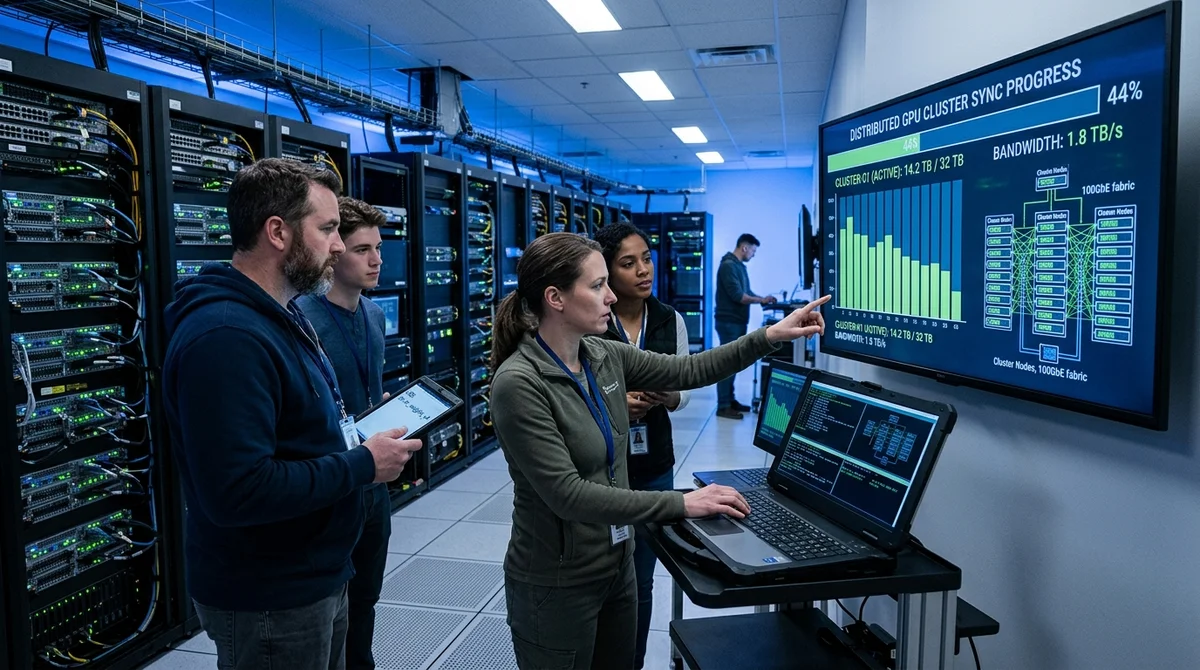
Hugging Face apprend à TRL à livrer un trillion de paramètres via poids delta
Hugging Face a ajouté Delta Weight Sync à TRL — une technique qui envoie uniquement les modifications de poids au lieu de fichiers complets, réduisant le volume de données de centaines de fois lors de l'entraînement de m
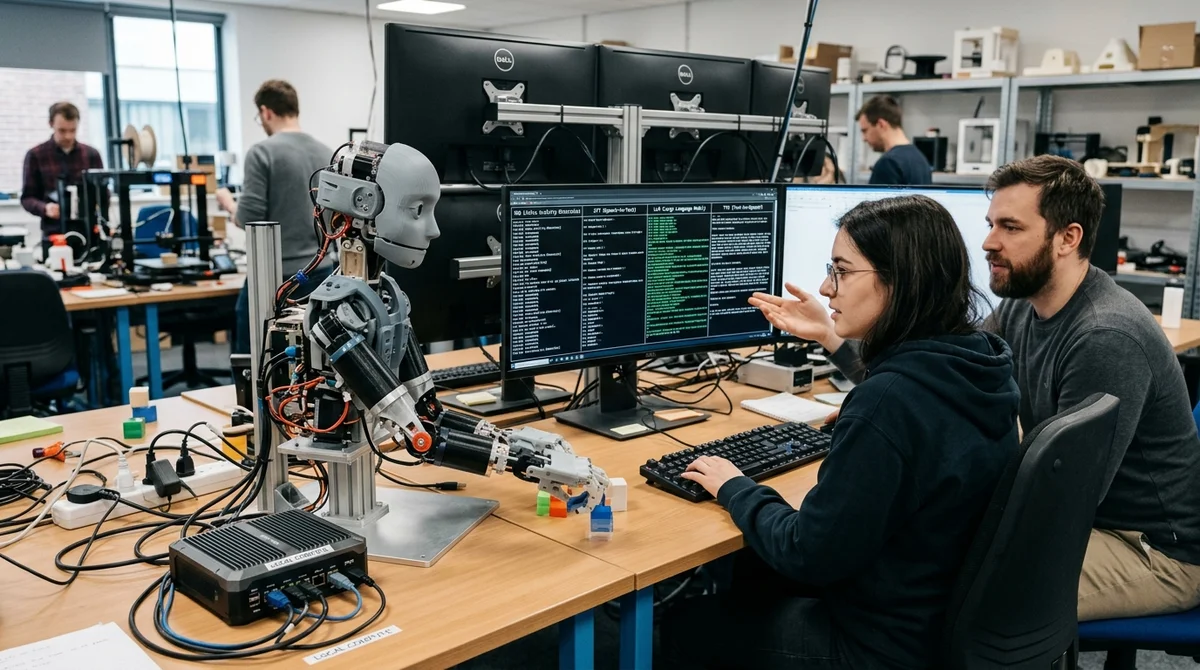
Reachy Mini a appris à converser localement sans cloud
Le robot humanoïde Reachy Mini peut désormais exécuter toute la pile de reconnaissance vocale localement, sans cloud ni API, grâce aux modèles ouverts de Hugging Face.