Google DeepMind dévoile Gemini Robotics-ER 1.6 pour l'autonomie des robots et la lecture d'instruments
Google DeepMind a mis à jour Gemini Robotics-ER en version 1.6, une couche cognitive pour robots qui comprend mieux l'espace, détermine si une tâche est terminée et sait lire des instruments industriels complexes. Lors des tests de lecture d'instruments, le modèle a obtenu 86 % sans agentic vision et 93 % avec. Il est déjà disponible via l'API Gemini et Google AI Studio.
Traité par IA depuis MarkTechPost ; édité par Hamidun News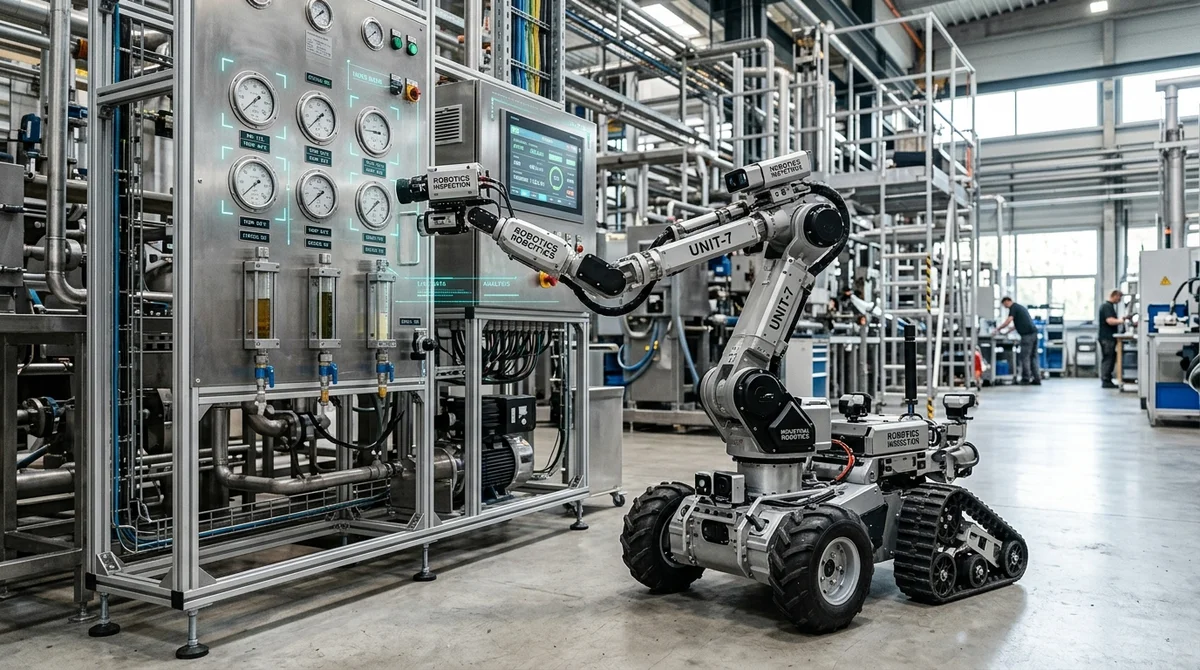
Le 14 avril 2026, Google DeepMind a présenté Gemini Robotics-ER 1.6, une mise à jour de son modèle de raisonnement qui fait office de couche cognitive supérieure pour les robots dans le monde physique. L'enjeu de la version 1.6 n'est pas d'ajouter un énième VLA, mais de donner au robot un raisonnement spatial plus précis : le modèle comprend mieux la scène, compte les objets, détermine si une tâche est accomplie et, pour la première fois, lit de façon fiable des instruments complexes comme des manomètres, des jauges de niveau et des écrans numériques.
DeepMind présente Gemini Robotics-ER comme un modèle reasoning-first pour l'IA incarnée (embodied AI). Il vise les cas où il ne suffit pas au robot de reconnaître un objet : il doit comprendre les relations entre les éléments, choisir un point de saisie, vérifier les contraintes et décider de la suite. La version 1.6 renforce nettement le pointing, c'est-à-dire la capacité à désigner des objets et à utiliser ces points comme étape intermédiaire du raisonnement. Cela aide à compter les objets plus précisément, comparer des tailles, construire des trajectoires et exécuter des instructions à conditions spatiales.
Le modèle gagne aussi en multi-view understanding : il assemble mieux une vue unique à partir de plusieurs caméras, par exemple une caméra zénithale et une autre montée sur le manipulateur. Pour les développeurs, Gemini Robotics-ER 1.6 est déjà disponible via l'API Gemini et Google AI Studio, avec des exemples Colab pour la configuration et le prompt engineering.
La nouvelle compétence la plus marquante est la lecture d'instruments, issue d'une collaboration avec Boston Dynamics. Dans les sites industriels, les robots croisent régulièrement des thermomètres, des manomètres circulaires, des hublots de contrôle et des indicateurs de niveau verticaux, où il ne s'agit pas seulement de classer une image, mais d'en extraire la valeur avec exactitude. Pour cela, Gemini Robotics-ER 1.6 recourt à l'agentic vision, qui associe raisonnement visuel et exécution de code. Le modèle zoome d'abord sur la zone utile, marque ensuite les points clés, estime les intervalles et les proportions, puis confronte le tout à l'échelle, aux unités de mesure et au contexte.
Selon Google DeepMind, sur la tâche de lecture d'instruments, la version 1.5 atteignait 23 %, Gemini 3.0 Flash 67 %, Robotics-ER 1.6 elle-même 86 %, et 93 % avec l'agentic vision. Il ne s'agit plus de montrer qu'un robot « voit » un instrument, mais de franchir une étape vers un scénario où il fait lui-même sa ronde, relève les valeurs et comprend ce qu'elles signifient.
Un autre volet important concerne la détection de réussite et la sécurité. Pour un robot autonome, savoir lancer une tâche ne suffit pas ; il doit déterminer quand elle est réellement achevée et quand il faut retenter. DeepMind affirme que le modèle gère mieux la détection de réussite, même dans des scènes dynamiques, avec des occultations partielles et des angles de vue ambigus.
Le respect des contraintes physiques s'est lui aussi amélioré : le système doit par exemple mieux tenir compte d'interdictions comme « ne pas prendre de liquides » ou « ne pas soulever d'objets de plus de 20 kg ». Dans les tests de reconnaissance de situations dangereuses à partir de texte et de vidéo, la famille Gemini Robotics-ER a amélioré le résultat de Gemini 3.0 Flash de 6 % et de 10 % respectivement.
Google précise par ailleurs une limite : le modèle n'est pas conçu pour des usages critiques en matière de sécurité, comme la médecine, les transports et d'autres environnements où une erreur peut causer des blessures ou des dommages.
La portée pratique de cette sortie tient à ce que Google transforme peu à peu le raisonnement incarné, sujet de recherche, en couche d'infrastructure pour la robotique. Gemini Robotics-ER 1.6 ne pilote pas directement le matériel, mais offre aux robots un niveau de raisonnement supérieur plus solide, qui peut être relié à des modèles VLA, à la recherche et à des fonctions externes.
Pour le secteur, c'est aussi le signe que l'interface entre modèles de langage et robots se rapproche d'un usage commercial. Si cette combinaison fait ses preuves hors du laboratoire, le marché disposera de robots qui ne se contentent pas de suivre un scénario, mais interprètent leur environnement, vérifient le résultat et lisent de vrais instruments sans humain dans la boucle.
- 2 nov. 2026Le créateur de Bun migre 750 000 lignes de Zig vers Rust en 11 jours avec Claude Code
- 2 nov. 2026Un journaliste de The Verge assemble un équivalent du Meta Muse Charm à $50 avec Claude Code
- 1 nov. 2026Test de 16 modèles sur 7 moteurs de recherche : Exa obtient en moyenne 10,5 points sur 14, SearXNG environ 3
- 1 nov. 2026L'agent vidéo StreamVibe de Google devance les autres modèles de 10,7 % sur le timing et la qualité des réponses
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
L'essentiel de l'IA — une fois par semaine
Sept actus qui ont vraiment compté, choisies à la main. Sans bruit ni communiqués.
C'est fait ! Vérifiez votre boîte mail pour la confirmation.