Google DeepMind dévoile Gemini Robotics-ER 1.6 pour des tâches autonomes dans le monde réel
Google DeepMind a mis à jour Gemini Robotics-ER en version 1.6 en misant sur des scénarios réels : de la reconnaissance d'objets et de la vérification des tâches à la lecture de capteurs et de manomètres. Le modèle exploite mieux plusieurs caméras, compte et localise les objets plus précisément et prend en charge l'appel d'outils externes. Il est déjà disponible via l'API Gemini et Google AI Studio.
Traité par IA depuis DeepMind Blog ; édité par Hamidun News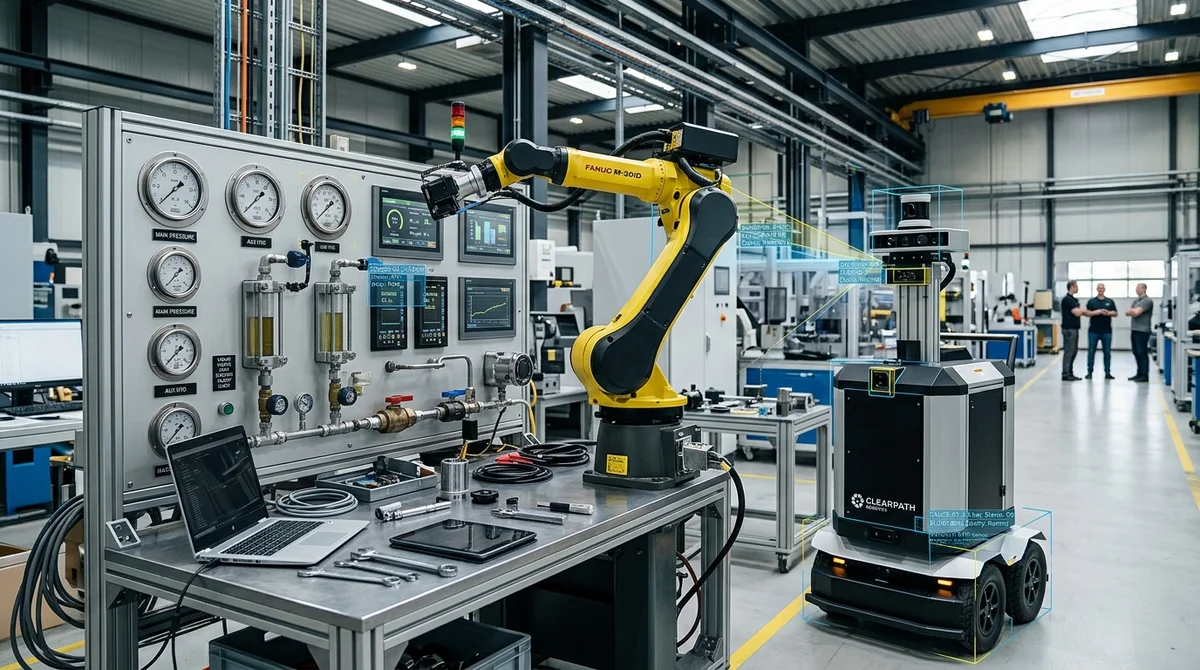
Le 14 avril 2026, Google DeepMind a présenté Gemini Robotics-ER 1.6, un modèle de raisonnement mis à jour pour les robots, conçu non pas simplement pour exécuter des ordres, mais pour comprendre l'environnement physique. L'entreprise mise sur l'embodied reasoning, c'est-à-dire la capacité d'un système à relier perception visuelle, contexte de la tâche et action réelle.
La nouvelle version met l'accent sur un raisonnement spatial plus précis, la compréhension d'une scène à partir de plusieurs caméras, la détection de la réussite d'une tâche et la lecture d'instruments industriels. En somme, il s'agit d'un « cerveau » de haut niveau pour le robot, capable d'appeler des outils externes, des modèles VLA et des fonctions personnalisées pour exécuter des scénarios complexes dans le monde réel.
L'une des principales améliorations concerne les tâches spatiales. DeepMind explique que, pour un robot, une opération de base comme pointer un objet n'est pas un détail, mais le fondement de comportements plus complexes. Grâce aux points, le modèle peut non seulement trouver des objets, mais aussi les compter, comparer leurs tailles, établir des relations entre eux, choisir les meilleurs points de préhension et vérifier les contraintes énoncées dans le prompt.
Par exemple, si le système doit montrer tous les objets qui tiennent dans une tasse bleue, il doit reconnaître simultanément la forme, la taille et la position relative des éléments. Lors des démonstrations, Gemini Robotics-ER 1.6 a compté plus précisément les outils dans l'image, n'a pas pointé d'objets absents et s'est globalement nettement mieux comporté sur ces tâches que Gemini Robotics-ER 1.
5 et Gemini 3.0 Flash.
Deuxième volet important : la compréhension de la scène sous plusieurs angles et la « success detection », c'est-à-dire la capacité de déterminer si une tâche est réellement terminée. Pour la robotique autonome, c'est crucial : il ne suffit pas au robot de lancer une action, il doit décider s'il faut réessayer ou s'il peut passer à l'étape suivante du plan. Dans les installations réelles, c'est particulièrement difficile, car les caméras observent souvent la scène à la fois d'en haut et depuis le manipulateur, certains objets peuvent être masqués, et l'éclairage comme l'arrière-plan changent.
Gemini Robotics-ER 1.6 met mieux en correspondance plusieurs flux vidéo et en tire une image cohérente. À titre d'exemple, DeepMind présente un scénario où le système détermine, à partir de plusieurs vues, si la tâche « mettre le stylo bleu dans le porte-stylo noir » est terminée.
La nouveauté la plus concrète est la lecture d'instruments. DeepMind a développé cette capacité avec Boston Dynamics, en s'appuyant sur des tâches d'inspection de sites industriels. Dans les usines et les locaux techniques, un robot doit vérifier régulièrement des thermomètres, des manomètres, des indicateurs de niveau chimiques, des voyants de contrôle en verre et des écrans numériques. Reconnaître l'image ne suffit pas : le système doit comprendre la position de l'aiguille, le niveau du liquide, les limites de l'échelle, les graduations et les étiquettes d'unités de mesure, et parfois même combiner les lectures de plusieurs aiguilles correspondant à des chiffres différents. Pour un voyant en verre, il faut aussi tenir compte des distorsions dues à l'angle de la caméra.
Selon DeepMind, la précision de lecture des instruments est passée de 23 % pour Gemini Robotics-ER 1.5 et 67 % pour Gemini 3.0 Flash à 86 % pour Gemini Robotics-ER 1.6. Avec le mode agentic vision activé, ce chiffre atteint 93 % : le modèle commence par zoomer sur la zone utile, puis pointe des points clés et exécute du code pour estimer proportions et intervalles, avant d'interpréter la valeur finale.
DeepMind insiste également sur la sécurité. L'entreprise présente Gemini Robotics-ER 1.6 comme son modèle de robotique le plus sûr à ce jour. Il respecte mieux les politiques de Gemini dans des tâches spatiales adverses et s'en tient nettement plus précisément aux contraintes physiques, par exemple lorsque le système ne doit pas manipuler de liquides ni soulever d'objets de plus de 20 kilogrammes. En outre, sur des scénarios fondés sur de vrais rapports de blessures, Robotics-ER devance Gemini 3.0 Flash : 6 points de pourcentage de plus sur les tâches textuelles et 10 points de plus sur les tâches vidéo liées à la reconnaissance des risques.
Le modèle est déjà accessible aux développeurs via l'API Gemini et Google AI Studio. Avec cette sortie, DeepMind a publié un exemple Colab et invité ses partenaires à envoyer des images annotées d'erreurs typiques afin d'améliorer les prochaines versions.
Cette mise à jour montre où se déplace la concurrence en robotique : la mécanique pèse de moins en moins, et la couche de raisonnement qui la pilote de plus en plus. Si un modèle sait observer une scène sous plusieurs angles, utiliser des outils, lire des instruments, vérifier le résultat et tenir compte des contraintes de sécurité, le robot cesse d'être un simple exécutant pour devenir un système capable de s'adapter à la situation. Pour les inspections industrielles, les entrepôts et les services, c'est l'un des signaux les plus concrets que les grands modèles d'IA se rapprochent d'une réelle autonomie hors du laboratoire.
- 1 nov. 2026Test de 16 modèles sur 7 moteurs de recherche : Exa obtient en moyenne 10,5 points sur 14, SearXNG environ 3
- 1 nov. 2026L'agent vidéo StreamVibe de Google devance les autres modèles de 10,7 % sur le timing et la qualité des réponses
- 1 nov. 2026OpenAI réécrit les règles de comportement de GPT : cinq valeurs et une chaîne de priorités
- 1 nov. 2026Les bots vocaux à base de LLM s'appuient sur le classifieur rapide Jev : une décision en 200–500 ms
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
L'essentiel de l'IA — une fois par semaine
Sept actus qui ont vraiment compté, choisies à la main. Sans bruit ni communiqués.
C'est fait ! Vérifiez votre boîte mail pour la confirmation.