Wildberries & Russ décrit le niveau de maturité des données requis pour des agents IA fiables
Wildberries & Russ propose un modèle de maturité de la documentation des données, de Rare à Well-Done, et montre pourquoi les agents IA se mettent à halluciner, même sur des tâches SQL simples, quand les métadonnées sont médiocres. Au niveau de base, il faut un responsable, un modèle physique et des étiquettes de confidentialité. Au niveau intermédiaire, un glossaire et une couche logique. Au niveau cible, une couche sémantique complète pour le text-to-SQL et des métriques métier précises.
Traité par IA depuis Habr AI ; édité par Hamidun News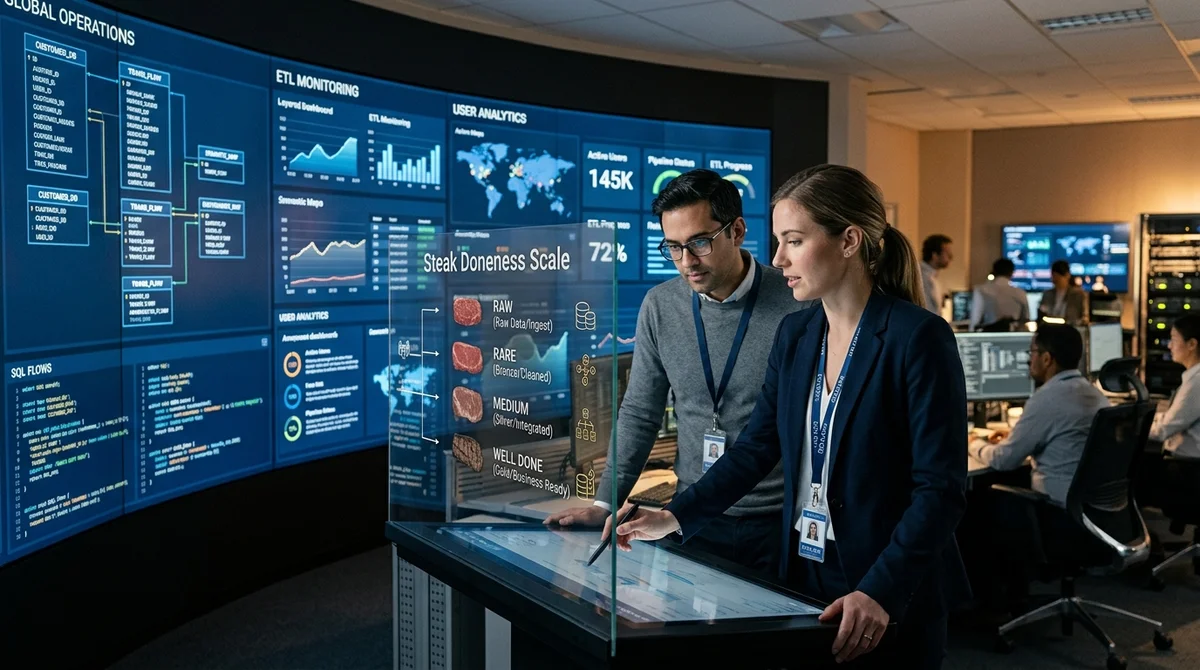
Wildberries & Russ propose d'évaluer la qualité de la documentation des données avec le même pragmatisme que la cuisson d'un steak : de Rare à Well-Done. L'idée est simple : mieux une entreprise décrit ses tables, ses champs, ses termes métier et ses métriques, moins ses agents IA hallucinent et plus ils s'approchent d'analyses métier réelles, plutôt que de réponses plausibles mais inutiles.
La société estime que le principal problème du big data aujourd'hui n'est pas le manque de modèles, mais le suivi insuffisant des données elles-mêmes. Dans une grande organisation, de nouvelles tables apparaissent plus vite que les équipes ne peuvent les documenter à la main. Résultat : les analystes perdent du temps à chercher les bonnes sources, les indicateurs divergent d'un rapport à l'autre et l'accès à des jeux de données non étiquetés devient un risque de sécurité. C'est particulièrement aigu là où existent des données personnelles et des exigences strictes de contrôle d'accès. Dans un tel environnement, l'approche manuelle cesse tout simplement de passer à l'échelle.
Le premier niveau de maturité, Rare, est jugé le minimum suffisant pour travailler en sécurité avec les données. À ce stade, chaque jeu de données doit avoir un responsable, un modèle physique et un étiquetage de confidentialité. Le modèle physique peut être extrait automatiquement des tables système et des catalogues de données, et si les descriptions des champs sont vides, l'IA peut tenter de les reconstituer à partir des conventions de nommage et des bases de connaissances de l'entreprise.
Pour les responsables, l'automatisation fonctionne moins bien : le modèle peut proposer un candidat, mais la responsabilité reste attribuée manuellement. En revanche, l'étiquetage des données sensibles ressemble à l'une des premières tâches concrètes pour les LLM : le modèle peut analyser les noms de tables, de colonnes et de termes métier et attribuer des étiquettes de sécurité avant même une analyse approfondie du contenu.
Au niveau Medium, l'accent passe de la structure technique au sens métier. Apparaissent ici un glossaire et une couche logique qui traduit le langage des tables et des colonnes en entités et attributs compréhensibles par le métier. Cette couche masque les préfixes de service, les jointures complexes et les détails de stockage, et les data stewards peuvent utiliser l'IA comme copilote pour rattacher les champs à des termes existants et repérer les lacunes dans les descriptions.
Si un agent est connecté au catalogue de métadonnées via MCP, il peut récupérer à la demande les schémas nécessaires, les rapprocher du glossaire et accélérer un travail qui prenait auparavant des heures. Wildberries & Russ propose en outre d'extraire les relations non seulement de la structure de l'entrepôt, mais aussi des logs de requêtes SQL : ils révèlent quelles tables les analystes joignent le plus souvent, quels filtres ils utilisent et comment les données sont réellement consommées.
Le niveau le plus élevé, Well-Done, ne sert plus seulement à naviguer dans les données, mais à faire fonctionner réellement le text-to-SQL et les systèmes agentiques. Une couche sémantique est construite par-dessus la description physique et logique : faits, métriques, dimensions, relations, filtres et requêtes vérifiées en langage naturel avec leurs réponses SQL prêtes. C'est cette couche qui explique au modèle ce que l'entreprise entend par « client actif », « chiffre d'affaires brut » ou toute autre métrique, au lieu de le forcer à deviner le sens d'après le nom des champs.
L'article donne un exemple parlant. Si l'on demande à une IA combien il y avait de clients actifs en mars, un modèle sans sémantique peut se contenter de compter les lignes au statut active, alors que, selon les règles de l'entreprise, un client actif est un client ayant passé au moins une commande supérieure à un seuil donné. Selon l'auteur, c'est là que les standards ouverts comme OSI deviennent critiques, car ils permettent de décrire le sens des données dans un format portable, compatible avec les outils modernes de couche sémantique.
L'effet pratique est aussi signalé : dans les documents de Snowflake pour Cortex Analyst, on mentionne un gain de précision d'environ 20 pour cent avec une sémantique correctement décrite, et l'objectif pour les scénarios réels est de dépasser 90 pour cent de précision SQL.
Ce que cela signifie concrètement : le marché s'éloigne peu à peu de l'idée qu'il suffit de brancher un LLM à une base de données et d'attendre que la magie opère. L'approche de Wildberries & Russ dessine une trajectoire plus sobre : d'abord mettre de l'ordre dans les responsables, la structure et la classification des données, puis constituer un dictionnaire logique, et seulement ensuite bâtir la couche sémantique pour les agents. Pour les entreprises qui veulent introduire des assistants IA dans l'analytique, c'est une vérité désagréable mais utile : la qualité de la réponse du modèle dépend désormais non seulement du modèle lui-même, mais aussi de la maturité de la documentation des données au sein de l'entreprise.
- 2 nov. 2026DeepSeek ouvre le code d'un prototype de Super-agent : p95 du temps d'exécution de 15,7 min contre 29,5
- 2 nov. 2026Le créateur de Bun migre 750 000 lignes de Zig vers Rust en 11 jours avec Claude Code
- 2 nov. 2026Microsoft publie Mage-VL-Cowork, un modèle de 4B qui résout 66,0% des tâches d'OSWorld-Verified
- 2 nov. 2026L'assistant Muse de Meta tient un dossier sur vos proches et obtient root par défaut sous Ubuntu
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
L'essentiel de l'IA — une fois par semaine
Sept actus qui ont vraiment compté, choisies à la main. Sans bruit ni communiqués.
C'est fait ! Vérifiez votre boîte mail pour la confirmation.