Comment Hugging Face construit des applications web évolutives avec le Privacy Filter d'OpenAI
Hugging Face a détaillé comment transformer OpenAI Privacy Filter en véritables produits web, et pas seulement en modèle d'édition de texte. L'exemple compte trois applications : un lecteur de PDF et DOCX qui surligne les PII, un anonymiseur de captures d'écran fondé sur l'OCR et un pastebin qui publie une version déjà masquée du texte et n'ouvre l'original que via un lien privé. L'idée commune : détecter et masquer les données personnelles en local, puis seulement transmettre le texte, le document ou la capture au reste de la chaîne d'IA.
Traité par IA depuis Hugging Face Blog ; édité par Hamidun News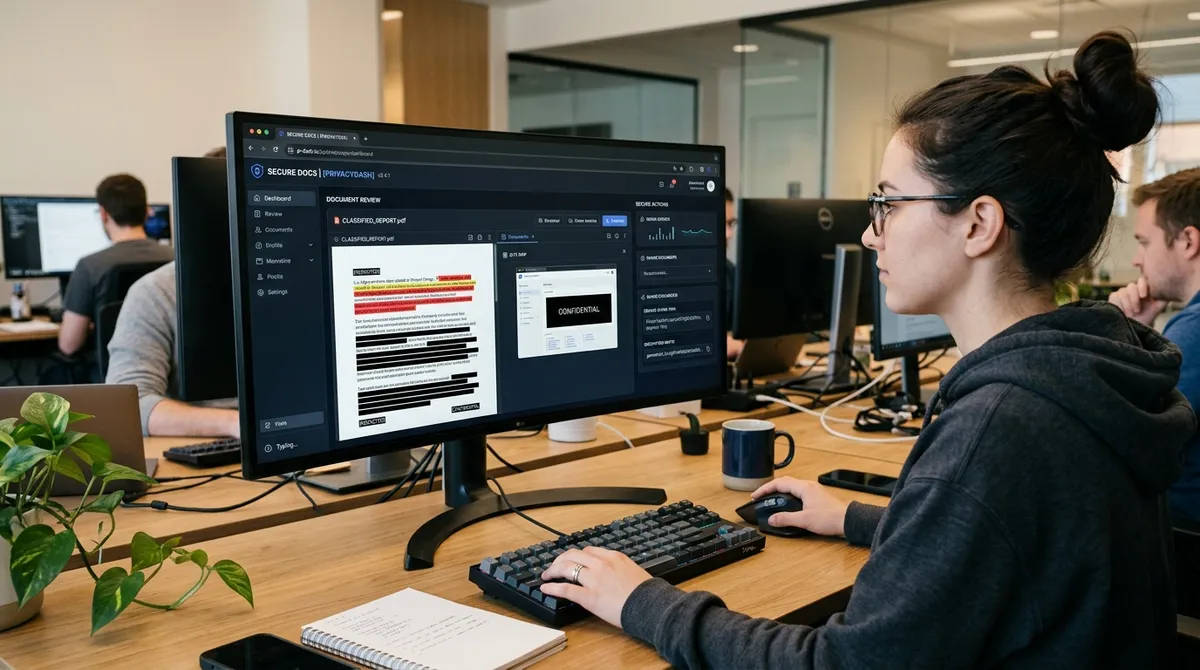
Quelques jours après la sortie du modèle Privacy Filter par OpenAI, l'équipe de Hugging Face a montré non pas une présentation abstraite, mais trois scénarios fonctionnels où l'outil devient une application web à part entière. L'idée est simple : d'abord repérer et masquer les données personnelles en local, puis seulement transmettre le texte, le document ou la capture d'écran au reste de la chaîne d'IA. Pour les équipes qui conçoivent des interfaces autour de données sensibles, c'est plus important qu'une énième démo de chatbot, car la question n'est pas seulement la qualité du modèle, mais aussi la façon de l'intégrer à un produit réel sans infrastructure superflue.
OpenAI a publié Privacy Filter le 22 avril 2026. Il s'agit d'un modèle à poids ouverts pour détecter et éditer les PII dans du texte, sous licence Apache 2.0 : on peut donc l'exécuter dans son propre environnement, le réentraîner pour ses cas d'usage et l'employer dans des produits commerciaux.
Le modèle compte 1,5 milliard de paramètres, mais environ 50 millions seulement restent actifs, et son contexte atteint 128 000 tokens. Il annote le texte en une seule passe et recherche huit types d'entités sensibles : noms de particuliers, adresses, e-mails, numéros de téléphone, URL, dates, numéros de compte et divers secrets, comme les mots de passe ou les clés d'API. Selon OpenAI, le modèle obtient un F1 de 96 % sur le benchmark PII-Masking-300k, et de 97,43 % sur la version corrigée du jeu de données.
Détail important : ce n'est pas un générateur de texte, mais un classifieur de tokens spécialisé, adapté aux tâches rapides de confidentialité dans les logs, les documents, les index et les chaînes d'annotation.
Le premier exemple de Hugging Face est Document Privacy Explorer. L'utilisateur envoie un PDF ou un DOCX et récupère le document avec les fragments de PII surlignés, un filtre par catégorie et des statistiques récapitulatives en haut. Grâce au long contexte, le modèle peut traiter un gros document d'un bloc, sans le découper en morceaux ni recoller les résultats, de sorte que les décalages de caractères correspondent à ce que l'utilisateur voit dans l'interface.
L'équipe souligne qu'il était plus simple d'écrire cette interface de lecture à la main en HTML et JavaScript que de l'assembler à partir de blocs d'interface prêts à l'emploi. Côté serveur, tout reste compact : un seul endpoint via gradio.Server reçoit le fichier, en extrait le texte, le passe dans Privacy Filter et renvoie le texte, les segments détectés et les statistiques.
Le deuxième scénario est Image Anonymizer, pour les captures d'écran et les images. La chaîne est un peu plus complexe : l'OCR Tesseract récupère d'abord le texte et les coordonnées des mots, Privacy Filter repère ensuite les fragments sensibles, puis le backend convertit les segments détectés en rectangles sur l'image. L'utilisateur n'obtient pas qu'une capture caviardée, mais un canvas interactif : les bandeaux noirs peuvent être activés ou désactivés par catégorie, déplacés, dessinés à la main et exportés en PNG final sans renvoyer les modifications au serveur. Pour les usages privés, l'argument est de poids : tout le post-traitement reste dans le navigateur, et le modèle n'intervient que pour la détection initiale.
Le troisième exemple est SmartRedact Paste, en substance un pastebin pour texte sensible. L'utilisateur colle un log, un e-mail ou un ticket et reçoit deux liens : une version publique avec des masques comme PRIVATE_EMAIL et PRIVATE_PERSON, et un lien privé à jeton où l'on voit l'original avec les fragments détectés surlignés. Cet exemple illustre bien pourquoi Hugging Face utilise précisément gradio.
Server. Tout ce qui touche au modèle passe par la file @server.api, tandis que les pages ordinaires et l'affichage des pastes sont servis par de simples routes FastAPI dans le même processus.
Le service peut ainsi faire cohabiter des URL personnalisées, un contrôle par jeton pour la consultation privée et une même fonction de détection accessible depuis le navigateur comme depuis un client Python. L'article précise que l'ensemble du service, stockage compris, tient en environ 200 lignes de code applicatif.
Le principal enseignement de ces exemples n'est pas que Gradio sait produire de jolies démos, mais que l'infrastructure de confidentialité commence à ressembler à une couche produit ordinaire. Hugging Face propose une règle d'architecture simple : envoyer les opérations lourdes du modèle vers les files de gradio.Server, et laisser tout le reste, c'est-à-dire les pages, la livraison de fichiers, les lectures peu coûteuses et les vérifications de jeton, sur des routes FastAPI classiques. Cette répartition passe à l'échelle sans dupliquer le code backend et permet de concevoir ses propres interfaces plutôt que des formulaires génériques. Pour le marché, c'est le signe que le filtrage local des données personnelles cesse d'être réservé aux grandes équipes d'entreprise.
Dans le même temps, OpenAI avertit explicitement que Privacy Filter n'est ni un certificat de conformité ni un substitut à la revue des politiques. Dans les contextes juridiques, médicaux et financiers, il faut toujours une vérification humaine, une évaluation sur des données du domaine et un réglage soigneux des seuils. Mais comme brique de base pour des applications d'IA sûres, c'est déjà un outil très pratique.
- 1 nov. 2026Les modèles locaux battus par Opus et Codex : 0,21 sur MacBook contre 1,00 pour Codex
- 1 nov. 2026Kimi obtient 96,2 % à un test d'analytique sur une base 1C et s'impose comme solution de repli en cas de blocage de Claude
- 1 nov. 2026OpenAI réécrit les règles de comportement de GPT : cinq valeurs et une chaîne de priorités
- 1 nov. 2026Google reconnaît que l'AI Mode réduit les revenus de la recherche, l'action chute de 15%
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
L'essentiel de l'IA — une fois par semaine
Sept actus qui ont vraiment compté, choisies à la main. Sans bruit ni communiqués.
C'est fait ! Vérifiez votre boîte mail pour la confirmation.